随机森林

上文已经介绍了集成学习,也初步讲明了Bagging的原理,本文将从数学原理上介绍Bagging与随机森林,然后以一个手写数字识别的小例子来演示随机森林算法。

本文基于机器学习之随机森林算法 (educoder.net)来介绍Bagging和随机森林。

1. Bagging

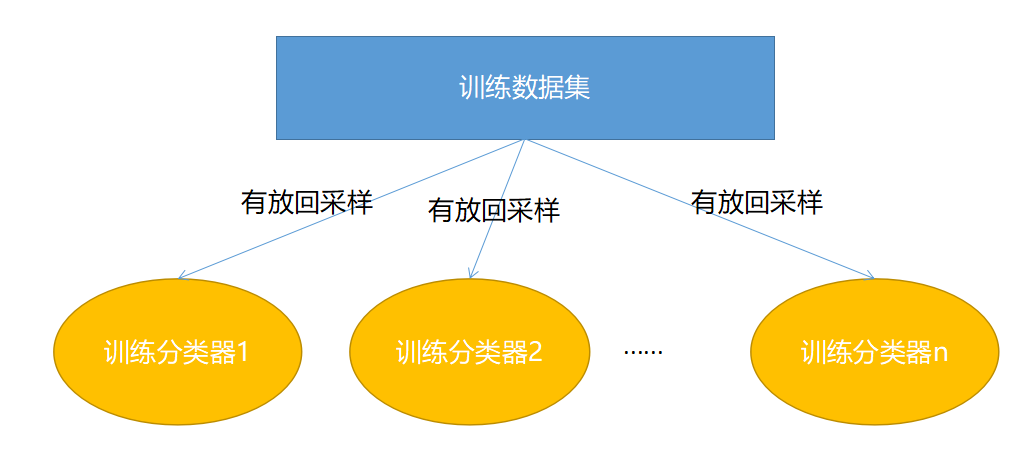
Bagging在训练时的特点就是随机有放回采样和并行。

  • 随机有放回采样:假设训练数据集有 m 条样本数据,每次从这 m 条数据中随机取一条数据放入采样集,然后将其返回,让下一次采样有机会仍然能被采样。然后重复 m 次,就能得到拥有 m 条数据的采样集,该采样集作为 Bagging 的众多分类器中的一个作为训练数据集。假设有 T 个分类器(随便什么分类器),那么就重复 T 此随机有放回采样,构建出 T 个采样集分别作为 T 个分类器的训练数据集。
  • 并行:假设有 10 个分类器,在 Boosting 中,1 号分类器训练完成之后才能开始 2 号分类器的训练,而在 Bagging 中,分类器可以同时进行训练,当所有分类器训练完成之后,整个 Bagging 的训练过程就结束了。

Bagging 训练过程如下图所示:
预览大图

预测

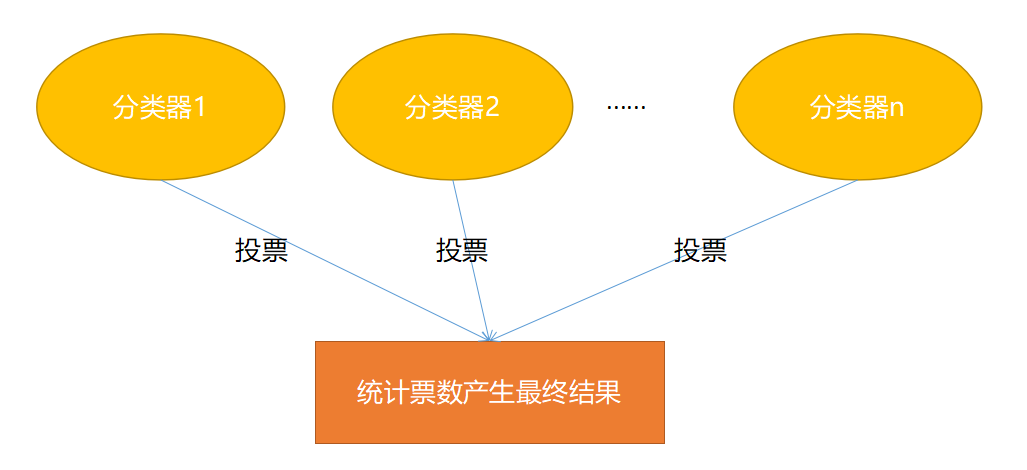
Bagging 在预测时非常简单,就是投票!比如现在有 5 个分类器,有 3 个分类器认为当前样本属于 A 类,1 个分类器认为属于 B 类,1 个分类器认为属于 C 类,那么 Bagging 的结果会是 A 类(因为 A 类的票数最高)。

Bagging 预测过程如下图所示:
预览大图

编程要求

在 begin-end 中完成 BaggingClassifier 类中的 fit 和 predict 函数。分类器可使用 sklearn 提供的 DecisionTreeClassifier。要求模型保存在 self.models 中。

fit 函数用于 Bagging 的训练过程,其中:

  • feature :训练集数据,类型为 ndarray;
  • label :训练集标签,类型为 ndarray。

predict 函数,实现预测功能,并将标签返回,其中:

  • feature :测试集数据,类型为 ndarray 。(PS:feature中有多条数据)

全部代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
import numpy as np
from collections import Counter
from sklearn.tree import DecisionTreeClassifier

class BaggingClassifier():
def __init__(self, n_model=10):
'''
初始化函数
'''
# 分类器的数量,默认为10
self.n_model = n_model
# 用于保存模型的列表,训练好分类器后将对象append进去即可
self.models = []

def fit(self, feature, label):
'''
训练模型
:param feature: 训练数据集所有特征组成的ndarray
:param label:训练数据集中所有标签组成的ndarray
:return: None
'''
# 对于每一个模型
for i in range(self.n_model):
# 获取特征数量
m = len(feature)
# 生成随机索引,用于自助采样(bootstrap sampling)
index = np.random.choice(m, m)
# 根据随机索引生成训练数据集和标签
sample_data = feature[index]
sample_lable = label[index]
# 创建并训练决策树分类器
model = DecisionTreeClassifier()
model = model.fit(sample_data, sample_lable)
# 将训练好的分类器添加到模型列表中
self.models.append(model)

def predict(self, feature):
'''
:param feature:训练数据集所有特征组成的ndarray
:return:预测结果,如np.array([0, 1, 2, 2, 1, 0])
'''
# 创建一个空列表用于保存每个模型的预测结果
result = []
# 创建一个空列表用于保存所有模型的预测结果
vote = []
# 对于每一个模型
for model in self.models:
# 预测特征的类别
r = model.predict(feature)
# 将预测结果添加到投票列表中
vote.append(r)
# 将投票列表转换为ndarray
vote = np.array(vote)
# 对于每一个特征
for i in range(len(feature)):
# 统计每个类别的票数,并按票数降序排序
v = sorted(Counter(vote[:, i]).items(), key=lambda x: x[1], reverse=True)
# 将票数最多的类别添加到结果列表中
result.append(v[0][0])
# 将结果列表转换为ndarray并返回
return np.array(result)

2. 随机森林算法流程

随机森林的训练流程

随机森林是 Bagging 的一种扩展变体,随机森林的训练过程相对与 Bagging 的训练过程的改变有:

  • 基学习器: Bagging 的基学习器可以是任意学习器,而随机森林则是以决策树作为基学习器。
  • 随机属性选择:假设原始训练数据集有 10 个特征,从这 10 个特征中随机选取 k 个特征构成训练数据子集,然后将这个子集作为训练集扔给决策树去训练。其中 k 的取值一般为 log2(特征数量) 。

这样的改动通常会使得随机森林具有更加强的泛化性,因为每一棵决策树的训练数据集是随机的,而且训练数据集中的特征也是随机抽取的。如果每一棵决策树模型的差异比较大,那么就很容易能够解决决策树容易过拟合的问题。

随机森林训练过程伪代码如下:

1
2
3
4
5
6
7
8
9
10
#假设数据集为D,标签集为A,需要构造的决策树为tree
def fit(D, A):
models = []
for i in range(决策树的数量):
有放回的随机采样数据,得到数据集sample_D和标签sample_A
从采样到的数据中随机抽取K个特征构成训练集sub_D
构建决策树tree
tree.fit(sub_D, sample_A)
models.append(tree)
return models
随机森林的预测流程

随机森林的预测流程与 Bagging 的预测流程基本一致,如果是回归,就将结果基学习器的预测结果全部加起来算平均;如果是分类,就投票,票数最多的结果作为最终结果。**但需要注意的是,在预测时所用到的特征必须与训练模型时所用到的特征保持一致。**例如,第 3 棵决策树在训练时用到了训练集的第 2,5,8 这 3 个特征。那么在预测时也要用第 2,5,8 这 3 个特征所组成的测试集传给第 3 棵决策树进行预测。

编程要求

在 begin-end 中完成 RandomForestClassifier 类中的 fit 和 predict 函数。分类器可使用 sklearn 提供的 DecisionTreeClassifier ,要求模型保存在 self.models 中。

fit 函数用于随机森林的训练过程,其中:

  • feature :训练集数据,类型为 ndarray;
  • label :训练集标签,类型为 ndarray。

predict 函数,实现预测功能,并将标签返回,其中:

  • feature :测试集数据,类型为 ndarray 。(PS:feature中有多条数据)

全部代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
import numpy as np
from collections import Counter
from sklearn.tree import DecisionTreeClassifier

class RandomForestClassifier():
def __init__(self, n_model=10):
'''
初始化函数
'''
# 分类器的数量,默认为10
self.n_model = n_model
# 用于保存模型的列表,训练好分类器后将对象append进去即可
self.models = []
# 用于保存决策树训练时随机选取的列的索引
self.col_indexs = []

def fit(self, feature, label):
'''
训练模型
:param feature: 训练数据集所有特征组成的ndarray
:param label:训练数据集中所有标签组成的ndarray
:return: None
'''
# 对于每一个模型
for i in range(self.n_model):
# 获取特征数量
m = len(feature)
# 生成随机索引,用于自助采样(bootstrap sampling)
index = np.random.choice(m, m)
# 随机选择一部分特征的索引
col_index = np.random.permutation(len(feature[0]))[:int(np.log2(len(feature[0])))]
# 根据随机索引生成训练数据集和标签
sample_data = feature[index]
# 只保留选定的特征
sample_data = sample_data[:, col_index]
sample_lable = label[index]
# 创建并训练决策树分类器
model = DecisionTreeClassifier()
model = model.fit(sample_data, sample_lable)
# 将训练好的分类器和特征索引添加到相应的列表中
self.models.append(model)
self.col_indexs.append(col_index)

def predict(self, feature):
'''
:param feature:训练数据集所有特征组成的ndarray
:return:预测结果,如np.array([0, 1, 2, 2, 1, 0])
'''
# 创建一个空列表用于保存每个模型的预测结果
result = []
# 创建一个空列表用于保存所有模型的预测结果
vote = []
# 对于每一个模型
for i, model in enumerate(self.models):
# 只保留选定的特征
f = feature[:, self.col_indexs[i]]
# 预测特征的类别
r = model.predict(f)
# 将预测结果添加到投票列表中
vote.append(r)
# 将投票列表转换为ndarray
vote = np.array(vote)
# 对于每一个特征
for i in range(len(feature)):
# 统计每个类别的票数,并按票数降序排序
v = sorted(Counter(vote[:, i]).items(), key=lambda x: x[1], reverse=True)
# 将票数最多的类别添加到结果列表中
result.append(v[0][0])
# 将结果列表转换为ndarray并返回
return np.array(result)

3. 手写数字识别

数据简介

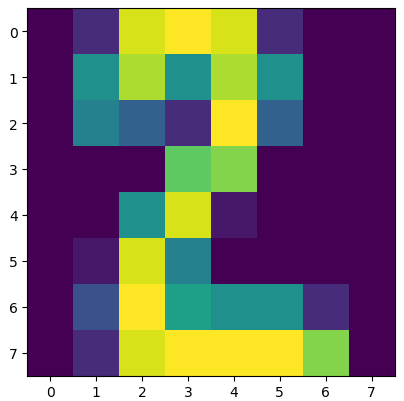
本关使用的是手写数字数据集,该数据集有 1797 个样本,每个样本包括 8*8 像素(实际上是一条样本有 64 个特征,每个像素看成是一个特征,每个特征都是 float 类型的数值)的图像和一个 [0, 9] 整数的标签。比如下图的标签是 2 :
预览大图

RandomForestClassifier

RandomForestClassifier 的构造函数中有两个常用的参数可以设置:

  • n_estimators :森林中决策树的数量;
  • criterion :构建决策树时,划分节点时用到的指标。有 gini (基尼系数), entropy (信息增益)。若不设置,默认为 gini;
  • max_depth :决策树的最大深度,如果发现模型已经出现过拟合,可以尝试将该参数调小。若不设置,默认为 None;
  • max_features :随机选取特征时选取特征的数量,一般传入 auto 或者 log2,默认为 auto , auto 表示 max_features=sqrt(训练集中特征的数量) ;log2 表示 max_features=log2(训练集中特征的数量)。

RandomForestClassifier 类中的 fit 函数实现了随机森林分类器训练模型的功能,predict 函数实现了模型预测的功能。

其中 fit 函数的参数如下:

  • X :大小为 [样本数量,特征数量] 的 ndarry,存放训练样本;
  • Y :值为整型,大小为 [样本数量] 的 ndarray,存放训练样本的分类标签。

而 predict 函数有一个向量输入:

  • X :大小为 [样本数量,特征数量] 的 ndarry,存放预测样本。

RandomForestClassifier 的使用代码如下:

1
from sklearn.ensemble import RandomForestClassifierclf = RandomForestClassifier(n_estimators=50)clf.fit(X_train, Y_train)result = clf.predict(X_test)

编程要求

在右侧区域的 begin-end 之间填写digit_predict(train_image, train_label, test_image)函数完成手写数字分类任务,其中:

  • train_image :包含多条训练样本的样本集,类型为 ndarray , shape 为 [-1, 8, 8] ,在喂给分类器之前请记得将其变形;
  • train_label :包含多条训练样本标签的标签集,类型为 ndarray;
  • test_image :包含多条测试样本的测试集,类型为 ndarray;
  • return : test_image 对应的预测标签,类型为 ndarray。

全部代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
from sklearn.ensemble import RandomForestClassifier
import numpy as np

def digit_predict(train_image, train_label, test_image):
'''
实现功能:训练模型并输出预测结果
:param train_image: 包含多条训练样本的样本集,类型为ndarray,shape为[-1, 8, 8]
:param train_label: 包含多条训练样本标签的标签集,类型为ndarray
:param test_image: 包含多条测试样本的测试集,类型为ndarry
:return: test_image对应的预测标签,类型为ndarray
'''

# 将训练集的图像数据从三维转换为二维,每一行代表一个样本,每一列代表一个特征
# 原始的图像数据是8x8的,转换后每一行有64个特征
X = np.reshape(train_image, newshape=(-1, 64))

# 创建一个随机森林分类器,设置树的数量为500,树的最大深度为10
clf = RandomForestClassifier(n_estimators=500, max_depth=10)

# 使用训练数据和对应的标签训练(拟合)随机森林分类器
clf.fit(X, y=train_label)

# 使用训练好的随机森林分类器对测试数据进行预测,并返回预测结果
return clf.predict(test_image)