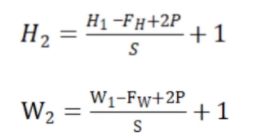上文已经介绍了集成学习,也初步讲明了Bagging的原理,本文将从数学原理上介绍Bagging与随机森林,然后以一个手写数字识别的小例子来演示随机森林算法。

本文基于机器学习之随机森林算法 (educoder.net)来介绍Bagging和随机森林。

1. Bagging

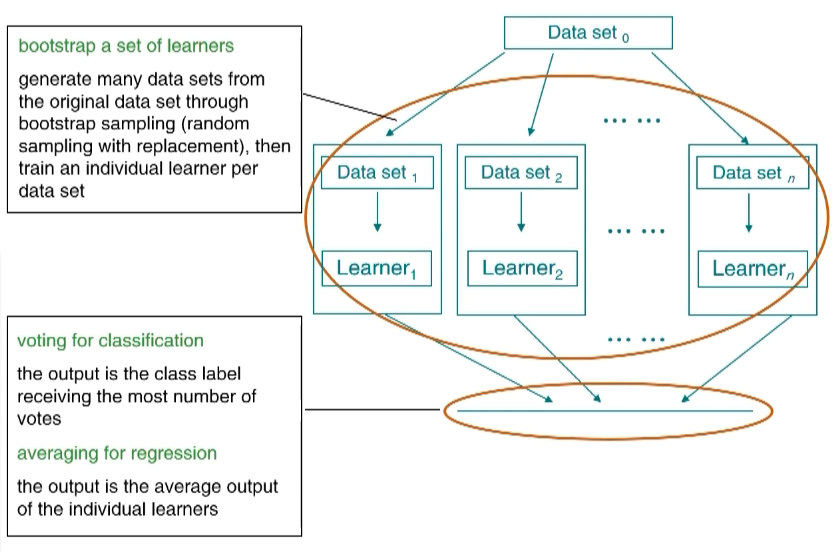
Bagging在训练时的特点就是随机有放回采样和并行。

  • 随机有放回采样:假设训练数据集有 m 条样本数据,每次从这 m 条数据中随机取一条数据放入采样集,然后将其返回,让下一次采样有机会仍然能被采样。然后重复 m 次,就能得到拥有 m 条数据的采样集,该采样集作为 Bagging 的众多分类器中的一个作为训练数据集。假设有 T 个分类器(随便什么分类器),那么就重复 T 此随机有放回采样,构建出 T 个采样集分别作为 T 个分类器的训练数据集。
  • 并行:假设有 10 个分类器,在 Boosting 中,1 号分类器训练完成之后才能开始 2 号分类器的训练,而在 Bagging 中,分类器可以同时进行训练,当所有分类器训练完成之后,整个 Bagging 的训练过程就结束了。

Bagging 训练过程如下图所示:

预览大图

预测

Bagging 在预测时非常简单,就是投票!比如现在有 5 个分类器,有 3 个分类器认为当前样本属于 A 类,1 个分类器认为属于 B 类,1 个分类器认为属于 C 类,那么 Bagging 的结果会是 A 类(因为 A 类的票数最高)。

Bagging 预测过程如下图所示:

预览大图

编程要求

在 begin-end 中完成 BaggingClassifier 类中的 fit 和 predict 函数。分类器可使用 sklearn 提供的 DecisionTreeClassifier。要求模型保存在 self.models 中。

fit 函数用于 Bagging 的训练过程,其中:

  • feature :训练集数据,类型为 ndarray;
  • label :训练集标签,类型为 ndarray。

predict 函数,实现预测功能,并将标签返回,其中:

  • feature :测试集数据,类型为 ndarray 。(PS:feature中有多条数据)

全部代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
import numpy as np
from collections import Counter
from sklearn.tree import DecisionTreeClassifier

class BaggingClassifier():
def __init__(self, n_model=10):
'''
初始化函数
'''
# 分类器的数量,默认为10
self.n_model = n_model
# 用于保存模型的列表,训练好分类器后将对象append进去即可
self.models = []

def fit(self, feature, label):
'''
训练模型
:param feature: 训练数据集所有特征组成的ndarray
:param label:训练数据集中所有标签组成的ndarray
:return: None
'''
# 对于每一个模型
for i in range(self.n_model):
# 获取特征数量
m = len(feature)
# 生成随机索引,用于自助采样(bootstrap sampling)
index = np.random.choice(m, m)
# 根据随机索引生成训练数据集和标签
sample_data = feature[index]
sample_lable = label[index]
# 创建并训练决策树分类器
model = DecisionTreeClassifier()
model = model.fit(sample_data, sample_lable)
# 将训练好的分类器添加到模型列表中
self.models.append(model)

def predict(self, feature):
'''
:param feature:训练数据集所有特征组成的ndarray
:return:预测结果,如np.array([0, 1, 2, 2, 1, 0])
'''
# 创建一个空列表用于保存每个模型的预测结果
result = []
# 创建一个空列表用于保存所有模型的预测结果
vote = []
# 对于每一个模型
for model in self.models:
# 预测特征的类别
r = model.predict(feature)
# 将预测结果添加到投票列表中
vote.append(r)
# 将投票列表转换为ndarray
vote = np.array(vote)
# 对于每一个特征
for i in range(len(feature)):
# 统计每个类别的票数,并按票数降序排序
v = sorted(Counter(vote[:, i]).items(), key=lambda x: x[1], reverse=True)
# 将票数最多的类别添加到结果列表中
result.append(v[0][0])
# 将结果列表转换为ndarray并返回
return np.array(result)

2. 随机森林算法流程

随机森林的训练流程

随机森林是 Bagging 的一种扩展变体,随机森林的训练过程相对与 Bagging 的训练过程的改变有:

  • 基学习器: Bagging 的基学习器可以是任意学习器,而随机森林则是以决策树作为基学习器。
  • 随机属性选择:假设原始训练数据集有 10 个特征,从这 10 个特征中随机选取 k 个特征构成训练数据子集,然后将这个子集作为训练集扔给决策树去训练。其中 k 的取值一般为 log2(特征数量) 。

这样的改动通常会使得随机森林具有更加强的泛化性,因为每一棵决策树的训练数据集是随机的,而且训练数据集中的特征也是随机抽取的。如果每一棵决策树模型的差异比较大,那么就很容易能够解决决策树容易过拟合的问题。

随机森林训练过程伪代码如下:

1
2
3
4
5
6
7
8
9
10
#假设数据集为D,标签集为A,需要构造的决策树为tree
def fit(D, A):
models = []
for i in range(决策树的数量):
有放回的随机采样数据,得到数据集sample_D和标签sample_A
从采样到的数据中随机抽取K个特征构成训练集sub_D
构建决策树tree
tree.fit(sub_D, sample_A)
models.append(tree)
return models
随机森林的预测流程

随机森林的预测流程与 Bagging 的预测流程基本一致,如果是回归,就将结果基学习器的预测结果全部加起来算平均;如果是分类,就投票,票数最多的结果作为最终结果。**但需要注意的是,在预测时所用到的特征必须与训练模型时所用到的特征保持一致。**例如,第 3 棵决策树在训练时用到了训练集的第 2,5,8 这 3 个特征。那么在预测时也要用第 2,5,8 这 3 个特征所组成的测试集传给第 3 棵决策树进行预测。

编程要求

在 begin-end 中完成 RandomForestClassifier 类中的 fit 和 predict 函数。分类器可使用 sklearn 提供的 DecisionTreeClassifier ,要求模型保存在 self.models 中。

fit 函数用于随机森林的训练过程,其中:

  • feature :训练集数据,类型为 ndarray;
  • label :训练集标签,类型为 ndarray。

predict 函数,实现预测功能,并将标签返回,其中:

  • feature :测试集数据,类型为 ndarray 。(PS:feature中有多条数据)

全部代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
import numpy as np
from collections import Counter
from sklearn.tree import DecisionTreeClassifier

class RandomForestClassifier():
def __init__(self, n_model=10):
'''
初始化函数
'''
# 分类器的数量,默认为10
self.n_model = n_model
# 用于保存模型的列表,训练好分类器后将对象append进去即可
self.models = []
# 用于保存决策树训练时随机选取的列的索引
self.col_indexs = []

def fit(self, feature, label):
'''
训练模型
:param feature: 训练数据集所有特征组成的ndarray
:param label:训练数据集中所有标签组成的ndarray
:return: None
'''
# 对于每一个模型
for i in range(self.n_model):
# 获取特征数量
m = len(feature)
# 生成随机索引,用于自助采样(bootstrap sampling)
index = np.random.choice(m, m)
# 随机选择一部分特征的索引
col_index = np.random.permutation(len(feature[0]))[:int(np.log2(len(feature[0])))]
# 根据随机索引生成训练数据集和标签
sample_data = feature[index]
# 只保留选定的特征
sample_data = sample_data[:, col_index]
sample_lable = label[index]
# 创建并训练决策树分类器
model = DecisionTreeClassifier()
model = model.fit(sample_data, sample_lable)
# 将训练好的分类器和特征索引添加到相应的列表中
self.models.append(model)
self.col_indexs.append(col_index)

def predict(self, feature):
'''
:param feature:训练数据集所有特征组成的ndarray
:return:预测结果,如np.array([0, 1, 2, 2, 1, 0])
'''
# 创建一个空列表用于保存每个模型的预测结果
result = []
# 创建一个空列表用于保存所有模型的预测结果
vote = []
# 对于每一个模型
for i, model in enumerate(self.models):
# 只保留选定的特征
f = feature[:, self.col_indexs[i]]
# 预测特征的类别
r = model.predict(f)
# 将预测结果添加到投票列表中
vote.append(r)
# 将投票列表转换为ndarray
vote = np.array(vote)
# 对于每一个特征
for i in range(len(feature)):
# 统计每个类别的票数,并按票数降序排序
v = sorted(Counter(vote[:, i]).items(), key=lambda x: x[1], reverse=True)
# 将票数最多的类别添加到结果列表中
result.append(v[0][0])
# 将结果列表转换为ndarray并返回
return np.array(result)

3. 手写数字识别

数据简介

本关使用的是手写数字数据集,该数据集有 1797 个样本,每个样本包括 8*8 像素(实际上是一条样本有 64 个特征,每个像素看成是一个特征,每个特征都是 float 类型的数值)的图像和一个 [0, 9] 整数的标签。比如下图的标签是 2 :

预览大图

RandomForestClassifier

RandomForestClassifier 的构造函数中有两个常用的参数可以设置:

  • n_estimators :森林中决策树的数量;
  • criterion :构建决策树时,划分节点时用到的指标。有 gini (基尼系数), entropy (信息增益)。若不设置,默认为 gini;
  • max_depth :决策树的最大深度,如果发现模型已经出现过拟合,可以尝试将该参数调小。若不设置,默认为 None;
  • max_features :随机选取特征时选取特征的数量,一般传入 auto 或者 log2,默认为 auto , auto 表示 max_features=sqrt(训练集中特征的数量) ;log2 表示 max_features=log2(训练集中特征的数量)。

RandomForestClassifier 类中的 fit 函数实现了随机森林分类器训练模型的功能,predict 函数实现了模型预测的功能。

其中 fit 函数的参数如下:

  • X :大小为 [样本数量,特征数量] 的 ndarry,存放训练样本;
  • Y :值为整型,大小为 [样本数量] 的 ndarray,存放训练样本的分类标签。

而 predict 函数有一个向量输入:

  • X :大小为 [样本数量,特征数量] 的 ndarry,存放预测样本。

RandomForestClassifier 的使用代码如下:

1
from sklearn.ensemble import RandomForestClassifierclf = RandomForestClassifier(n_estimators=50)clf.fit(X_train, Y_train)result = clf.predict(X_test)

编程要求

在右侧区域的 begin-end 之间填写digit_predict(train_image, train_label, test_image)函数完成手写数字分类任务,其中:

  • train_image :包含多条训练样本的样本集,类型为 ndarray , shape 为 [-1, 8, 8] ,在喂给分类器之前请记得将其变形;
  • train_label :包含多条训练样本标签的标签集,类型为 ndarray;
  • test_image :包含多条测试样本的测试集,类型为 ndarray;
  • return : test_image 对应的预测标签,类型为 ndarray。

全部代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
from sklearn.ensemble import RandomForestClassifier
import numpy as np

def digit_predict(train_image, train_label, test_image):
'''
实现功能:训练模型并输出预测结果
:param train_image: 包含多条训练样本的样本集,类型为ndarray,shape为[-1, 8, 8]
:param train_label: 包含多条训练样本标签的标签集,类型为ndarray
:param test_image: 包含多条测试样本的测试集,类型为ndarry
:return: test_image对应的预测标签,类型为ndarray
'''

# 将训练集的图像数据从三维转换为二维,每一行代表一个样本,每一列代表一个特征
# 原始的图像数据是8x8的,转换后每一行有64个特征
X = np.reshape(train_image, newshape=(-1, 64))

# 创建一个随机森林分类器,设置树的数量为500,树的最大深度为10
clf = RandomForestClassifier(n_estimators=500, max_depth=10)

# 使用训练数据和对应的标签训练(拟合)随机森林分类器
clf.fit(X, y=train_label)

# 使用训练好的随机森林分类器对测试数据进行预测,并返回预测结果
return clf.predict(test_image)

1. 集成学习

1.1. 介绍

集成学习(Ensemble Learning)是一种机器学习策略,它结合了多个学习模型的预测以提高总体的预测准确性。这种方法基于这样一个观察:在许多情况下,一组模型的集成预测通常比任何单个模型的预测更准确。

集成学习的主要目标是结合多个模型以减少过拟合(通过增加模型的多样性),减少偏差(通过结合多个模型的预测),并提高预测的稳定性。

我们把集成学习中的每个模型叫做一个弱学习器或者个体或者基学习器、基模型,有很多种叫法。

1.2. 同质和异质

在集成学习中,”同质”和”异质”通常用来描述集成中使用的基学习器(base learners)或基模型(base models)的类型。

  • 同质集成(Homogeneous ensemble):在同质集成中,所有的基学习器都是同一类型的。例如,随机森林就是一个同质集成,因为它是由多个决策树组成的。
  • 异质集成(Heterogeneous ensemble):在异质集成中,基学习器可以是不同类型的。例如,一个异质集成可能包含决策树、支持向量机和神经网络等不同类型的模型。Stacking就是一个常见的异质集成方法,其中不同类型的模型被用作基学习器,然后一个元学习器(可以是另一种类型的模型)被用来结合这些基学习器的预测。

同质和异质集成各有优点和缺点。同质集成通常更容易实现和优化,因为所有的基学习器都是同一类型的。然而,异质集成可能能够更好地利用不同类型的模型的优点,从而可能在某些任务上表现得更好。

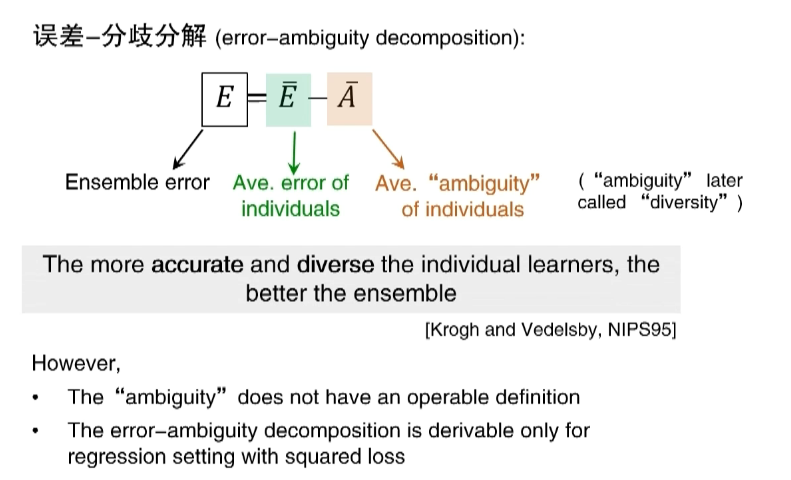
1.3. 误差-分歧分解(error-ambiguity decomposition)

个体要好而不同

得到一个好的集成并不容易,要满足学习器之间多样性要高,而且每个学习器的误差要低。

可以用以下公式表示:

image-20240518224829701

其中E是我们追求的值,E越小集成的性能越好,$\overline{E}$表示个体误差的平均值,$\overline{A}$表示个体差异的平均值。

理论上,计算出$\overline{E}$和$\overline{A}$之后,我们就可以通过不断减小模型的$\overline{E}$,增大模型的$\overline{A}$来得到一个最小的$E$值,但是实际上我们做不到,因为这个公式里面的ambiguity是从数学上强制定义的,要知道ambiguity必须知道理想的Ground Truth结果,如果不知道理想的Ground Truth,我们是无法得出ambiguity的,即上图所示,ambiguity并不是一个operable(可操作的)定义。

此外,只有在回归问题的squared loss下才可以得到上述分解公式,像分类问题的0-1 loss,是得不到上面的式子的。

误差-分歧分解公式只是在直觉上给了我们一个支撑,并不是一个可操作的公式,所以我们要研究很多有效的算法。

实际上,要实现上面这些非常困难,因为增大差异性就意为着个体性能的损失,这是一个取舍问题。

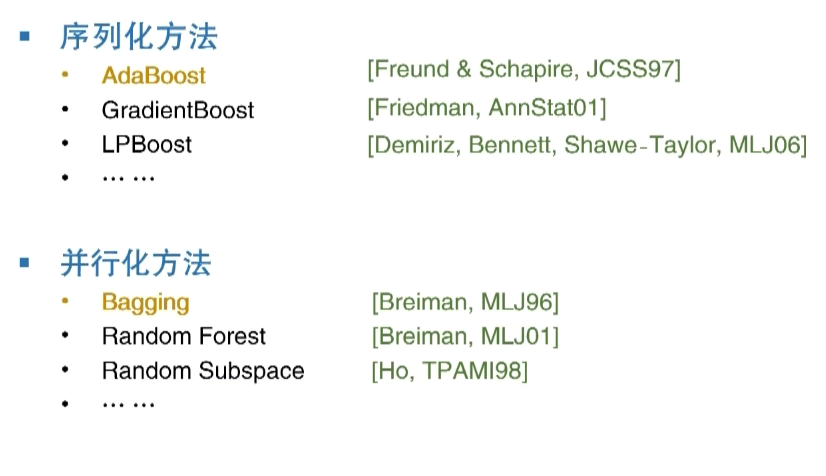
1.4. 成功的集成学习方法

image-20240518235743429

序列化方法是一种串行的方法,即一个一个执行,并行化方法是一种并行的方法,所有一起执行,对于序列化方法而言,其代表是AdaBoost,这是开端,而今天我们用的最多的其实是GradientBoost,其中XGBoost就是GradientBoost的一个实现。对于并行化方法,其开端是Bagging,但是今天最常用的是RF。

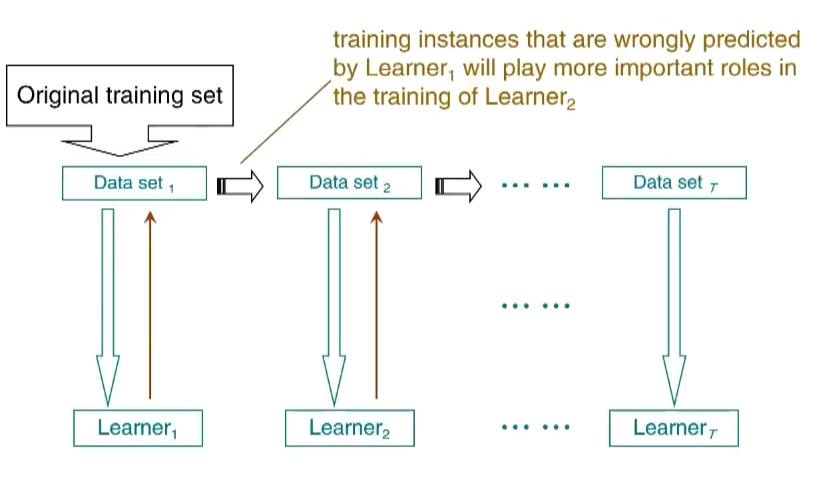
AdaBoost 是 AdaptiveBoost 的缩写,表明该算法是具有适应性的提升算法。

以AdaBoost为代表的Boosting家族,其原理大概如下:

image-20240519111203923

对于一个数据集,先交由第一个基学习器学习,然后该训练集检验学习好的模型,分为预测正确和预测错误的样本,对于预测正确的样本,我们减小其权重,预测错误的样本,增大其权重,然后对该数据集进行重采样或者直接带权重变成一个新的数据集,使得新数据集中上一个学习器预测错误的样本比正确的样本更重要。然后由新的基学习器重点学习之前做错的样本,这样循环往复,使得后一个学习器更关注之前做错的样本。最后预测的结果是所有基学习器按照误差率的一个加权结果,AdaBoost采取加权多数表决的方法,加大分类误差率小的弱分类器的权值,使其在表决中起较大的作用,减小分类误差率大的弱分类器的权值,使其在表决中起较小的作用。

Bagging家族的原理就更好理解了,对于原始的数据集,我们进行一个Bootstrap(重采样),使得交给每个基学习器的数据集并不相同但是都来自于原始数据集,然后总预测结果我们对每一个基学习器的预测进行同等的对待,这与之前Boosting有所不同。RF是Bagging的改进版,至今仍非常广泛的使用。

image-20240519112729370

1.5. 圣杯问题

image-20240519114445064

以上图为例,我们可以用$\frac{b+c}{a+b+c+d}$来衡量两个分类器的差异性,这是一种度量方式,也可以用$\frac{(b+c)-(a+d)}{a+b+c+d}$来作为另外一种度量,有很多种度量方式。

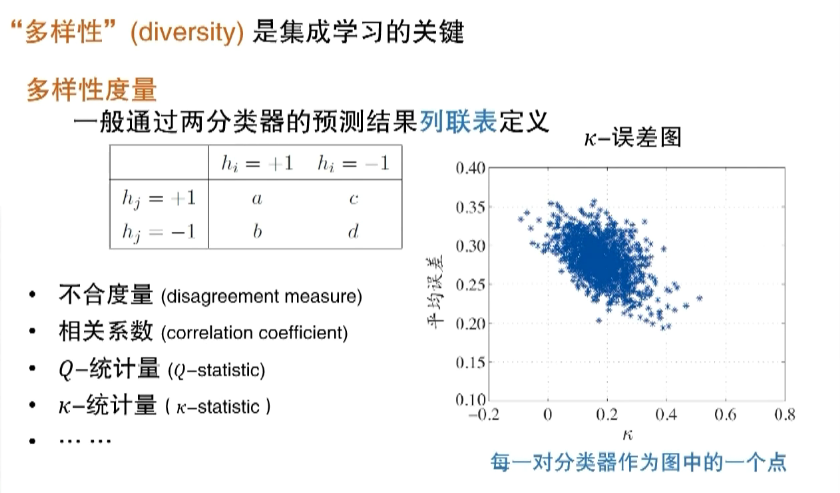
研究者提出了很多Diversity measure:

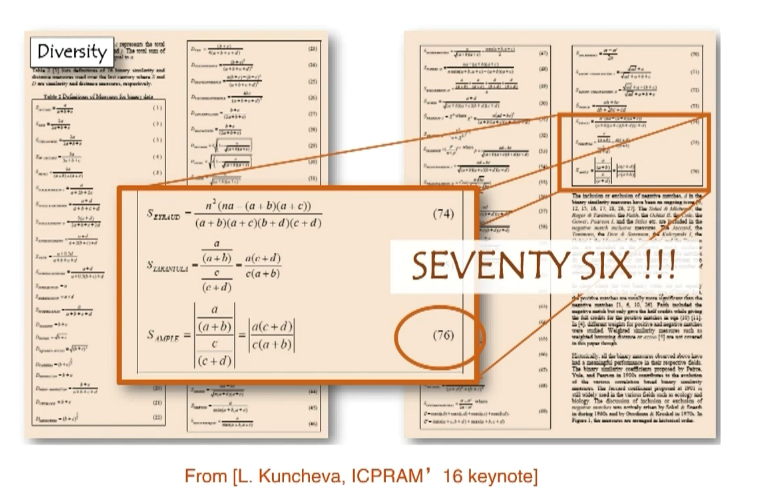
image-20240519115802651

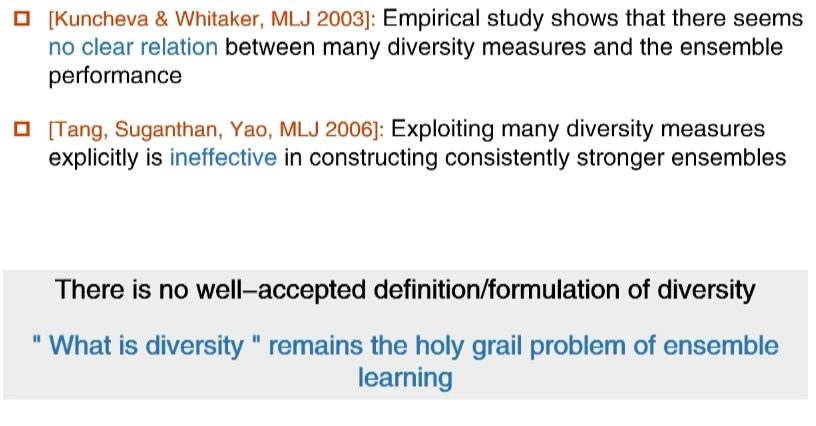
但是这些度量至今没有完全解决问题,或多或少都有自己的问题,所有刻画Diversity的方法都不能得到大家的完全认可,所以这件事还需要进一步的研究。

image-20240519120145063

我们离真正解决Diversity measure还差的很远,这是集成学习的一个holy grail problem(圣杯问题)。一旦我们完美解决了Diversity measure,也即解决了$E=\overline{E}-\overline{A}$中的$\overline{A}$,那么集成学习将没有秘密可言,要知道我们现在的机器学习和集成学习的关系,做一个好的模型几乎都离不开集成学习。

1.6. 意义

集成学习在深度学习的大环境下依然有意义,很多时候我们还是选择用深度学习做一个特征学习,把深度神经网络的倒数第二层输出给一个集成学习模型,比如一个随机森林(RF)或者XGBoost,这样比单纯用深度学习的效果要好。

2. 基于Adaboost的鸢尾花分类模型

本例子基于机器学习 — Adaboost (educoder.net)

2.1. 数学原理

上面已经简单的介绍了Adaboost的基本原理,这里从公式和数学角度介绍一下Adaboost具体该怎么实现:

  1. 初始化样本权重:给每个训练样本$(x_1,x_2,…,x_N)$分配权重,初始权重$w_1$均为$1/N$。

  2. 训练弱分类器:使用带有权重的样本训练一个弱分类器。这个弱分类器可以是任何一种基本的机器学习模型,如决策树、线性分类器等,得到模型$G_m$(初始模型为$G_1$),通过这个带权重的训练过程,我们从初始模型$G_1$开始,经过$m-1$次迭代更新,最终得到了模型$G_m$。在每次迭代中,模型都会尝试更好地拟合那些具有较高权重(也就是在前一次迭代中预测错误)的样本。。

  3. 计算$G_m$误分率:误分率是指弱分类器在所有样本上的错误分类的比例,它是由弱分类器的权重和指示函数(指示函数的值为1表示样本被错误分类,为0表示样本被正确分类)的乘积求和得到的。

    $e_m=\underset{i}{\overset{N}{\sum}} w_iI(y_i\neq{G_M(X_i))}$

    其中:
    $I(y_i\neq{G_M(X_i)})$

    为指示函数,表示括号里成立时函数值为1,否则为0。

  4. 计算弱分类器$G_m$的权重:弱分类器的权重(或称为系数)是基于其误分率计算的。误分率越低,弱分类器的权重就越大,这意味着它在最终的强分类器中的作用就越大。

    $\alpha_m=\frac{1}{2}\log{[\frac{1-e_m}{e_m}]}$

  5. 更新样本权重:根据弱分类器的误分率$e$和当前的样本权重$w_m$,更新样本的权重。如果一个样本被正确分类,那么它的权重就会被降低;如果一个样本被错误分类,那么它的权重就会被提高。这样可以使得那些被错误分类的样本在后续的训练中得到更多的关注。

    $w_{m+1,i}=\frac{w_m}{z_m}\exp(-\alpha_my_iG_m(x_i))$

    其中$z_m$为规范化因子(规范化因子$z_m$是用来确保权重$w_{m+1,i}$的总和为1的):

    $z_m=\underset{i=1}{\overset{m}{\sum}}w_{mi}\exp(-\alpha_my_iG_m(x_i))$

    规范化因子$z_m$是用来确保权重$w_{m+1,i}$的总和为1的。这是因为在许多机器学习算法中,如 AdaBoost,样本权重被解释为概率分布,因此它们的总和必须为1。

  6. 计算组合模型$f(x)=\underset{m=1}{\overset{M}{\sum}}\alpha_mG_m(x_i)$的误分率:组合模型是所有弱分类器的加权组合,其误分率是所有弱分类器的误分率的加权平均。每个弱分类器的权重就是其在组合模型中的作用。

  7. 检查停止条件:如果组合模型的误分率低于一定的阈值,或者达到了最大的迭代次数,那么就停止迭代。否则,返回到步骤2,继续训练新的弱分类器。

AdaBoost的目标是通过不断地迭代训练,找到一个误分率最低的强分类器。在每次迭代中,都会增加一个新的弱分类器,同时更新样本的权重,使得那些被错误分类的样本在后续的训练中得到更多的关注。这样,AdaBoost可以逐渐改进其分类性能,最终得到一个强大的分类器。

2.2. 具体实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
# encoding=utf8
import numpy as np
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import AdaBoostClassifier

# adaboost算法
class AdaBoost:
'''
input:n_estimators(int):迭代轮数
learning_rate(float):弱分类器权重缩减系数
'''

def __init__(self, n_estimators=50, learning_rate=1.0):
self.clf_num = n_estimators
self.learning_rate = learning_rate

def init_args(self, datasets, labels):
self.X = datasets
self.Y = labels
self.M, self.N = datasets.shape
# 弱分类器数目和集合
self.clf_sets = []
# 初始化weights
self.weights = [1.0 / self.M] * self.M
# G(x)系数 alpha
self.alpha = []

# ********* Begin *********#
def _G(self, features, labels, weights):
'''
input:features(ndarray):数据特征
labels(ndarray):数据标签
weights(ndarray):样本权重系数
'''
e = 0
for i in range(weights.shape[0]):
if (labels[i] == self.G(self.X[i], self.clif_sets, self.alpha)):
e += weights[i]
return e

# 计算alpha
def _alpha(self, error):
return 0.5 * np.log((1 - error) / error)

# 规范化因子
def _Z(self, weights, a, clf):
return np.sum(weights * np.exp(-a * self.Y * self.G(self.X, clf, self.alpha)))

# 权值更新
def _w(self, a, clf, Z):
w = np.zeros(self.weights.shape)
for i in range(self.M):
w[i] = weights[i] * np.exp(-a * self.Y[i] * G(x, clf, self.alpha)) / Z
self.weights = w

# G(x)的线性组合
def G(self, x, v, direct):
result = 0
x = x.reshape(1, -1)
for i in range(len(v)):
result += v[i].predict(x) * direct[i]
return result

def fit(self, X, y):
'''
X(ndarray):训练数据
y(ndarray):训练标签
'''

# 计算G(x)系数a
self.init_args(X, y)
'''
for i in range(100):
classifier = DecisionTreeClassifier(max_depth=3)
classifier.fit(X, y)
self.clf_sets.append(classifier)
e = 0
for i in range(len(self.weights)):
temp = -1
if classifier.predict(X[i].reshape(1,-1))>0:
temp = 1
if(self.Y[i] == temp):
e += self.weights[i]
a = self._alpha(e)
self.alpha.append(a)
z = self._Z(self.weights, a, self.clf_sets)
self._w(a, self.clf_sets, z)
'''

# 记录分类器

# 规范化因子

# 权值更新

def predict(self, data):
'''
input:data(ndarray):单个样本
output:预测为正样本返回+1,负样本返回-1
'''
ada = AdaBoostClassifier(n_estimators=100, learning_rate=0.1)
ada.fit(self.X, self.Y)
data = data.reshape(1, -1)
predict = ada.predict(data)
return predict[0]

# ********* End *********#

目录

1. 概览

1.1. 总体介绍

周志华教授曾表达过这样的思想:快速入门一个学科,不是把一个学科,一本书里面的一个章节研究的非常透彻,而是快速通读全书,大致了解整本书在讲些什么,然后在后续的学习中持续发掘其中的细节,直至慢慢掌握其精髓。以我的理解,就是快速写出它的“hello world”,大概就能一定程度上体会到它在讲些什么。

而手写数字识别,作为神经网络的入门课,就扮演着“hello world”这样的角色。

1.2. 名词解释

为后续理解作基本的铺垫

  • CNN,全称卷积神经网络(Convolutional Neural Network),是一种深度学习的算法,特别适合于处理图像数据。CNN在图像识别、语音识别等许多领域都有广泛的应用。

    CNN的主要特点是它可以自动地学习到从原始数据中提取哪些特征是重要的,这是通过训练过程中的权重调整实现的。这与传统的机器学习方法不同,传统的机器学习方法通常需要人工选择和提取特征。

    CNN的基本组成部分包括卷积层、池化层(Pooling Layer)和全连接层(Fully Connected Layer)。卷积层用于从输入数据中提取局部特征,池化层用于降低数据的维度,全连接层则用于将学习到的特征进行最终的分类或回归。

  • MNIST(Modified National Institute of Standards and Technology database)是一个广泛用于训练各种图像处理系统的大型手写数字数据库。它包含60,000个训练样本和10,000个测试样本,每个样本都是一个28x28像素的灰度图像,代表了0到9的一个数字。

    MNIST数据集是由美国国家标准与技术研究院(NIST)的原始数据集修改和混合而来的。它的目标是作为一个简单的计算机视觉基准数据集,用于科研人员测试和比较不同的机器学习和图像处理算法。

    MNIST数据集的一个重要特点是,它的样本已经进行了预处理,包括中心化、归一化等,这使得它非常适合用于基础的机器学习和深度学习实验。因此,MNIST数据集经常被用作教学和研究的基准数据集,特别是在图像识别和机器学习的初级教学中。

  • Ground Truth 是一个术语,通常在机器学习和计算机视觉领域中使用,指的是数据的真实标签或真实值。在监督学习中,我们通常有一组带有标签的训练数据,这些标签就是 “ground truth”。这些真实的标签用于训练模型,使模型能够学习到输入数据和输出标签之间的映射关系。

    例如,在图像分类任务中,每张图片的 “ground truth” 就是图片的真实类别;在物体检测任务中,每个物体的 “ground truth” 是物体的类别和其在图像中的位置(通常表示为一个边界框);在回归任务中,每个输入的 “ground truth” 是一个连续的数值。

    “Ground truth” 是评估模型性能的基础。通过将模型的预测结果与 “ground truth” 进行比较,我们可以计算出各种性能指标,如准确率、召回率、F1分数、均方误差等,以了解模型的性能如何。

  • threshold,在神经网络和其他机器学习模型中,”threshold” 是一个常见的术语,用来描述一个决定性的界限。当某个值超过这个界限时,模型的行为或输出会发生改变。

  • CUDA(Compute Unified Device Architecture)是由NVIDIA公司开发的一种并行计算平台和应用程序接口(API)。它允许开发者使用NVIDIA的图形处理单元(GPU)进行通用计算。

    在过去,GPU主要用于渲染计算机图形,但由于其强大的并行处理能力,现在已经被广泛用于其他计算密集型任务,如科学计算、机器学习和深度学习等。

    CUDA提供了一种相对简单的方式来编写并行代码,使得开发者可以更容易地利用GPU的计算能力。在深度学习中,使用CUDA可以显著加速训练和推理过程,特别是对于需要大量计算的任务,如训练复杂的神经网络模型。

    值得注意的是,虽然CUDA是NVIDIA开发的,但许多深度学习框架(如TensorFlow和PyTorch)都支持使用CUDA,这使得它们可以在NVIDIA的GPU上运行。

  • cuDNN,全称CUDA Deep Neural Network library,是由NVIDIA开发的一个深度神经网络GPU加速库。它是专门为深度神经网络的前向和反向传播过程提供优化的库,包括卷积、池化、归一化、激活层等常见的神经网络操作。

    cuDNN的主要优点是可以在NVIDIA的CUDA-enabled GPUs上提供高效的计算性能。它提供了低级的API,可以直接进行底层的操作,也提供了高级的API,可以方便地进行常见的操作。

    许多深度学习框架,如TensorFlow、PyTorch、Caffe等,都使用cuDNN来加速在GPU上的计算。使用cuDNN可以大大提高深度学习模型的训练和推理速度。

  • PyTorch是一个开源的机器学习库,由Facebook的人工智能研究团队开发。它提供了两个主要功能:

    1. 一个n维数组库,类似于NumPy,但可以在GPU上运行以进行高效的数值计算。
    2. 自动微分系统(用于实现神经网络),支持动态计算图,这使得它在构建和训练复杂的深度学习模型时具有很大的灵活性。

    PyTorch的一个主要特点是其动态计算图系统。在许多其他深度学习库中(如TensorFlow和Theano),计算图在运行前需要被完全定义并编译。相比之下,PyTorch允许你在运行时动态地改变计算图,这使得它更易于理解和调试,也更适合处理变长的输入数据。

    PyTorch还提供了一系列的工具和库,包括用于数据加载和预处理的torchvision库,用于机器学习的torchtext库,以及用于科学计算和高级优化的torch.optim库等。

    PyTorch的设计理念是简洁、灵活和直观,这使得它在研究社区中非常受欢迎,同时也逐渐在工业界得到应用。

  • Kaggle是一个在线社区,为数据科学家和机器学习工程师提供一个平台,他们可以在这个平台上发现和分享数据集,探索和构建模型,进行数据科学和机器学习竞赛,以及发布和分享他们的工作。

    Kaggle的主要特点包括:

    1. 竞赛:Kaggle最初是作为一个平台开始的,公司和研究者可以在上面发布数据科学竞赛。这些竞赛涵盖了各种问题,从图像分类到文本分析,从预测模型到推荐系统。参与者可以提交他们的解决方案,并在公共排行榜上与其他参与者竞争。许多竞赛还提供现金奖励。
    2. 数据集:Kaggle提供了一个平台,用户可以发布、搜索和下载数据集。这些数据集涵盖了各种主题,包括(但不限于)公共卫生、经济学、图像识别、自然语言处理等。
    3. Kernels/Notebooks:Kaggle提供了一个在线代码执行环境,称为Kaggle Kernels(现在更名为Kaggle Notebooks)。用户可以在这个环境中编写Python或R代码,进行数据分析和建模,然后分享他们的代码和结果。
    4. 讨论论坛:Kaggle社区有一个活跃的讨论论坛,用户可以在这里讨论竞赛、数据集、编程问题,以及数据科学和机器学习的最新趋势。

    Kaggle是一个很好的资源,无论你是一个数据科学新手,还是一个有经验的专业人士,都可以在这里学习、分享和发展你的技能。

  • 超参数,在机器学习中,超参数是在开始学习过程之前设置的参数,而不是通过训练得到的参数。换句话说,超参数是模型训练之前由数据科学家或机器学习工程师手动设置的参数。

    超参数可以影响模型的学习过程和模型的性能。例如,对于神经网络,超参数可能包括学习率(决定模型学习的速度),批次大小(每次训练步骤中用于更新模型权重的样本数量),以及训练的轮数(整个数据集通过模型的次数)等。

    另一个例子是支持向量机(SVM)的惩罚参数C和核函数的参数。这些超参数控制模型的复杂性和灵活性。

    选择合适的超参数是机器学习中的一个重要任务,因为不同的超参数可能会导致模型的性能有很大的差异。这个过程通常需要大量的实验和调整,也可以使用一些自动化的方法,如网格搜索、随机搜索或贝叶斯优化等。

  • batch,在机器学习和深度学习中,”batch”是指用于一次模型更新的数据集的子集。批处理大小(batch size)是一个超参数,定义了每次迭代(或更新)中用于计算梯度的样本数量。

    例如,假设你有一个包含1000个样本的训练集,如果你设置批处理大小为100,那么你的模型将在每个训练周期(epoch)中进行10次更新,每次更新使用100个样本。

    批处理的主要优点是:

    1. 计算效率:使用批处理可以利用并行处理能力,比如GPU,从而提高计算效率。
    2. 稳定的梯度估计:使用更大的批处理可以得到更稳定(但可能不是更准确)的梯度估计。
    3. 内存使用:对于大型数据集,可能无法一次性将所有数据加载到内存中,批处理可以有效地管理内存使用。

    然而,选择批处理大小也是一个权衡。较小的批处理可能会导致更频繁的更新,可能会导致训练过程更快地收敛,但也可能导致梯度估计的噪声更大。另一方面,较大的批处理可能会导致更稳定的梯度估计,但可能需要更多的内存,并且可能需要更多的训练周期才能收敛。

  • epoch,在机器学习和深度学习中,”epoch”是指整个训练集通过模型一次的过程。换句话说,一个epoch就是模型看过训练集中的每一个样本一次。

    例如,如果你有一个包含1000个样本的训练集,那么一个epoch就是模型对这1000个样本进行一次前向传播和一次反向传播。

    在训练深度学习模型时,通常需要进行多个epoch,因为一次通过所有的训练数据可能不足以让模型学习到数据中的所有模式。通过多次迭代训练数据,模型可以更好地学习和适应数据。

    需要注意的是,epoch的数量也是一个超参数,需要根据具体的任务和数据来设定。太少的epoch可能会导致模型欠拟合,而太多的epoch可能会导致模型过拟合。

  • Filter,在卷积神经网络(CNN)中,”filter”或”kernel”是一个小的矩阵,用于在图像上进行卷积运算,以检测图像中的特定特征,如边缘、线条和纹理等。

  • bias,在神经网络中,”bias”是一个额外的参数,它与每个神经元的输入无关,但会加入到神经元的总输入中。偏置项可以看作是神经元的阈值:只有当输入的加权总和超过这个阈值时,神经元才会被激活。偏置项可以提高模型的灵活性,使其能够更好地拟合数据。

  • 损失函数(也被称为代价函数或误差函数)是一个用于衡量机器学习模型预测结果与真实值之间差距的函数。换句话说,它度量了模型的预测错误程度。在训练过程中,我们的目标是最小化这个损失函数。

    损失函数的选择取决于你正在解决的具体问题。例如,对于回归问题(预测一个连续的输出),常见的损失函数是均方误差(Mean Squared Error,MSE),它计算的是模型预测值和真实值之间差值的平方的平均值。对于分类问题(预测一个离散的输出),常见的损失函数是交叉熵损失(Cross-Entropy Loss),它度量的是模型预测的概率分布与真实的概率分布之间的差距。

    损失函数是机器学习中的一个核心概念,因为它定义了我们的优化目标。通过优化算法(如梯度下降),我们可以调整模型的参数以最小化损失函数,从而提高模型的预测性能。

  • 反向传播(Backpropagation)是一种在神经网络中用于训练模型的关键算法。它的主要目标是通过有效地计算梯度来优化损失函数,这个梯度是损失函数相对于模型权重的偏导数。

    反向传播的过程可以分为两个主要步骤:

    1. 前向传播:在这个阶段,输入数据通过网络向前传播,通过每一层的神经元和连接权重,直到生成输出。然后,这个输出与期望的输出(标签)进行比较,计算出损失函数的值。
    2. 反向传播:在这个阶段,算法从输出层开始,向后通过网络,计算损失函数相对于每个权重的偏导数(即梯度)。这个过程是通过链式法则(Chain Rule)来完成的,链式法则是微积分中的一个基本原则。

    这些梯度然后被用于更新网络的权重,通常是通过一种叫做梯度下降的优化算法。这个过程在整个训练数据集上重复多次(也就是多个”epoch”),直到模型的性能达到满意的水平或者不再显著提高。

    反向传播是深度学习中的一个核心算法,使得训练深度神经网络成为可能。

  • 激活函数在神经网络中起着非常重要的作用。它们被应用于神经元的输出上,以引入非线性因素,使得神经网络能够学习并执行更复杂的任务。

    如果没有激活函数,无论神经网络有多少层,它都只能表示线性变换,这大大限制了网络的表达能力。通过引入非线性激活函数,神经网络可以学习并表示更复杂的模式。

    以下是一些常见的激活函数:

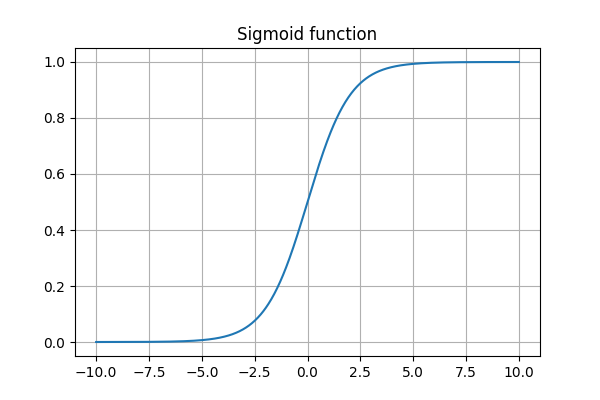
    1. Sigmoid函数:Sigmoid函数可以将任何值转换为0到1之间的值,使其可以用于输出层,以表示概率。但是,Sigmoid函数在输入值的绝对值很大时,梯度接近于0,这可能导致梯度消失问题。Sigmoid函数是一类函数而不是一个函数,意为“S型”,我们最常用的Sigmoid函数是$f(x) = \frac{1}{1 + e^{-x}}$。

    image-20240509211312083

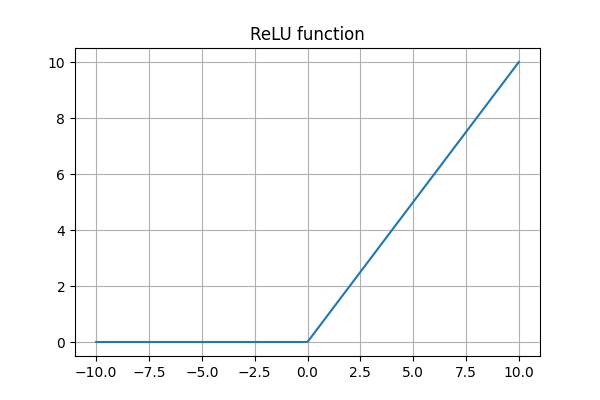
    1. ReLU(Rectified Linear Unit)函数:ReLU函数在输入值为负时输出0,在输入值为正时输出输入值本身。ReLU函数简单且计算效率高,但是在输入值为负时,梯度为0,可能导致神经元”死亡”。

    image-20240509211350318

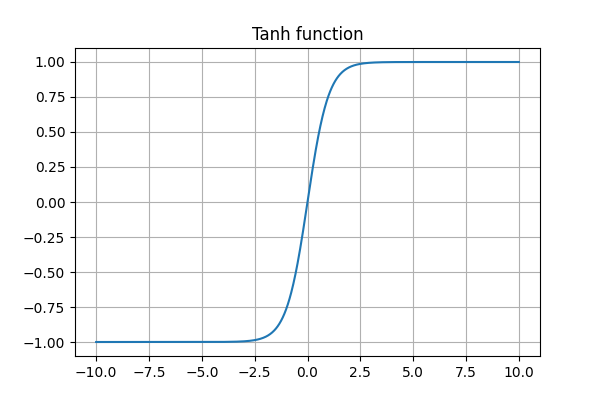
    1. Tanh函数:Tanh函数可以将任何值转换为-1到1之间的值,比Sigmoid函数的输出范围更广。但是,Tanh函数也存在梯度消失的问题。

    image-20240509211432202

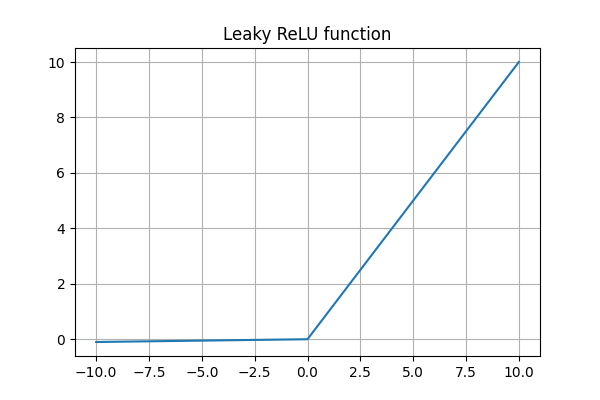
    1. Leaky ReLU函数:为了解决ReLU函数的”死亡”神经元问题,Leaky ReLU在输入值为负时,会有一个小的正斜率。

    image-20240509211609072

    1. Softmax函数:Softmax函数可以将一组值转换为概率分布,常用于多分类问题的输出层。

    选择哪种激活函数取决于具体的应用和网络结构。

2. 安装CUDA与cuDNN

虽然cpu也可以训练,但是有gpu不用白不用,效率还更高

2.1. 安装CUDA

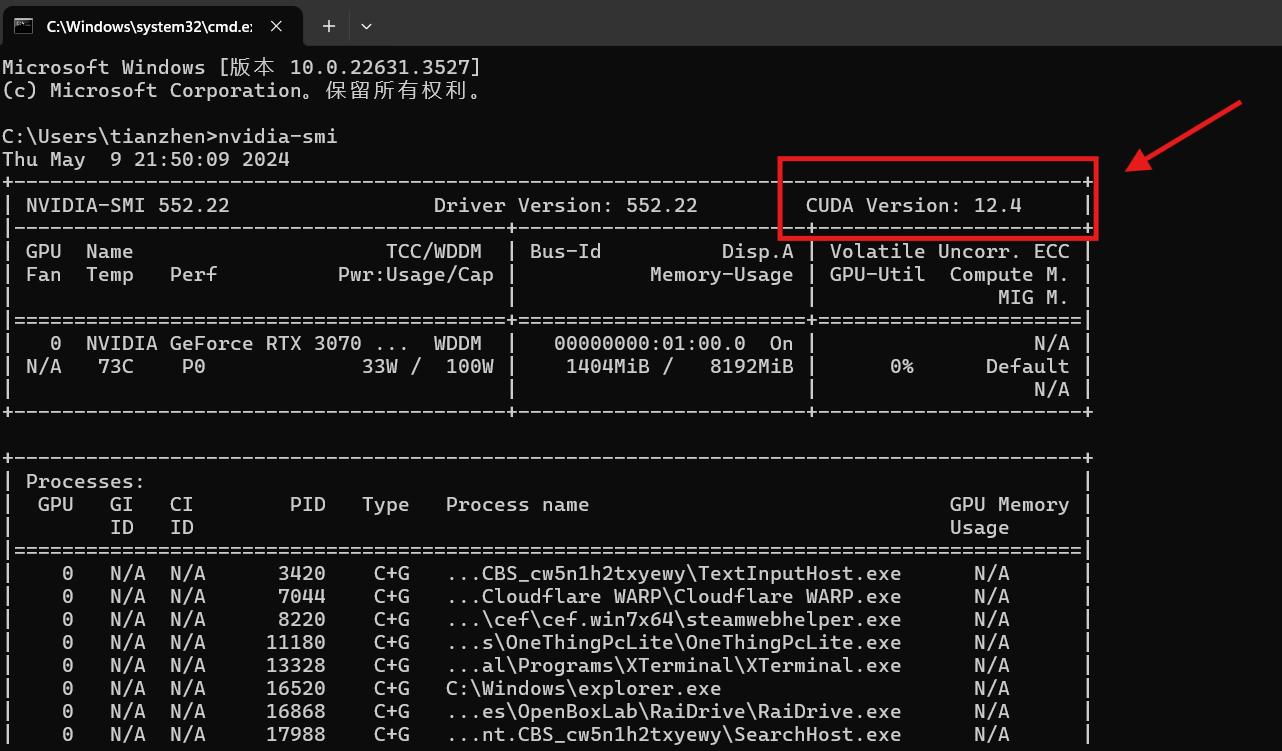
首先确保有一个Nvidia独显,在cmd中输入

1
nvidia-smi

image-20240509215822771

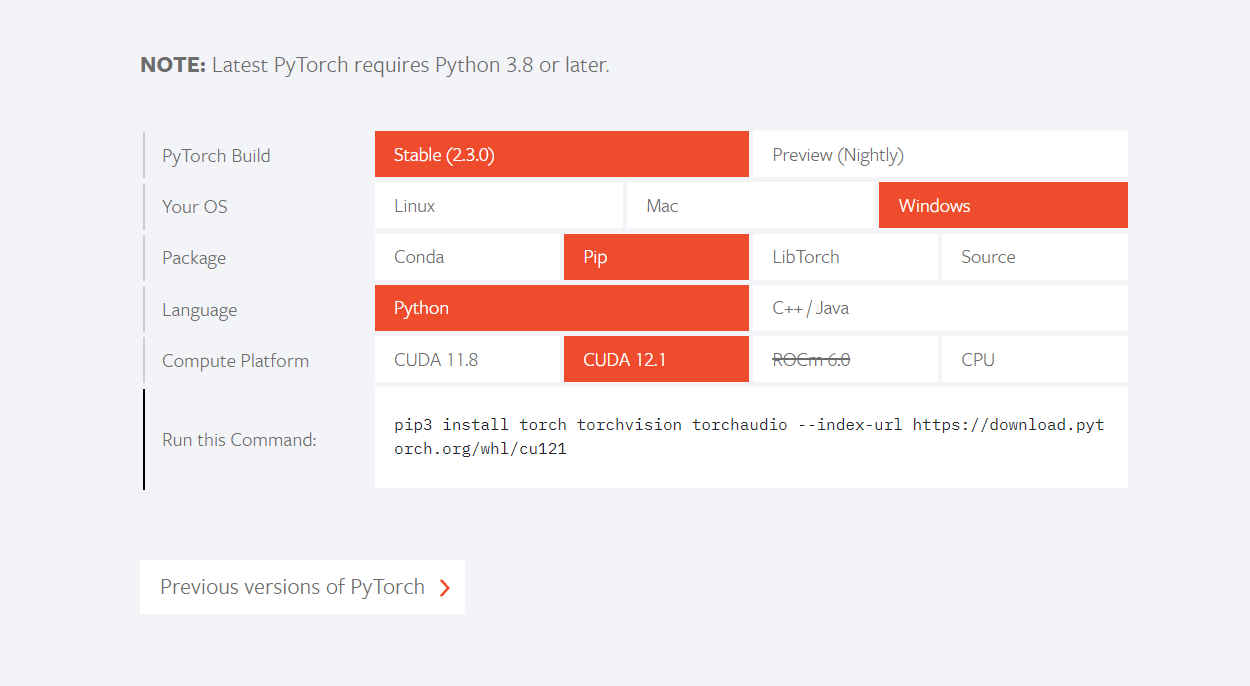
这里显示的版本是当前显卡支持的最高版本,但是我看PyTorch好像还没有适配12.4版本的CUDA,PyTorch官网支持到12.1版本,所以我们安装12.1的:

image-20240509220129278

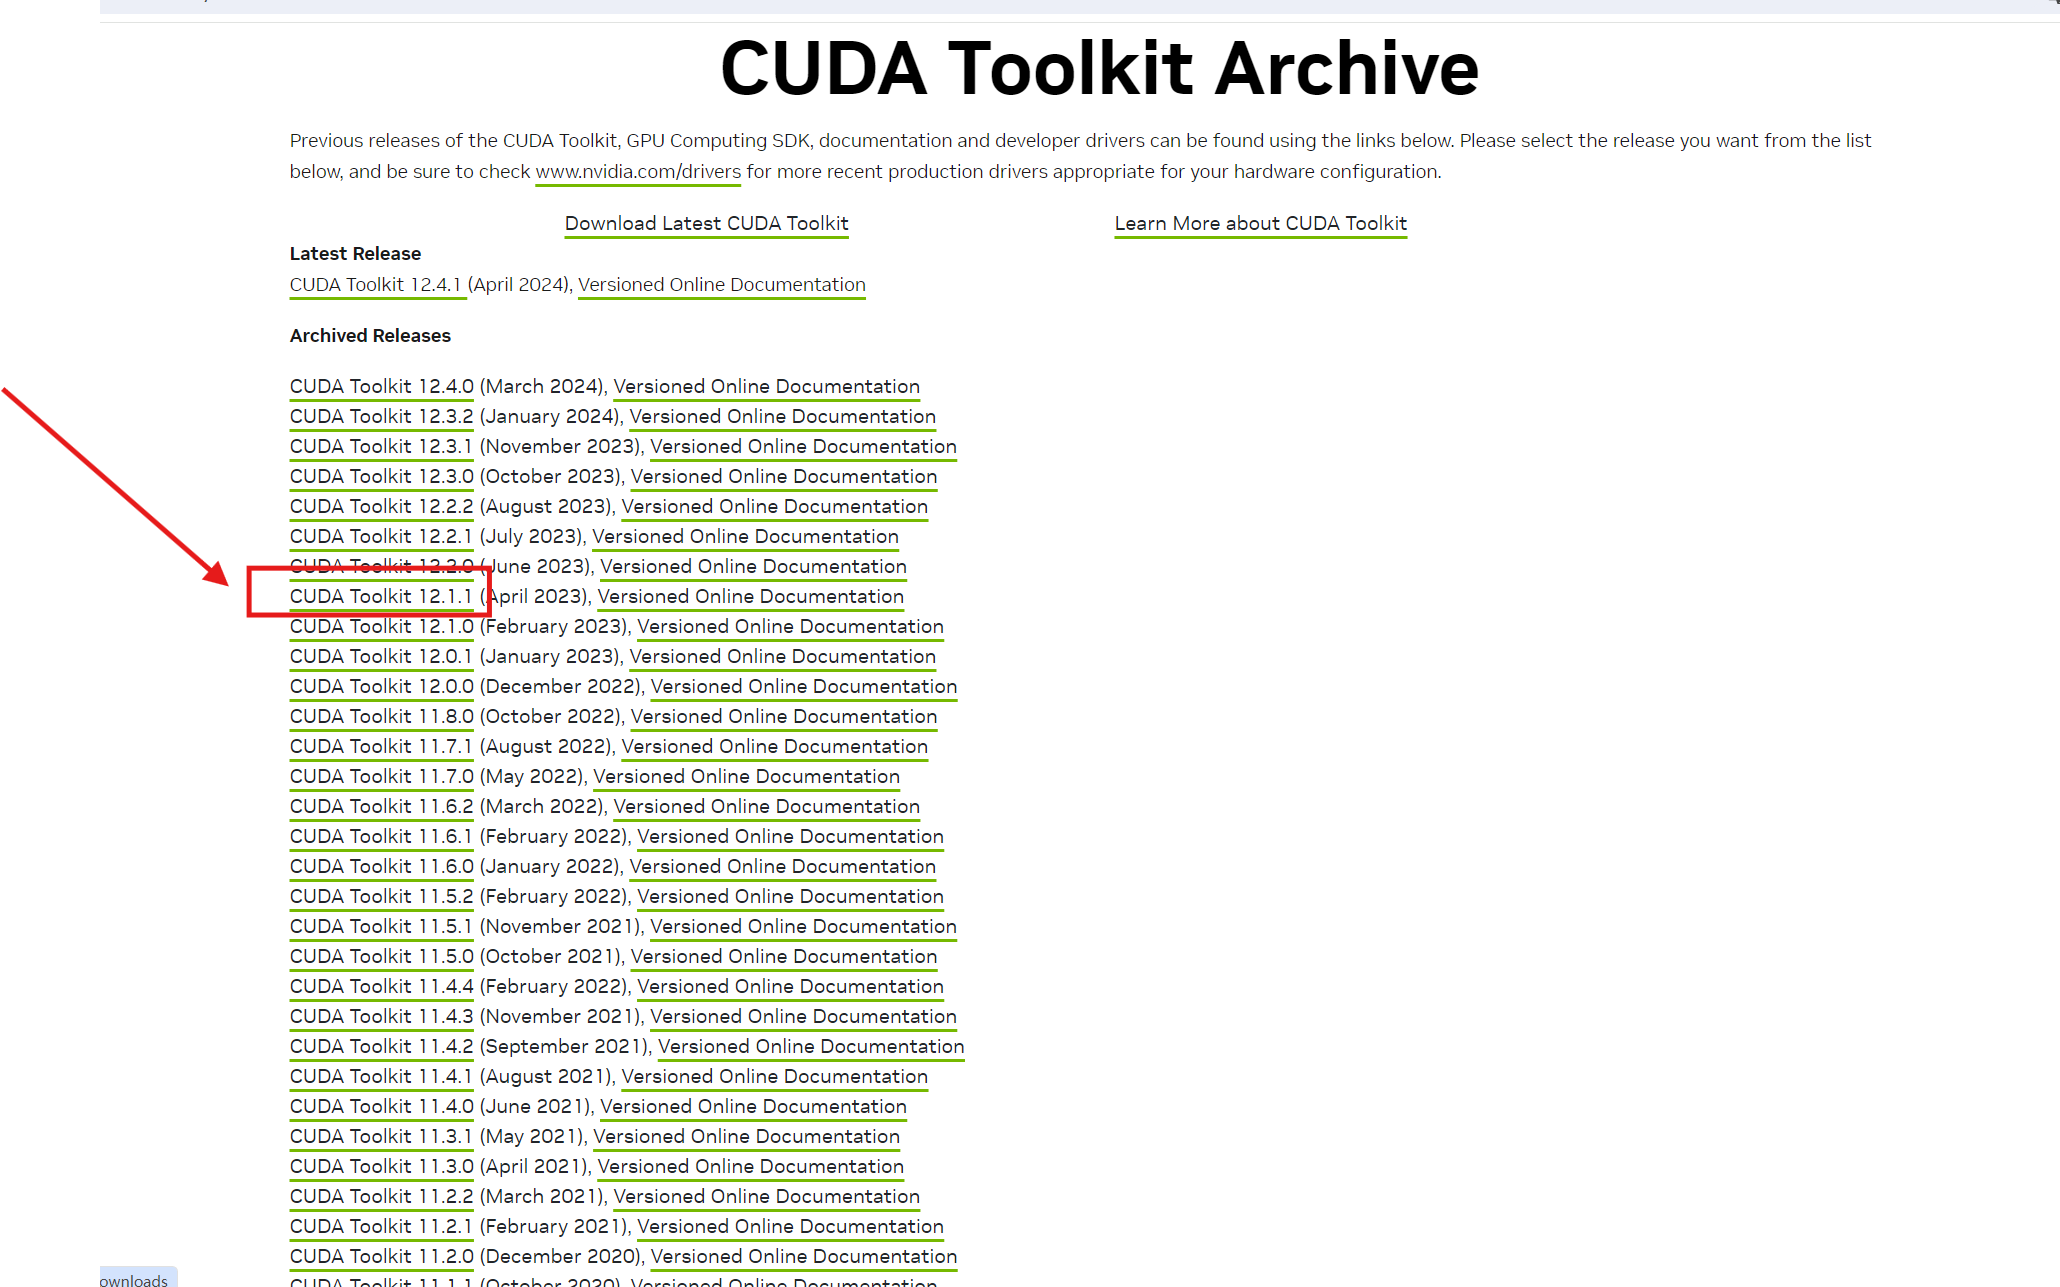
打开CUDA Toolkit Archive | NVIDIA Developer,我们下载12.1.1版本:

image-20240509220942991

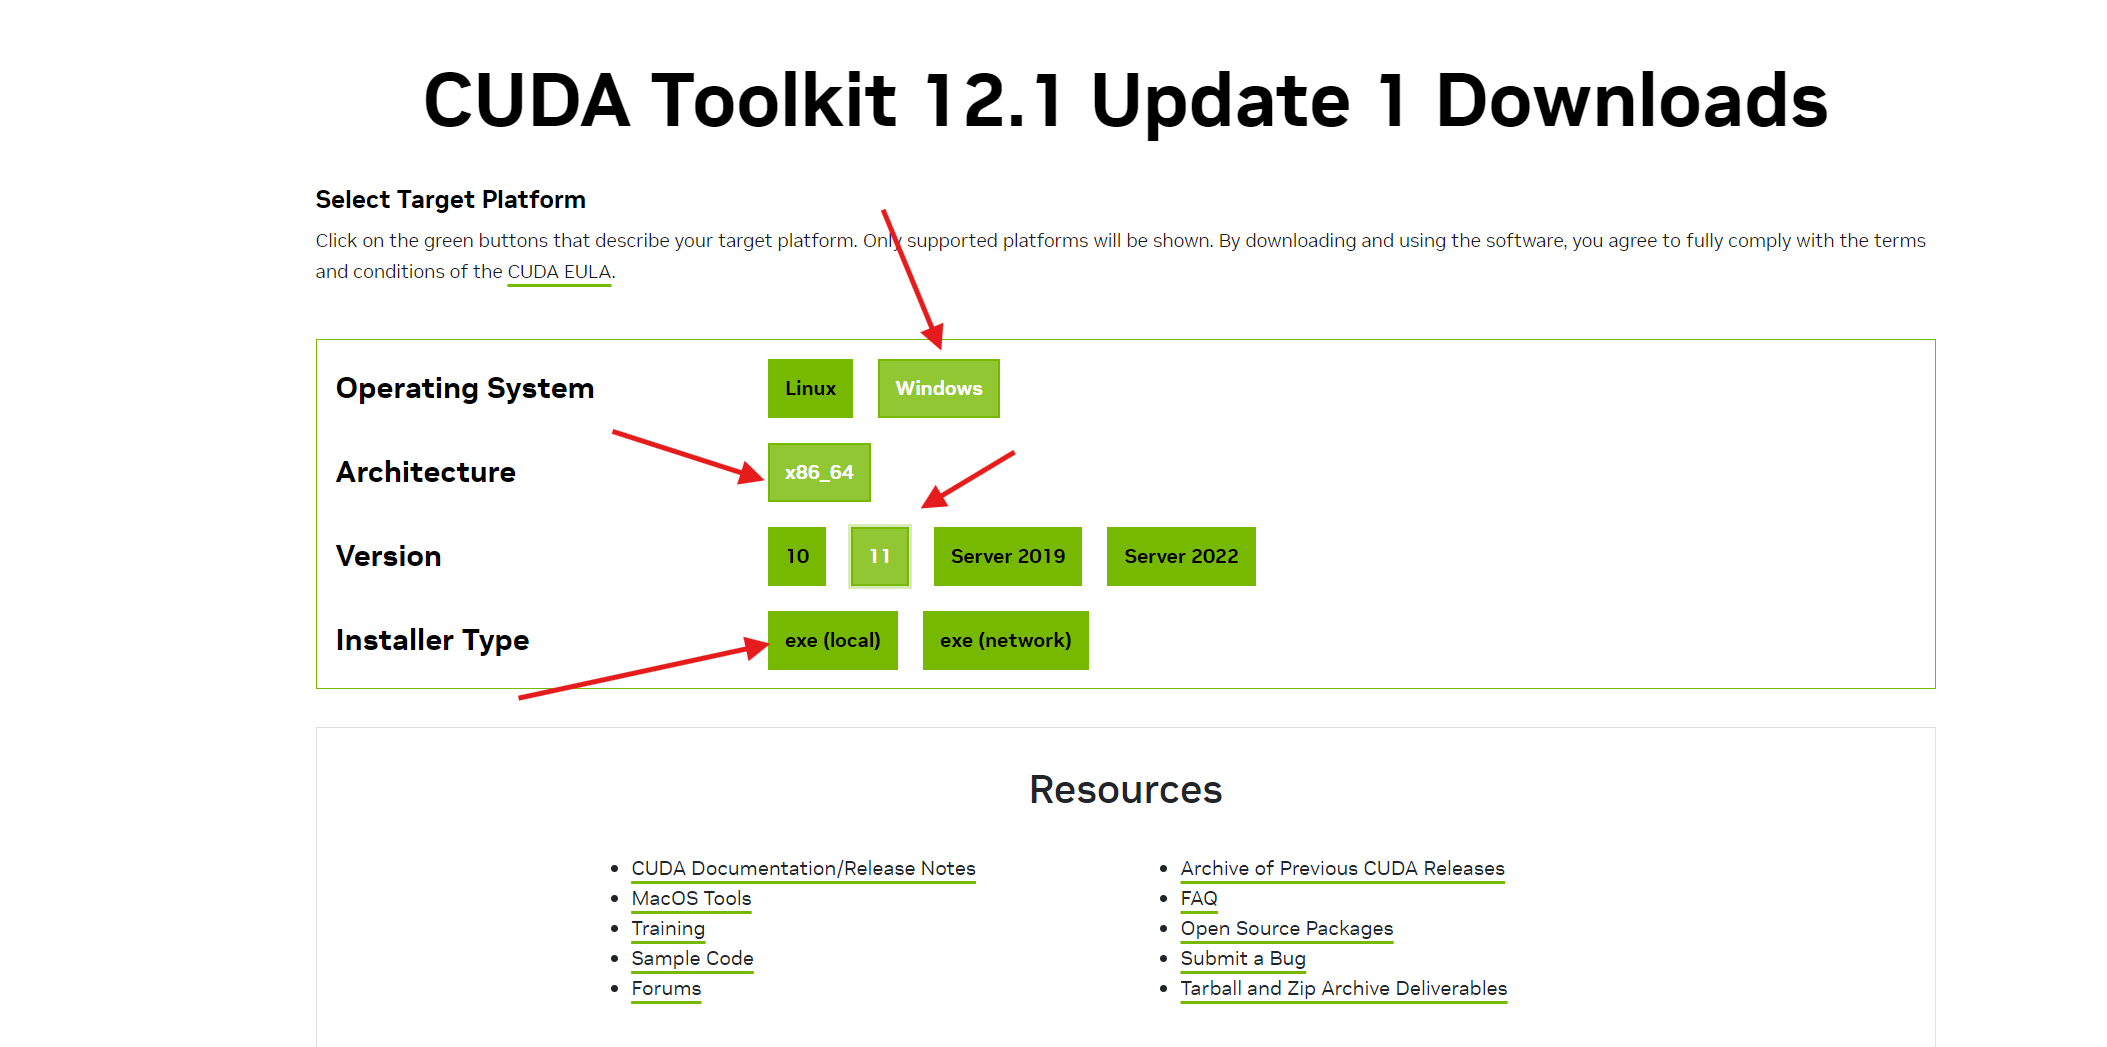
image-20240509221125473

根据自己的需求下载。

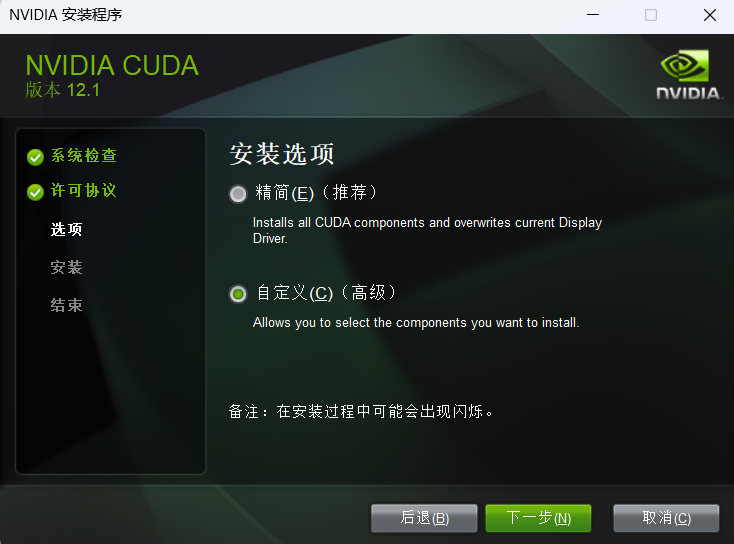
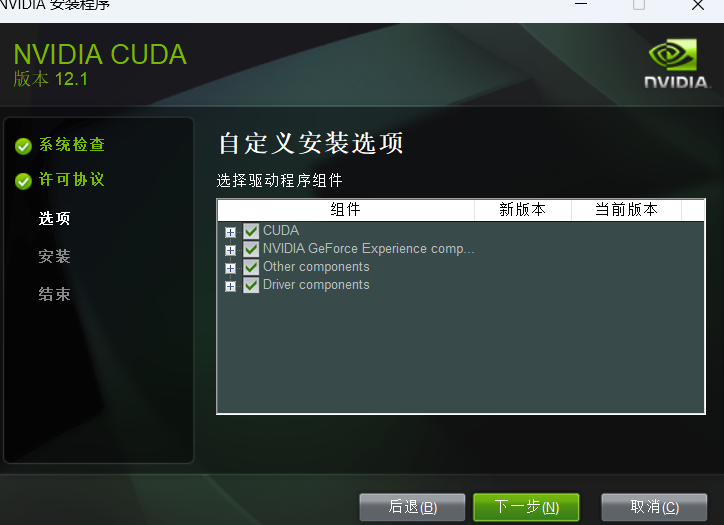
然后点击自定义,一般全部安装就行:

image-20240509221342208

image-20240509221355652

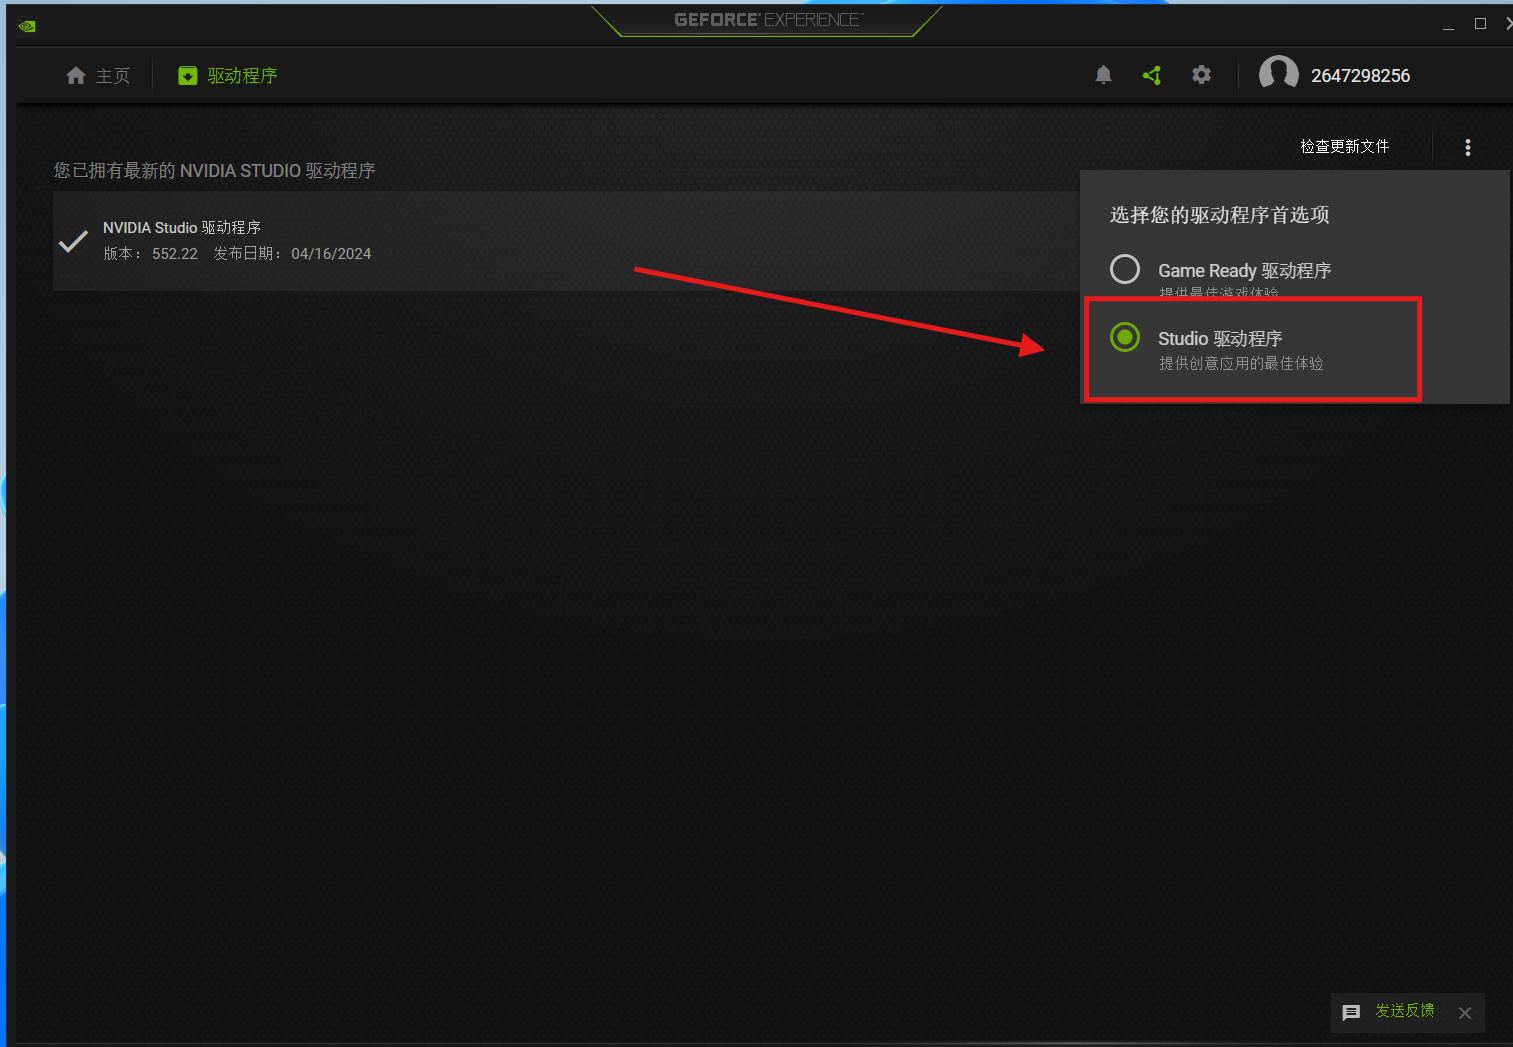
然后打开Nvidia Experience,更新驱动到最新版

image-20240509221509950

因为我之前下载过,没有这个软件的可以去下载。

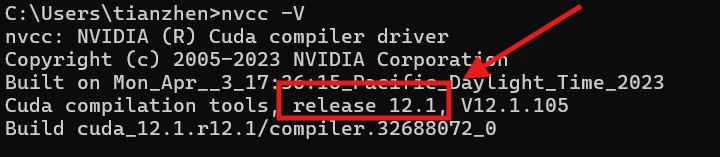
安装完成之后在cmd中输入

1
nvcc -V

image-20240509223038314

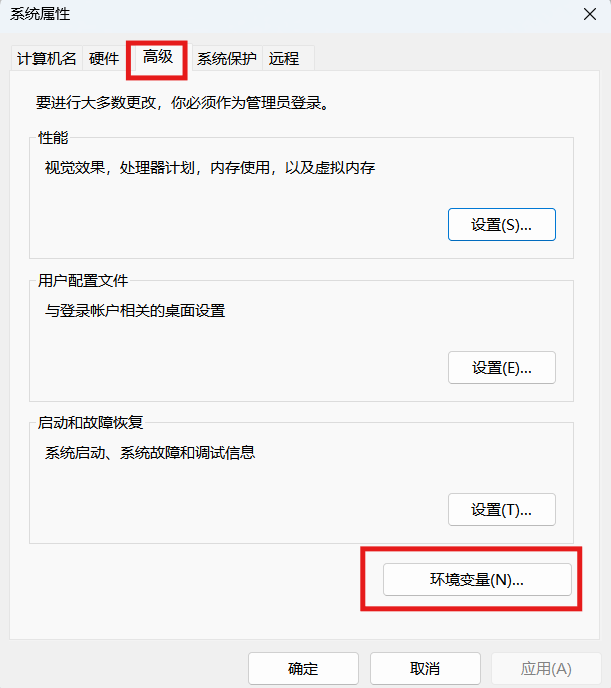
看到版本信息说明安装成功,如果没有输出这个可能是环境变量的问题:

打开系统属性:

image-20240509223423735

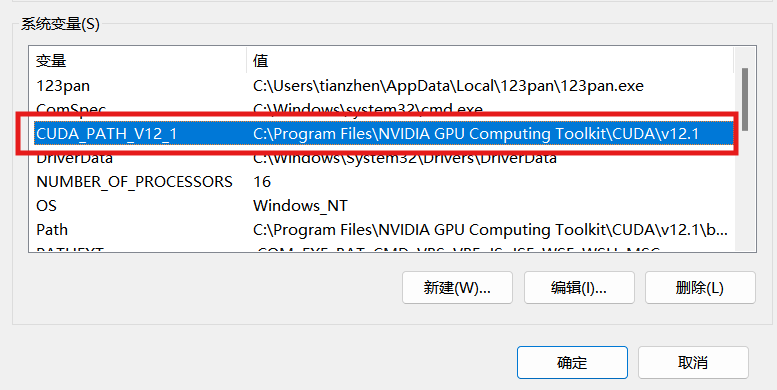
看看系统变量里是否有这个变量:

image-20240509223518076

没有就手动添加一下,正常情况下安装就会自动设置环境变量。

2.2. 安装cuDNN

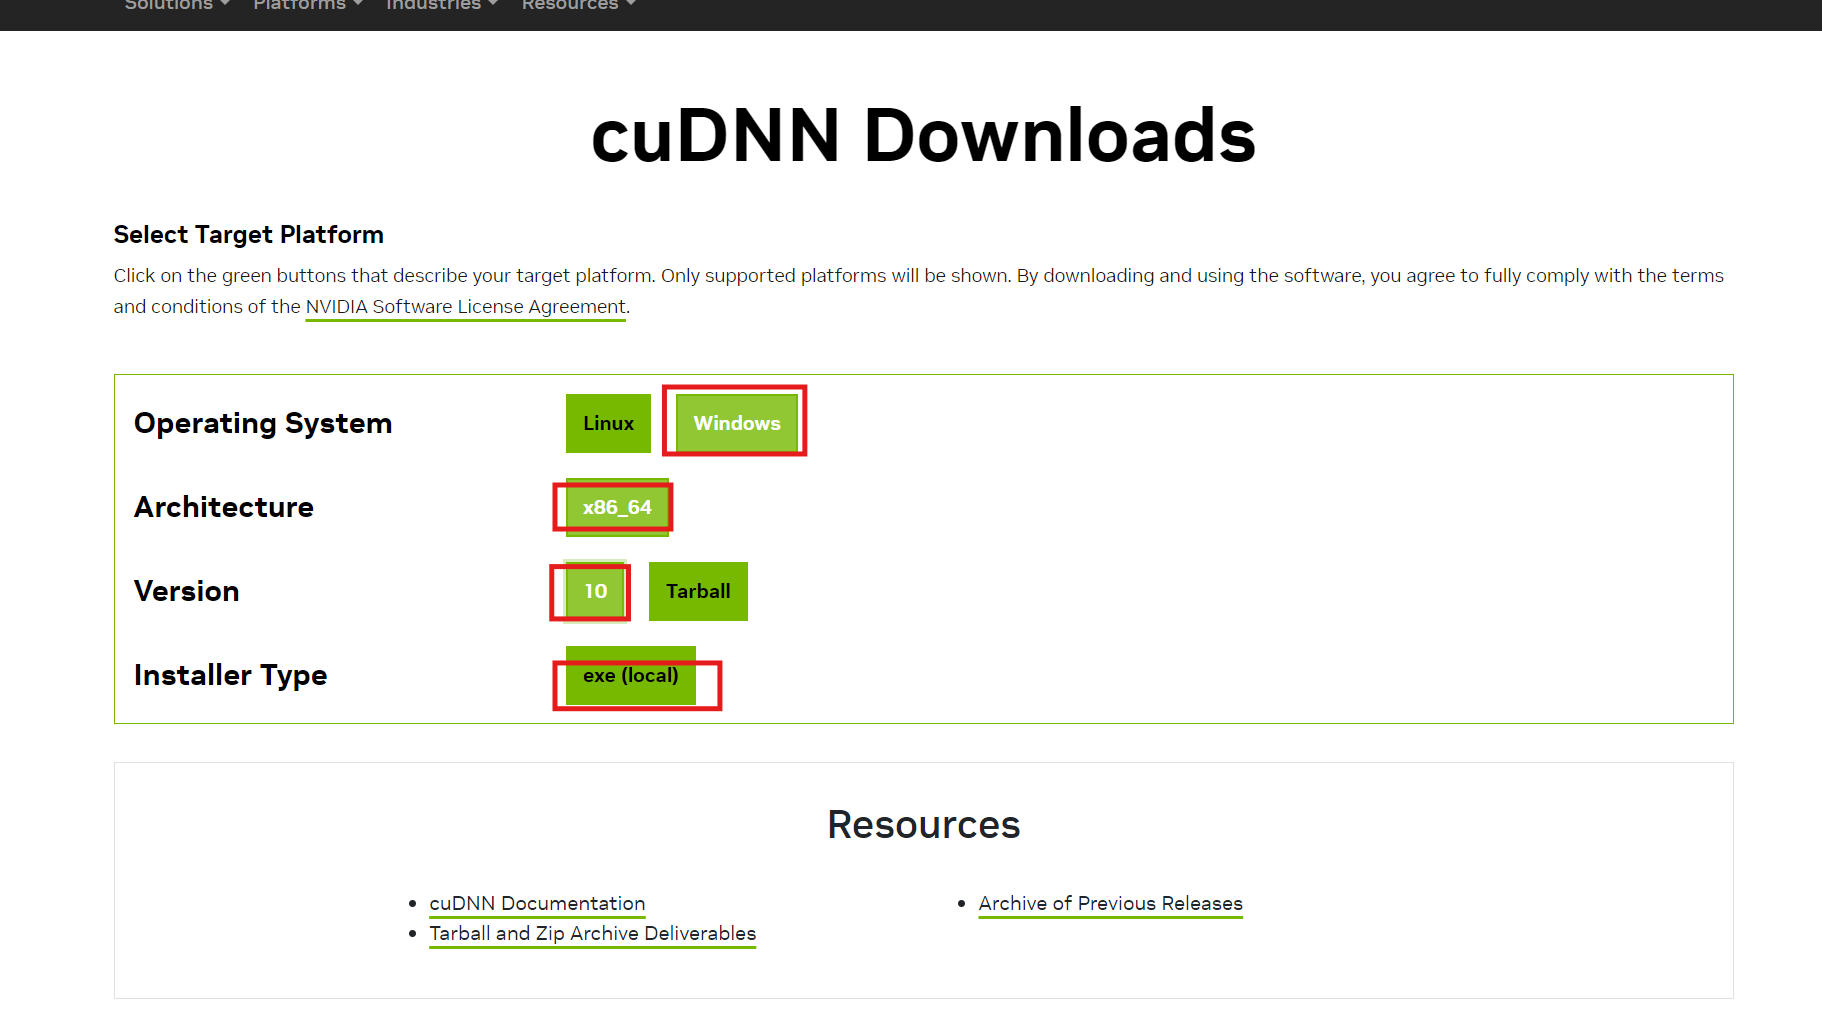
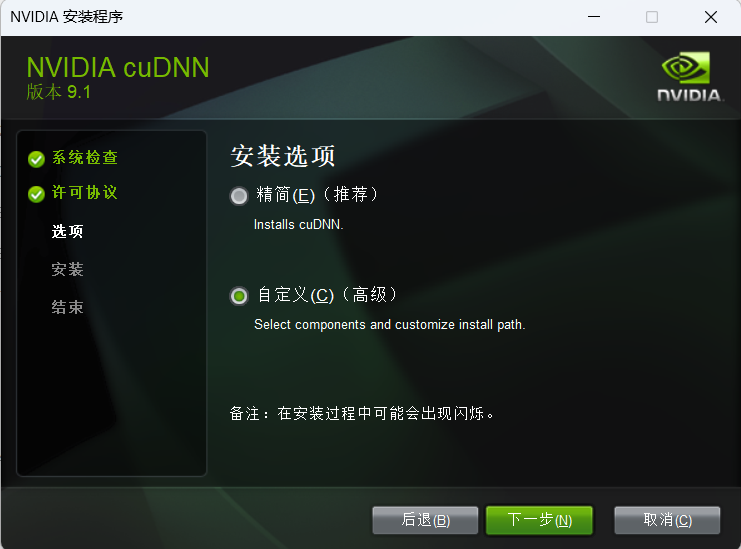
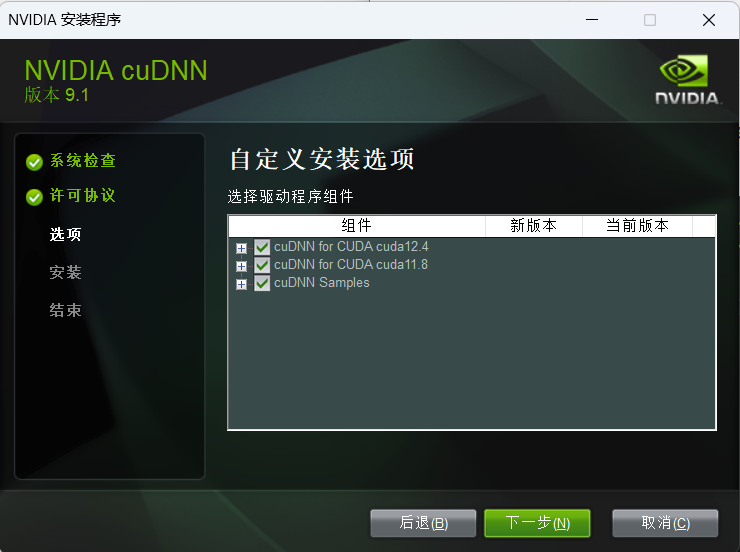
安装cuDNN可以加速,新版本的cuDNN已经不需要手动配置环境变量,直接下载exe版本一步一步安装即可。

image-20240509224002175

image-20240509224640481

image-20240509224659280

我个人喜欢全部安装,自己按需选择。

验证是否安装成功,在这个目录下执行cmd:

image-20240509225300857

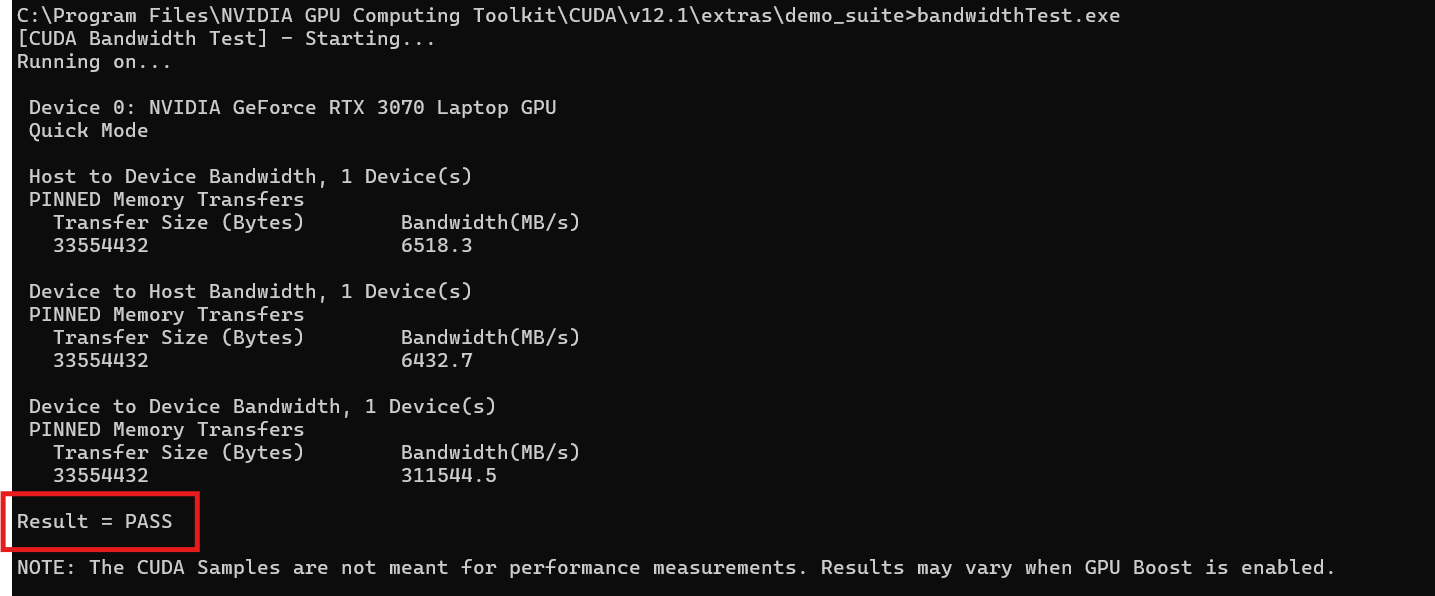
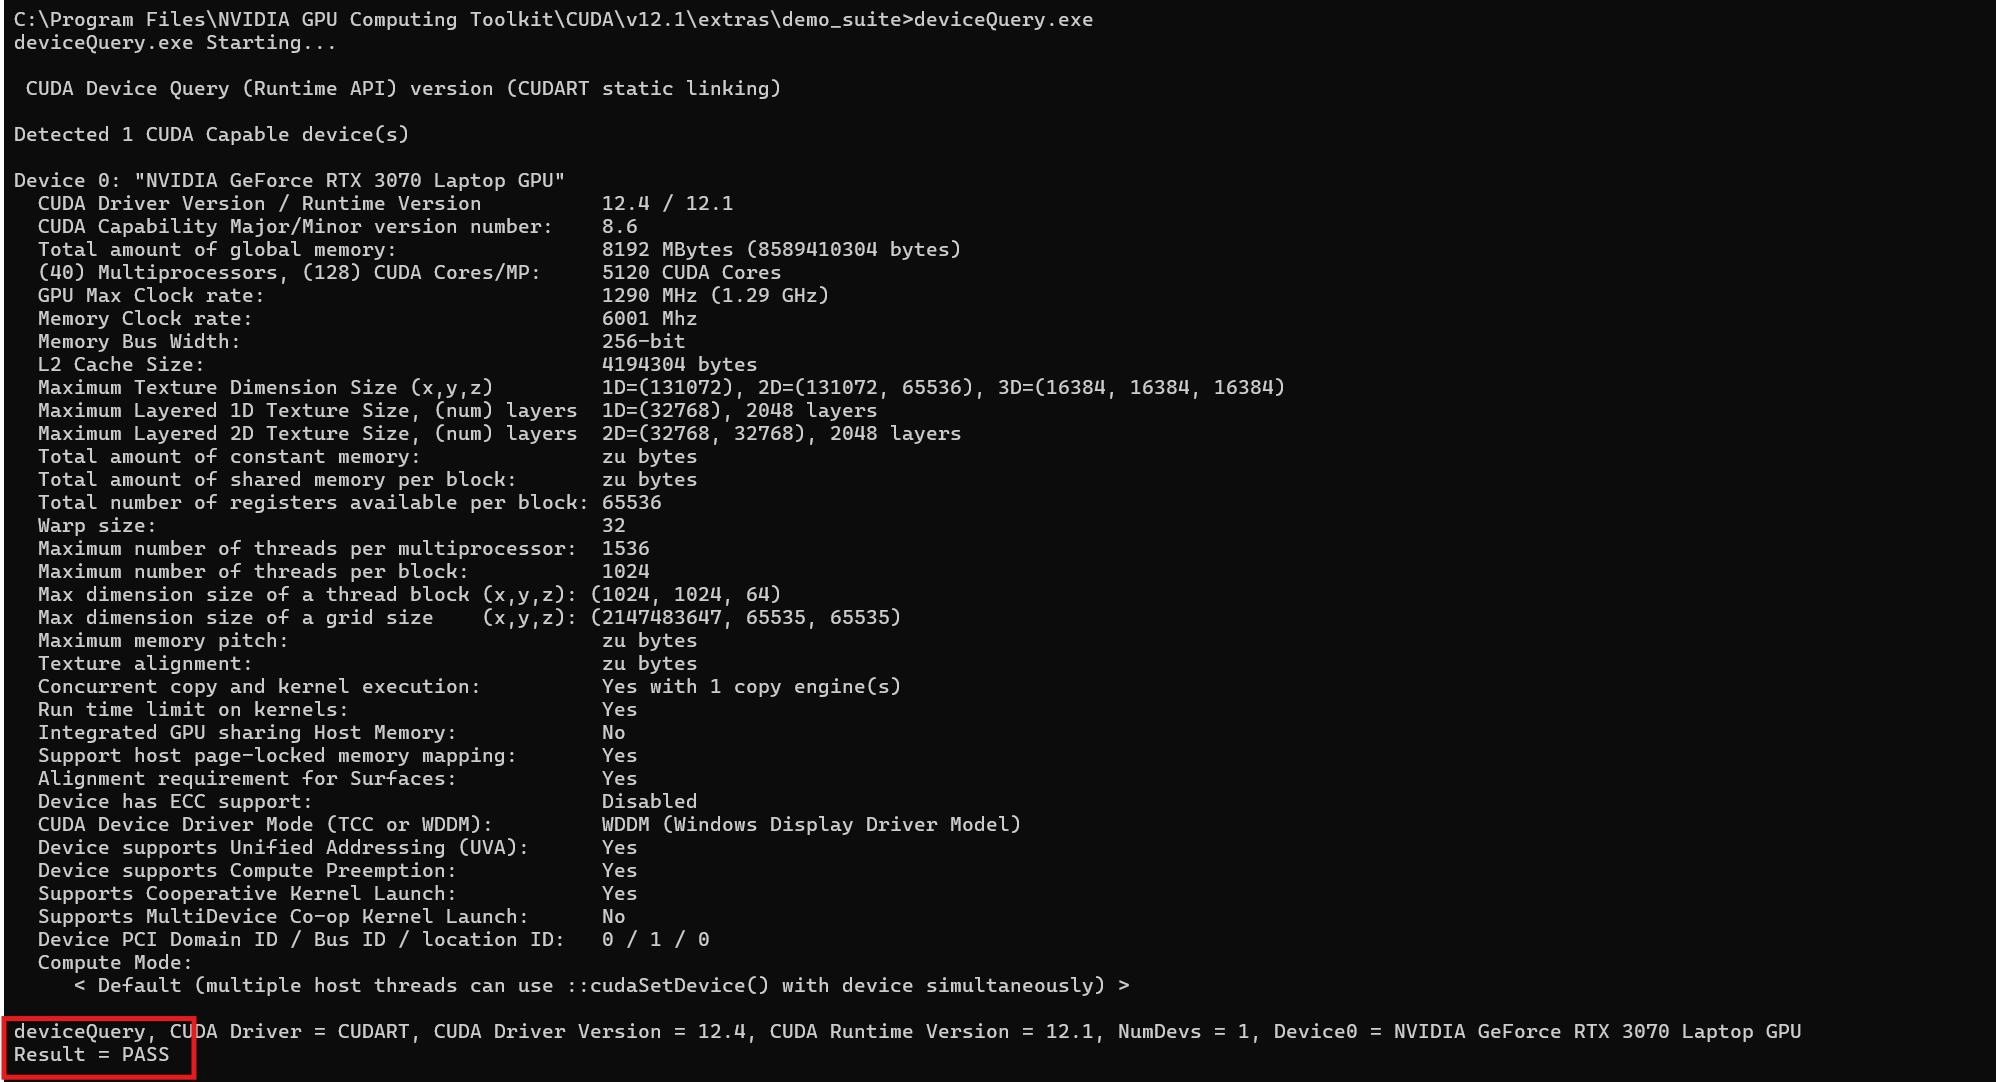
输入bandwidthTest.exe和deviceQuery.exe,分别看到PASS就说明安装成功:

image-20240509225520925

image-20240509225549038

3. 安装PyTorch CUDA版本

在PyCharm中,导入torch默认是导入cpu的版本

可以运行这段代码

1
2
import torch
print(torch.__version__)

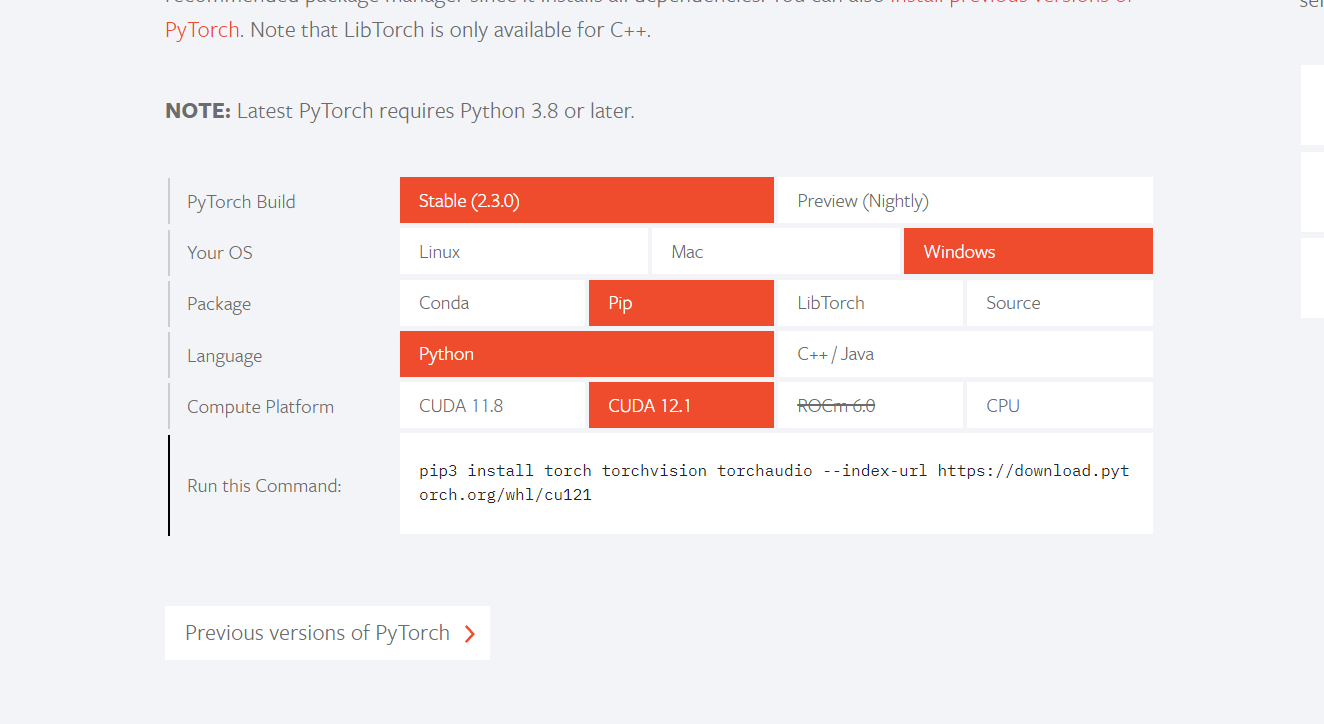
如果版本后缀是cpu就说明安装的是cpu版本,我们需要CUDA版本的PyTorch,依据PyTorch官网的安装方式,推荐使用pip或者在Anaconda中安装,注意自己的CUDA版本:

image-20240509230938890

理论上pip是最快的,但是在下载中经常出现中断,可以使用中国大陆的镜像或者使用代理安装,如果都不能安装成功也可以手动下载whl安装。

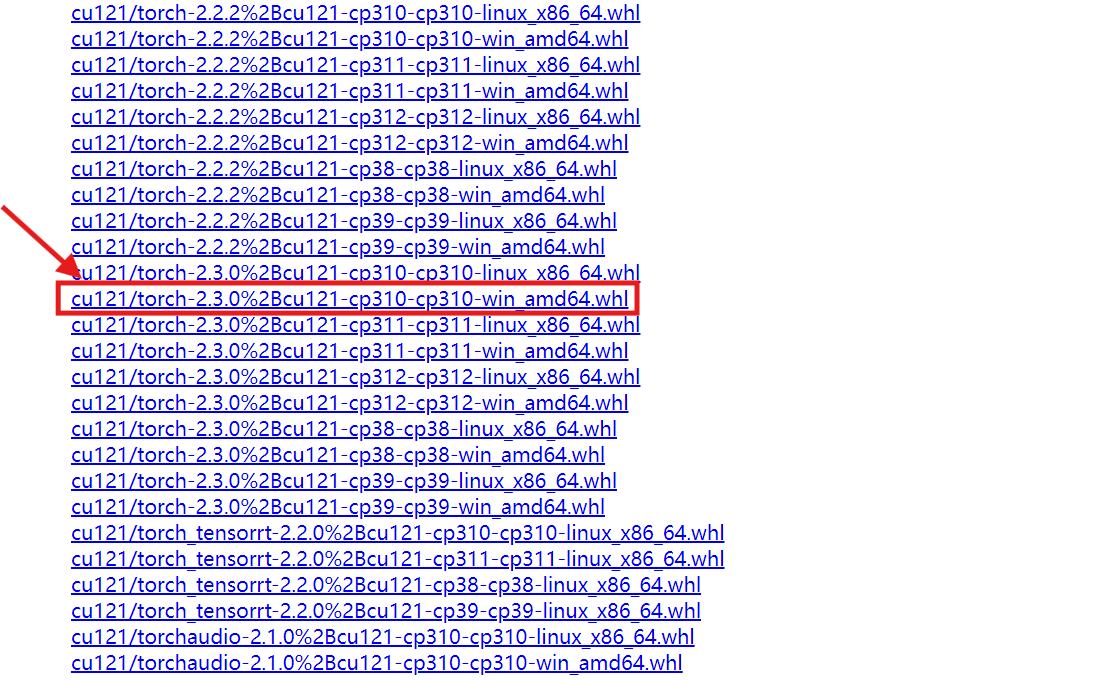
在这个页面,下载相应的版本:

image-20240509233754857

前面的cu121表示CUDA12.1版本,后面的cp310表示3.10的python版本,后面表示win,amd64,选择适合自己的版本。

然后拖动到项目目录下用pip install安装。

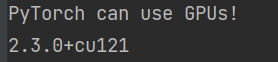
在PyCharm中验证

1
2
3
4
5
6
7
8
import torch

if torch.cuda.is_available():
print("PyTorch can use GPUs!")
else:
print("PyTorch cannot use GPUs.")

print(torch.__version__)

image-20240509234136188

然后就大功告成了。

4. 原理

4.1. 神经网络概述

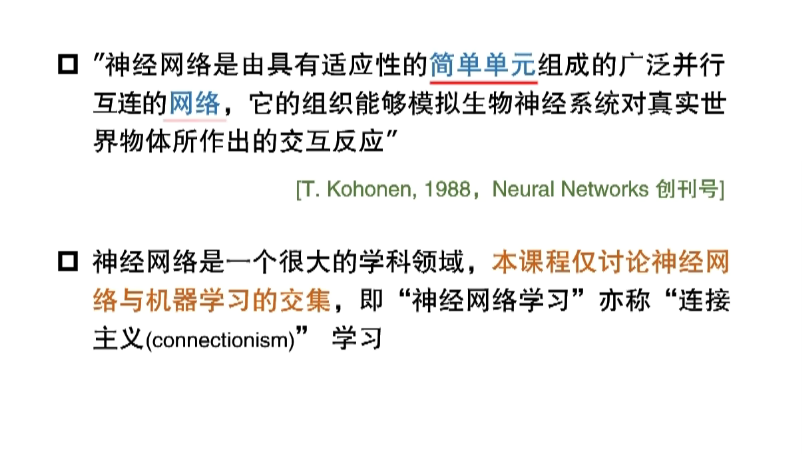
本节内容引用周志华老师的课件

4.1.1. M-P神经元模型

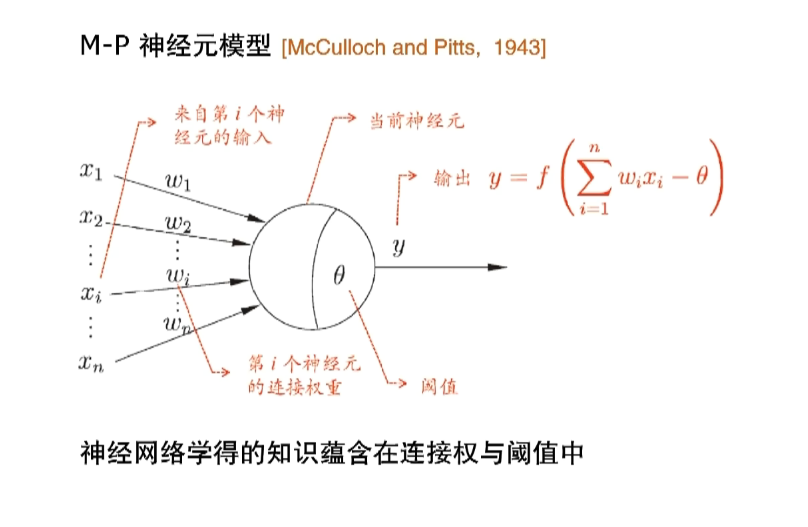
“MP神经元”是指McCulloch-Pitts神经元,这是一种最早的、最简单的人工神经元模型。它是由Warren McCulloch和Walter Pitts在1943年提出的,因此得名。

还记得生物学中的神经元是怎么工作的吗:

  1. 接收信号:神经元通过其树突(一个或多个分支状的结构)接收来自其他神经元的信号。这些信号是化学物质,称为神经递质,它们从其他神经元的突触(神经元之间的连接点)释放出来。
  2. 整合信号:神经元的细胞体(含有细胞核的部分)将接收到的所有信号进行整合。如果这些信号的总和超过了一个特定的阈值,那么神经元就会被激活。
  3. 传递信号:一旦神经元被激活,就会在其轴突(从细胞体延伸出的长线状结构)上产生一个电信号,称为动作电位。动作电位会沿着轴突向下传播,直到达到轴突的末端。
  4. 信号传输:在轴突的末端,动作电位会导致神经递质的释放。这些神经递质会穿过突触间隙,然后与接收神经元的突触后膜上的受体结合,从而传递信号给下一个神经元。

机器学习中的神经元借鉴了生物学中的概念

对于每一个神经元,$x_i$为输入值,$w_i$是对应的权重,$\theta$是阈值(threshold),如果所有$wix_i$之和大于$\theta$,该神经元就被激活,即$f$函数(激活函数)生效。所以最终的输出为:

$$y=f(\sum\limits_{i=1}^{n} w_ix_i-\theta)$$

4.1.2. 激活函数

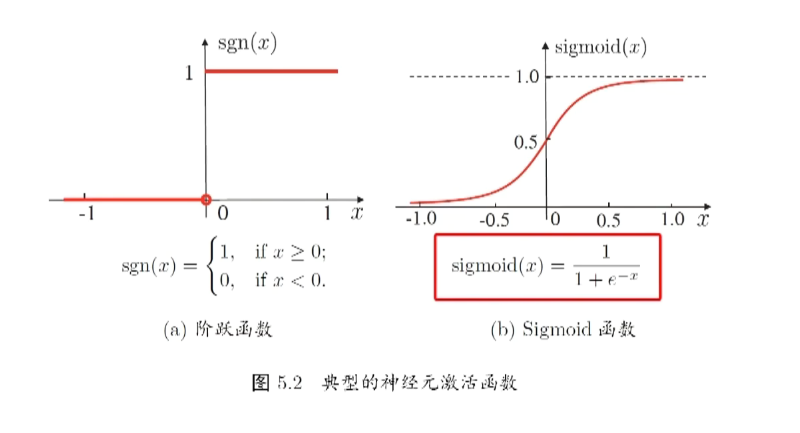
Activation function,也叫响应函数或者挤压函数(Squeeze function)

所谓响应也就是给一个输入值得到输出值,挤压函数指的是给一个$(-\infty, \infty)$的值,挤压到$(0,1)$之间,如下图(b)所示。

  • 理想激活函数是阶跃函数,$0$表示抑制神经元而$1$表示激活神经元。
  • 阶跃函数具有不连续、不光滑等不好的性质,常用的是Sigmoid函数。

image-20240510141705166

特别的,对于最常见的Sigmoid函数$f(x) = \frac{1}{1 + e^{-x}}$,有这样的特性:

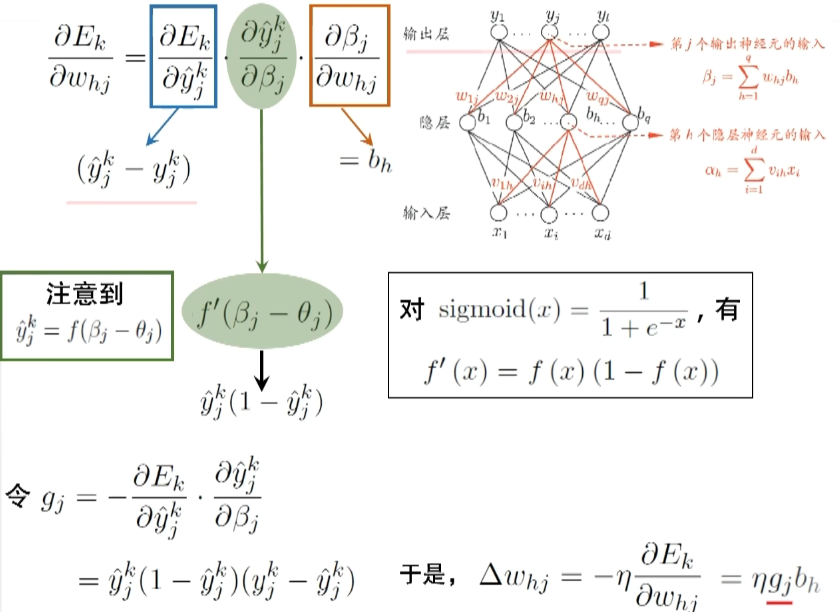
$$f’(x)=f(x)·(1-f(x))$$

那么$f(x)$可以理解为正的概率,$(1-f(x))$可以理解为负的概率,这对我们后面理解BP有帮助。

4.1.3. 多层前馈网络结构

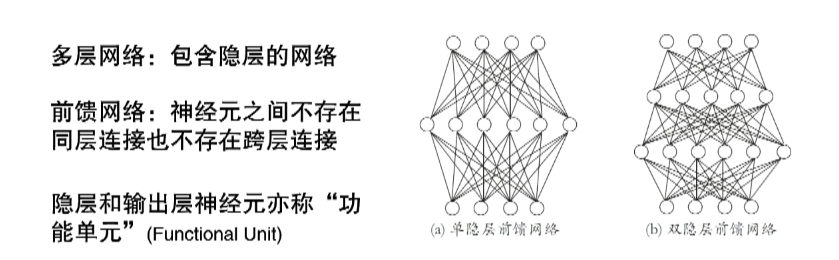
如果这个多层前馈网络结构里面每一个神经元都是一个M-P神经元,我们就得到一个多层前馈神经网络

image-20240510144156637

对于隐层和输出层,才有激活函数的参与,所以也被叫做功能单元。

万有逼近性(universal approximator)

多层前馈网络有强大的表示能力。

仅需一个包含足够多神经元的隐层,多层前馈神经网络就能以任意精度逼近任意复杂度的连续函数

但是,如何设置隐层神经元数是未决问题(Open Problem),实际常用”试错法“。

注意,万有逼近性并非神经网络的独有特性!

4.1.4. BP(BackPropagation:误差逆传播算法)

image-20240510151921398

具体而言,在神经网络中,激活函数被应用在每一层的输出上。具体来说,每个神经元的输出是其输入与权重的线性组合,然后通过激活函数进行非线性转换。这个过程在每一层的每个神经元上都会发生。

例如,假设我们有一个三层的神经网络(输入层、隐藏层和输出层)。在隐藏层,每个神经元的输入是输入层的输出与权重的线性组合,然后这个结果通过激活函数进行非线性转换,得到隐藏层的输出。在输出层,每个神经元的输入是隐藏层的输出与权重的线性组合,然后这个结果再次通过激活函数进行非线性转换,得到最终的输出。

BP算法推导

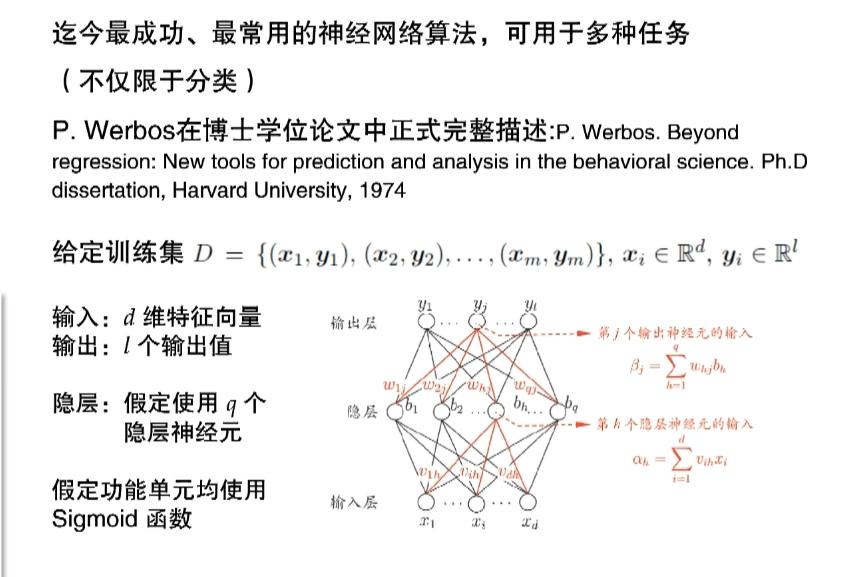
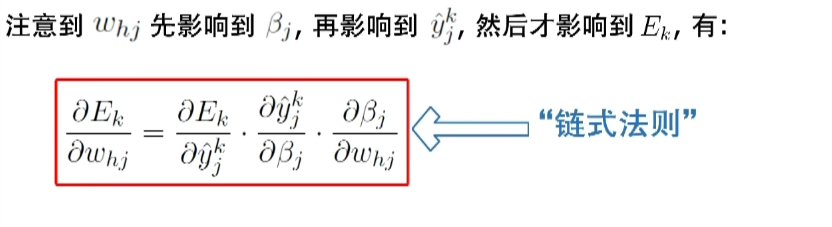
我们把上级的输出与权重的线性组合,叫做这级的输入$\beta$,也就是输出函数$y=f(\sum\limits_{i=1}^{n} w_ix_i-\theta)$里面的$\sum\limits_{i=1}^{n} w_ix_i$,这么叫只是为了后面使公式简洁。

于是我们得到每个神经元上的预测值公式:

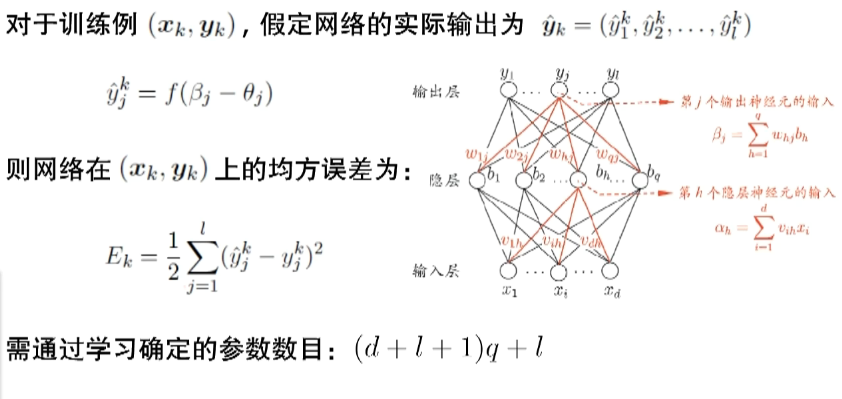
$$\hat{y}_j^k=f(\beta_j-\theta_j)$$

其中$k$表示第$k$个样例,$j$表示第$j$个神经元,$\theta$表示阈值(threshold),$\hat{y}$即预测值。

则整个网络在$(x_k,y_k)$上的均方误差为

$$E_k=\frac{1}{2}\sum\limits_{j=1}^{l}(\hat{y}_j^k-y_j^k)^2$$

取$\frac12$是为了求导之后消去平方,$y$是真实值(ground truth)。

所谓的训练数据就是确定一个模型中的所有参数

对于下图中的网络,输入层有$d$个神经元,隐层有$q$个,输出层有$l$个,则从输出层到隐层有$d·q$个参数,从隐层到输出层有$q·l$个参数,对于功能神经元(隐层和输出层),还有$q+l$个阈值$\theta$(threshold),加起来就是$(d+l+1)q+l$个参数,我们在训练过程中就是要确定这么多个参数。

image-20240510183928932

BP是一个迭代学习算法,在迭代的每一轮中采用广义感知机学习规则(多层前馈也常叫做多层感知机):

$$v\leftarrow{v}+\Delta{v}$$

其中$\Delta{v}$就是调整量,之所以要调整,就是因为有误差。

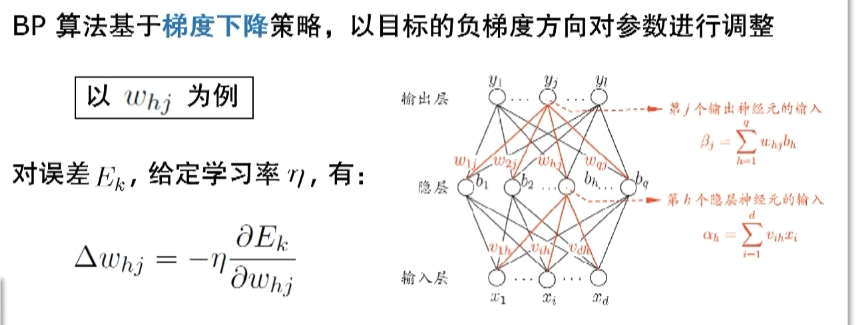
怎么调整呢?

image-20240510192345940

$w_{hj}$是我们要学习的一个参数(某个权重),求偏导是为了确定梯度的方向,$\eta$决定走的步长。

image-20240510194407742

image-20240510195230774

其中$b_h$就是输出层的输入值,$g_j$可以看作输出层的神经元处理。

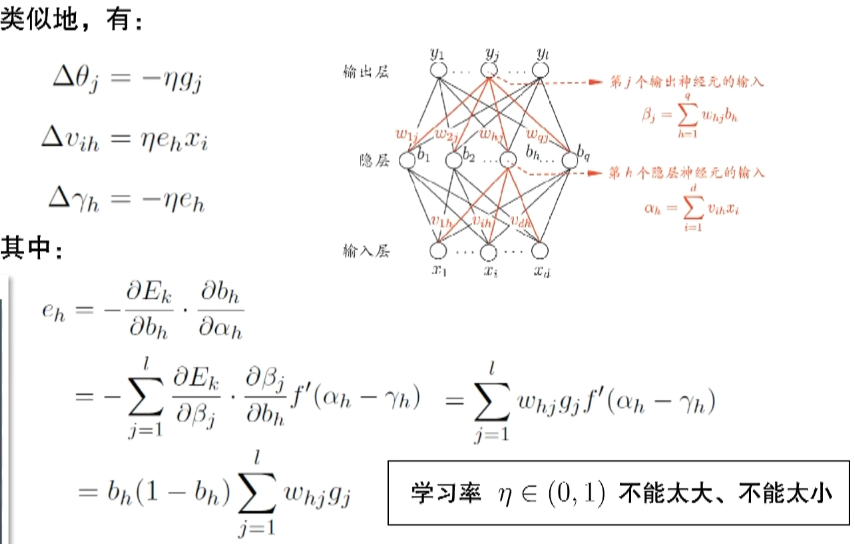
image-20240510200810549

在了解各个参数是怎么调节之后,我们就知道神经网络是怎么训练的:

在输入$x$之后,整个模型会随机初始化一组参数,然后算出$\hat{y}$,然后根据$y$马上就可以算出$E$,然后根据$E$就可以得到$\Delta{w}$、$\Delta{\theta}$、$\Delta{v}$、$\Delta{\gamma}$等调整量,然后让这些值进行调整,然后不断进行这样一轮轮训练,直到$\hat{y}$收敛于$y$附近,我们的参数也随之确定下来。

震荡现象

在预测值不断逼近真实值的过程中,会发生震荡现象,比如时而大于真实值,时而小于真实值,在真实值附近震荡。

但是我们总归有办法让训练过程停止,避免一直震荡下去。比如设置训练的轮数,或者保留一组测试集,在每一轮训练完成之后拿模型在测试集和训练集上的性能做对比,如果差别很大就继续,否则小到一定程度就让它停止。

另外为了避免震荡现象比较严重,$\eta$不能太大,太小也不行,越小就意味着需要更多的训练轮数才能足够收敛。

而且$\eta$本身也可以在训练过程中灵活的调整,以加速收敛,比如训练的初期可以设置较大的$\eta$,然后慢慢减小$\eta$,以确保在收敛附近有较小的$\eta$。

4.2. 卷积原理

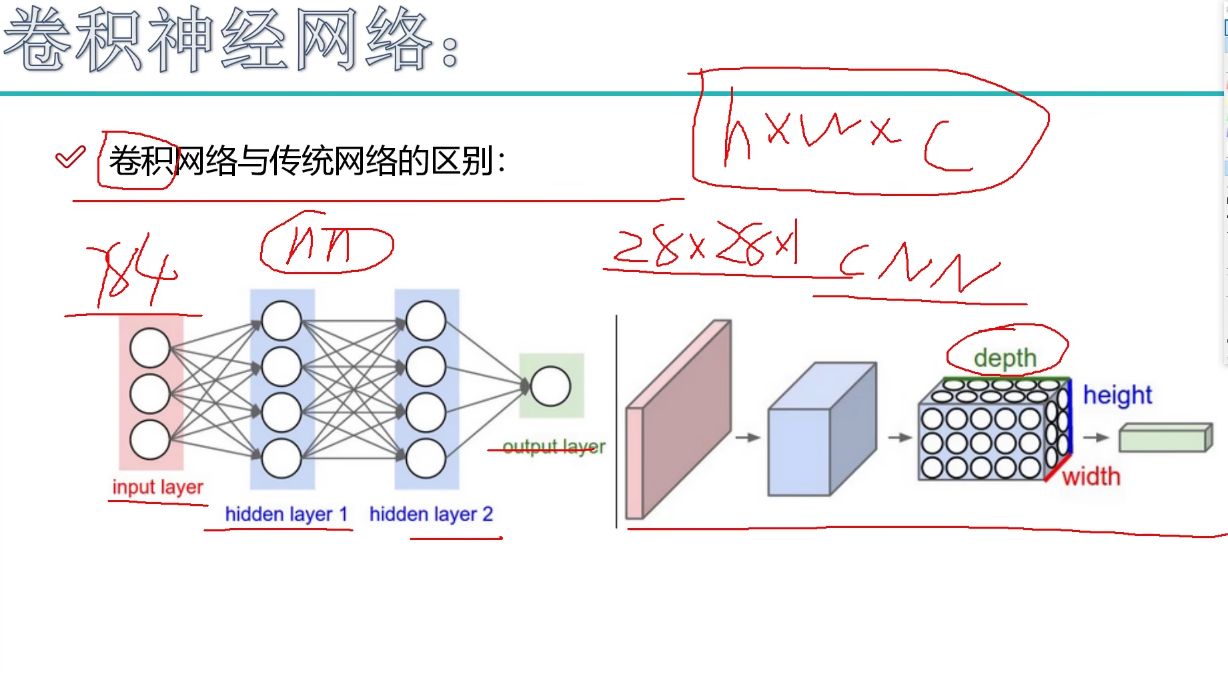
4.2.1. 卷积神经网络与传统神经网络的区别

image-20240510224421818

简而言之,传统神经网络处理的是一维的向量,而CNN处理的是三维的。

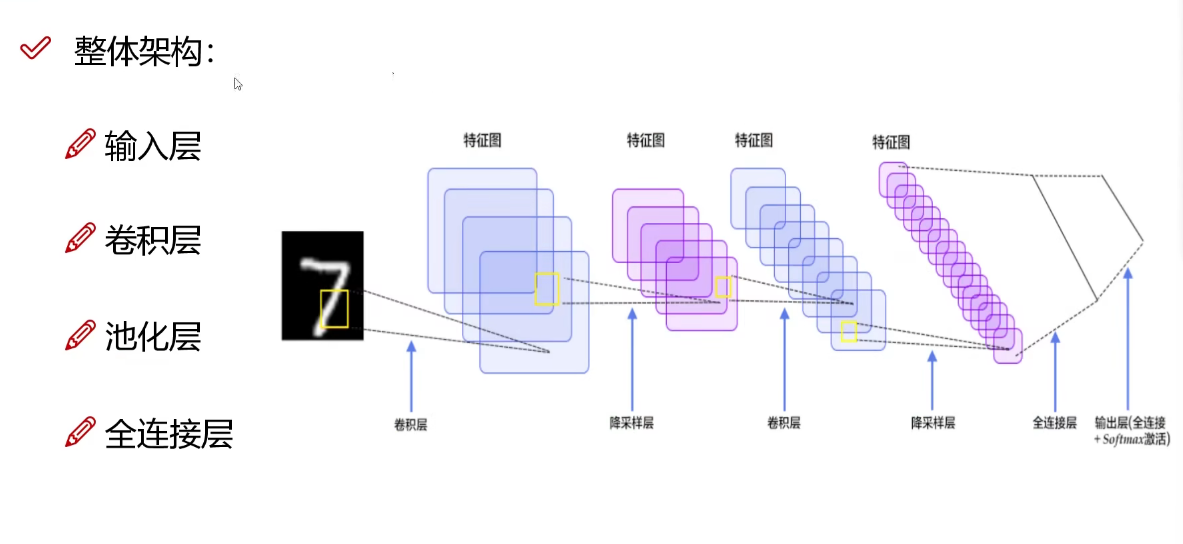
4.2.2. 整体架构

image-20240510224904760

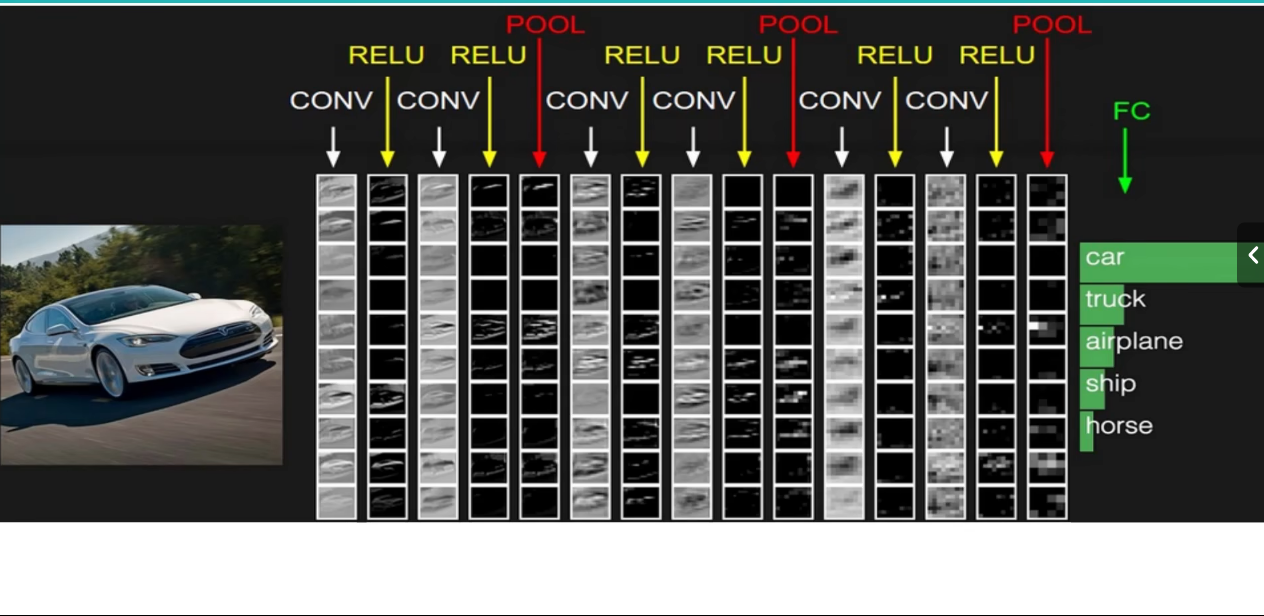
卷积层用来提取特征,池化层用来压缩特征,全连接层用于将卷积和池化层的输出转化为最终的预测结果。

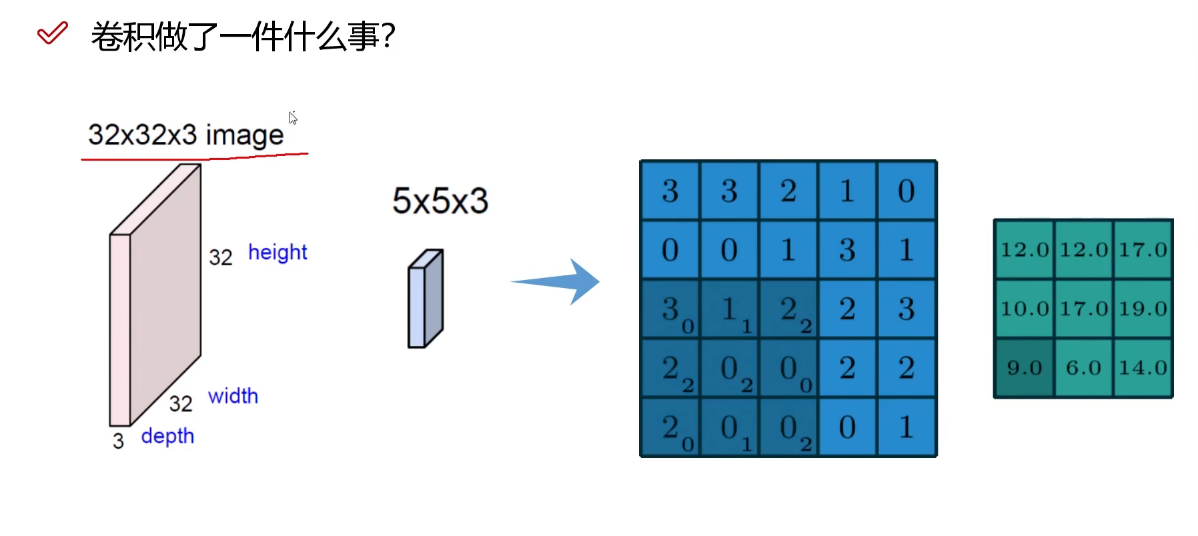
4.2.3. 何为卷积

image-20240510225602653

把一张图片分割成若干个小方块,在每个小方块内进行卷积操作,用于提取这个小方块的特征。

如图中在一个$3\times3$的小方块内,每一个数字的角标表示相应的权重,这和我们在神经网络中讲的$w_i$是一个东西,我们最终的目的就是要得到一个最佳的权重矩阵。

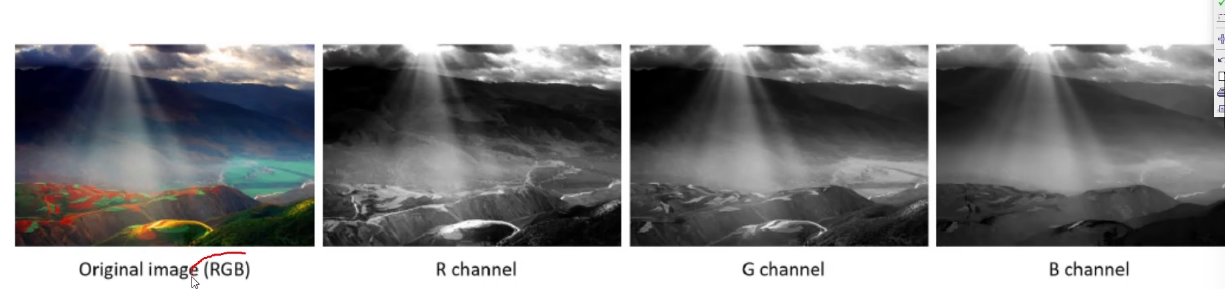
图像颜色通道

image-20240510231925152

每张彩色图片都有三个颜色通道R、G、B。

这也就是上图中的$32\times32\times3$中的$3$。对于每张图片,都要单独对每个通道进行卷积计算,然后再进行相加。

一张图片经过R、G、B三个通道分割之后,每个通道被编码成一个数字矩阵,矩阵中的每个元素用一个0-255的数字来表示颜色强度。

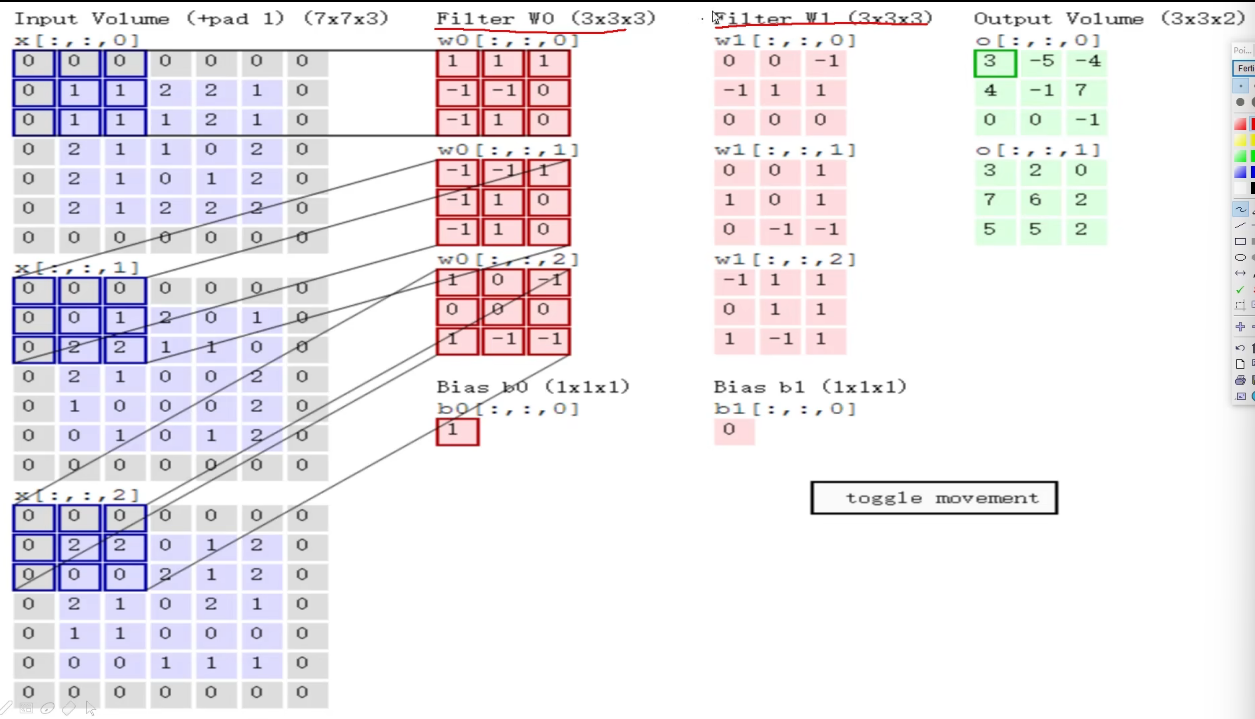
卷积核

每个卷积核就是一个随机初始化的权重矩阵,所谓的卷积操作就是指一个权重矩阵在图片的每个通道上作内积,如果初始输入有三个Chanel,就需要一个三维卷积核的一维分别在该通道上滑动,进行内积。当然这里面涉及到滑动的步长,比如每一次卷积核移动一格。

最终把三个通道的内积内容相加然后加上bias(偏置),就得到右边绿色的输出。我们每次可以使用多个卷积核,然后就会得到多个不同的输出,比如使用两个卷积核就使得下一次的输入数据变成$3\times3\times2$的规格。

image-20240511080722994

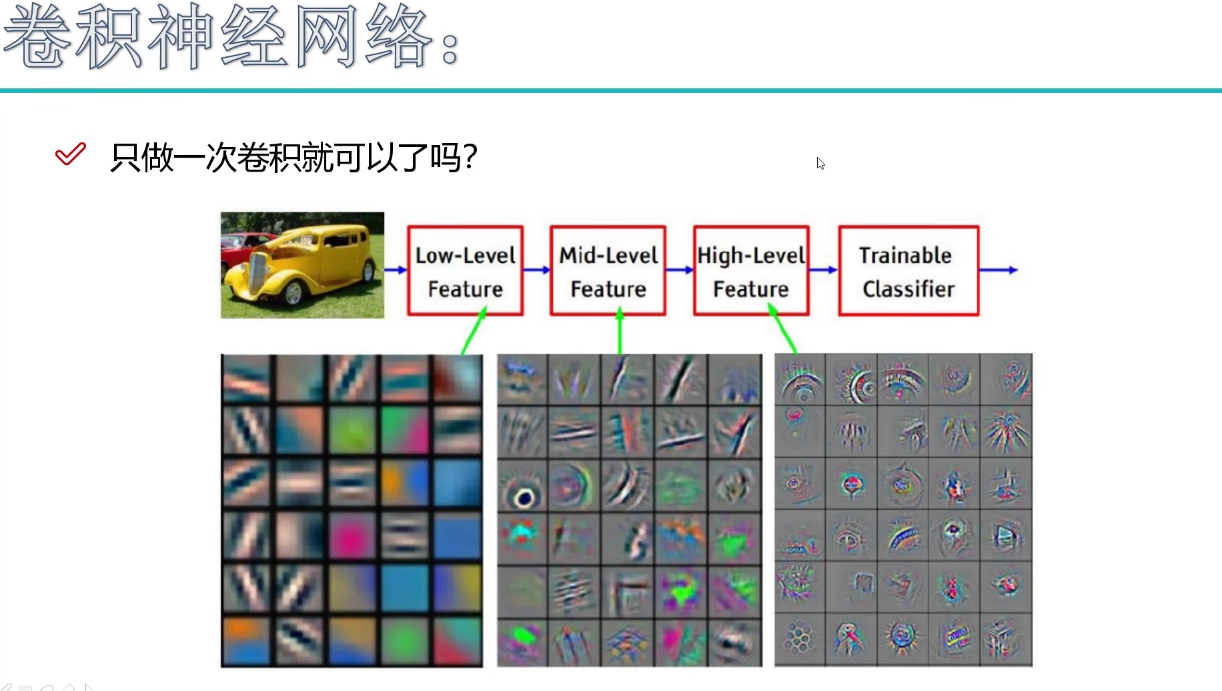
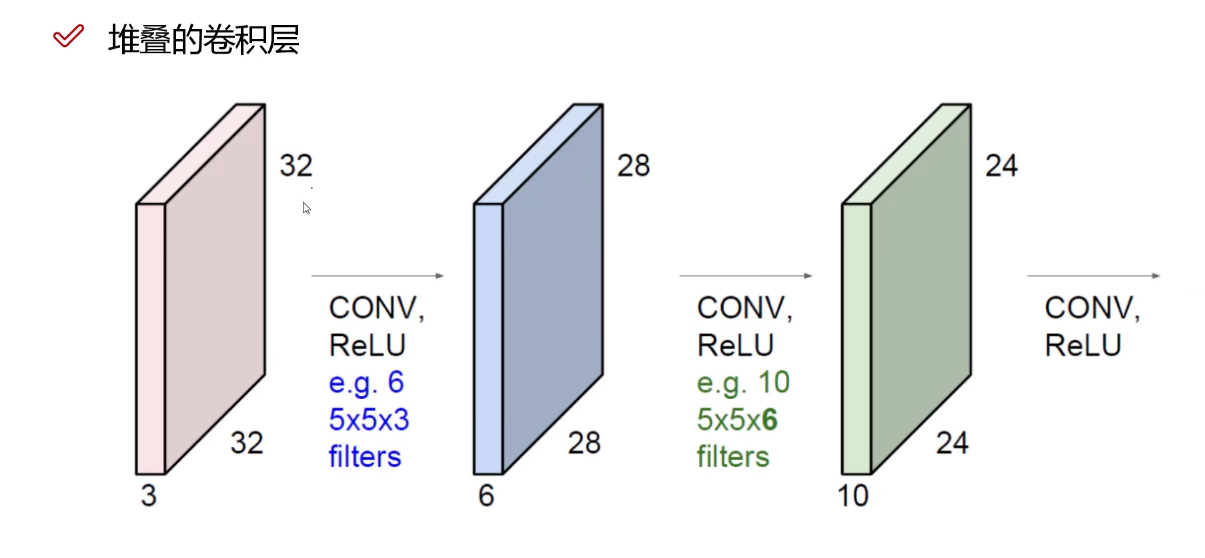
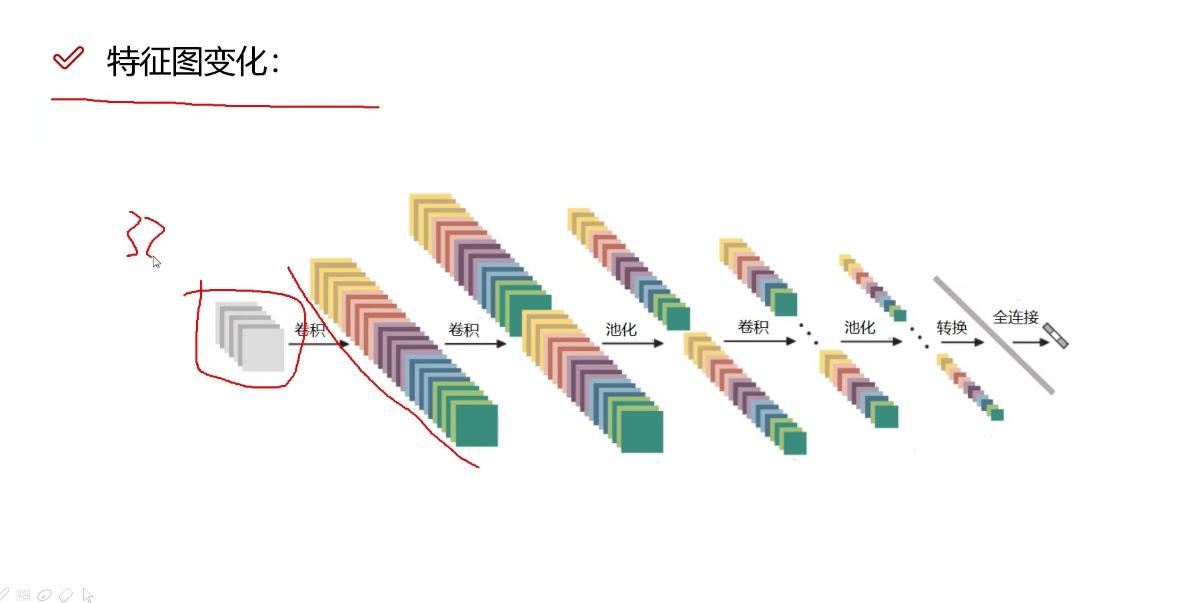
我们知道卷积操作是为了提取特征,但是一张图片的特征往往是很小的一部分,所以我们需要进行多次卷积操作,以便高度提炼一张图片的特征值。

image-20240511080922918

卷积操作中的卷积核数量会影响到下一次输入时的Channel,比如一个$5\times5\times3$的输入经过6个卷积核的卷积操作,下一次的输入Channel就变成$6$个。

image-20240511080945074

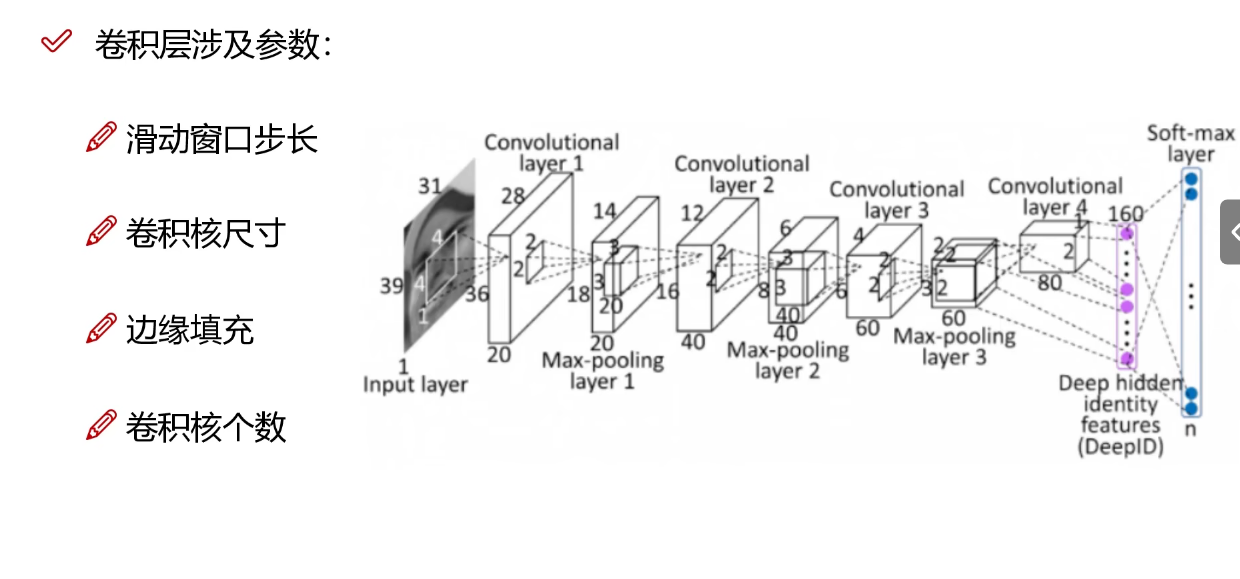
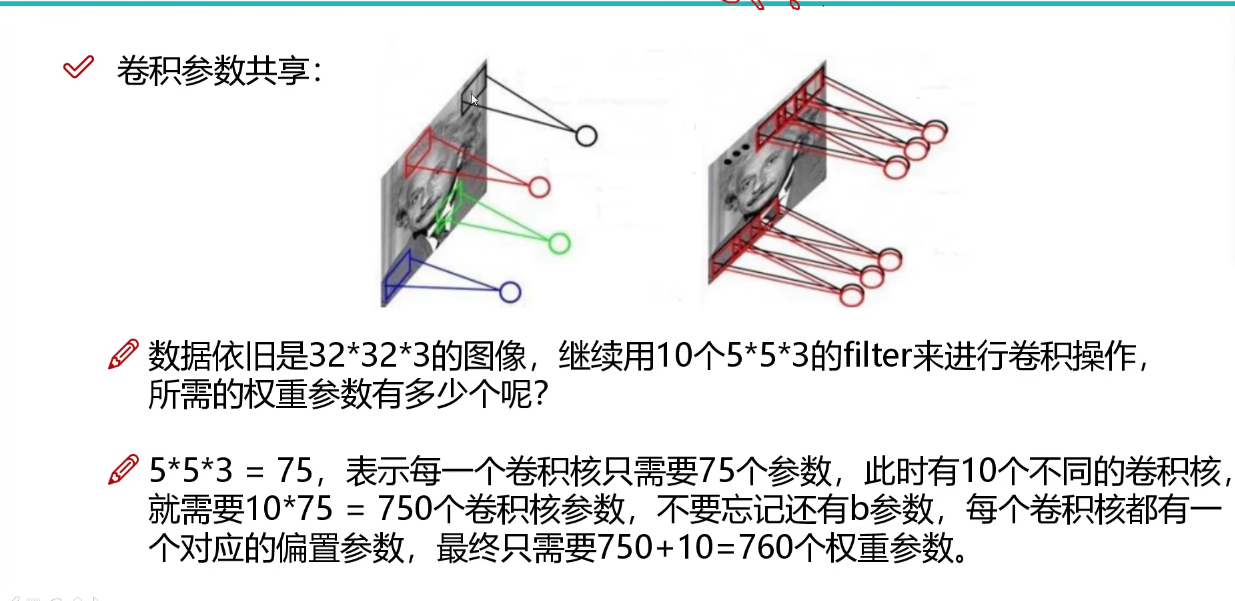
BP需要确定的参数:

image-20240511081015453

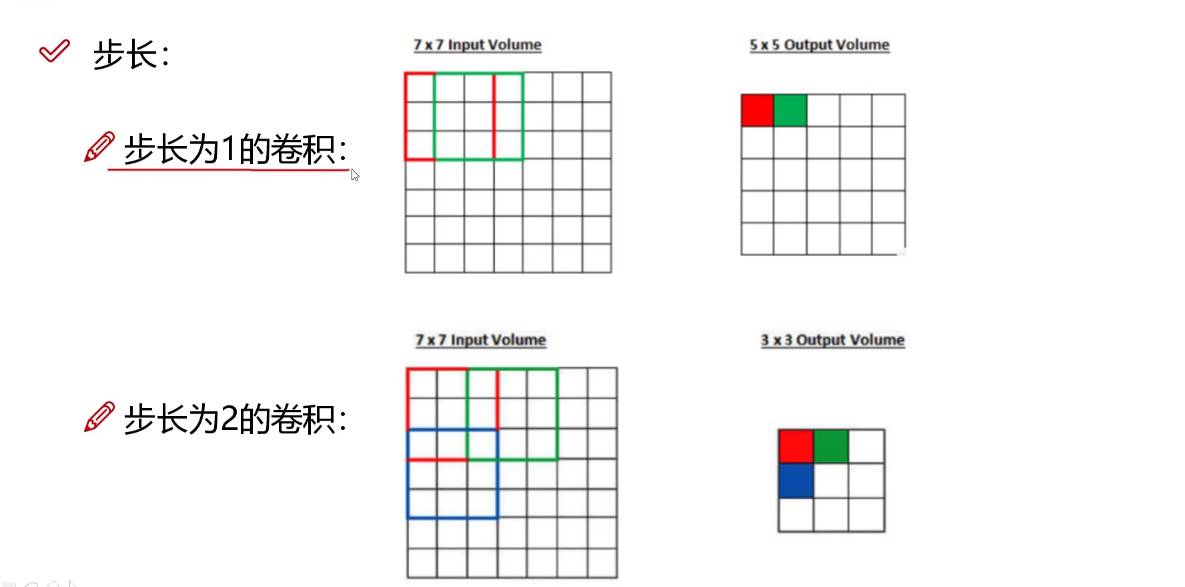
步长越小,提取出来的特征图就越大,含有的特征也就越多。

image-20240511081031048

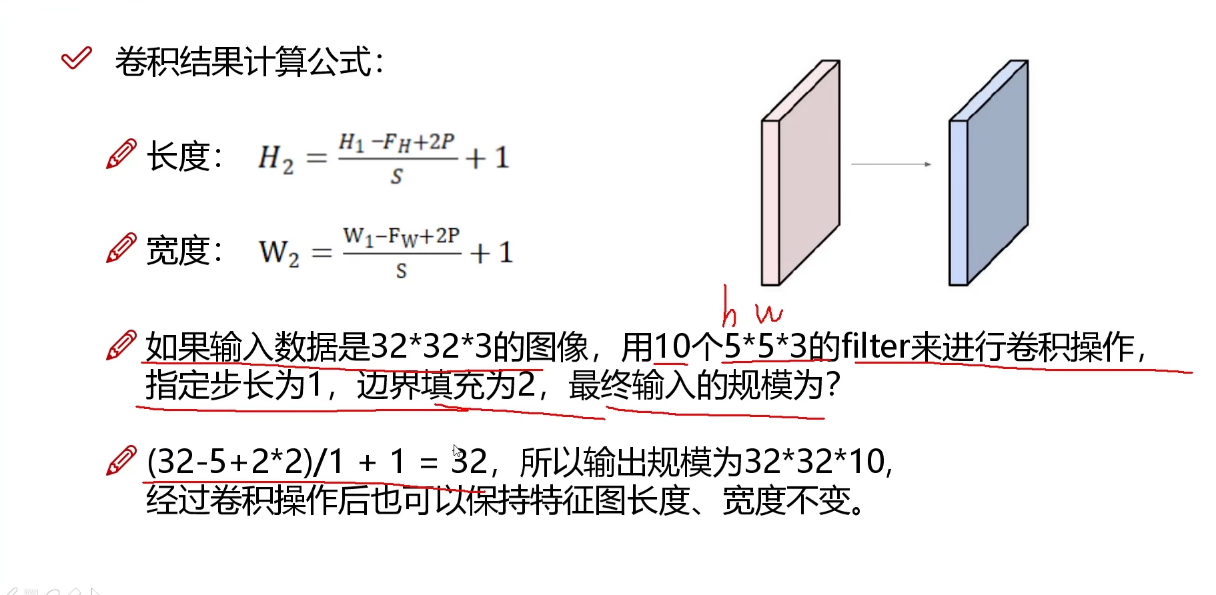
每一次卷积之后的特征图大小计算公式。

image-20240511081147493

image-20240511081209178

4.2.4. 池化层

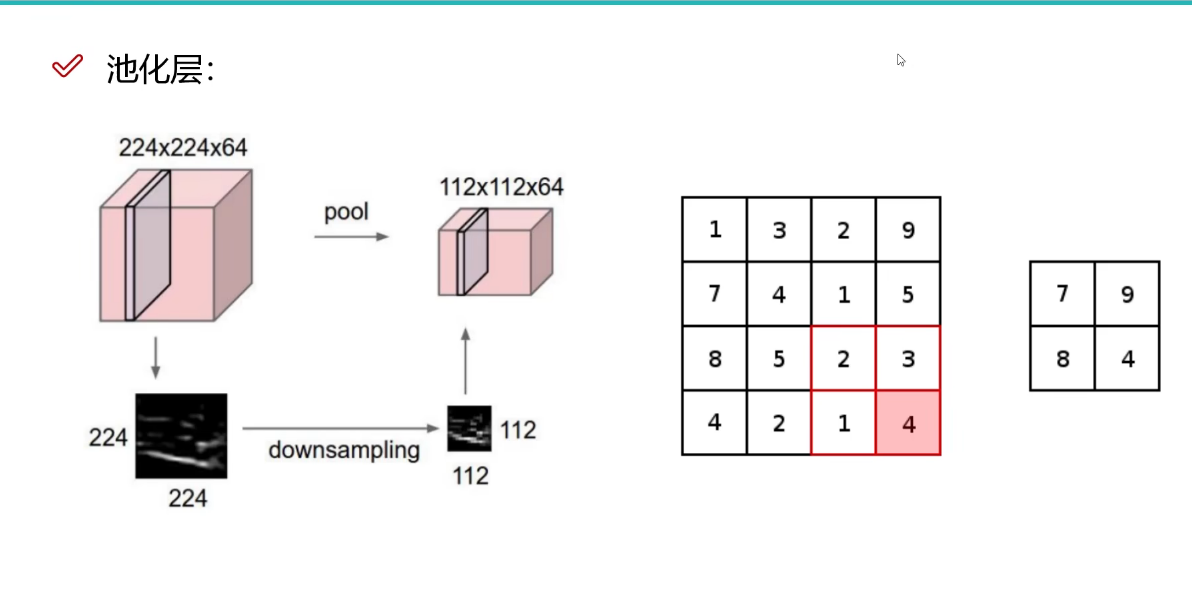
池化层主要是为了压缩特征

可以对h和w进行压缩,c不能压缩。比如把h和w都缩小为之前的$\frac12$,那么整个体积就变成原来的$\frac14$。

image-20240511081311648

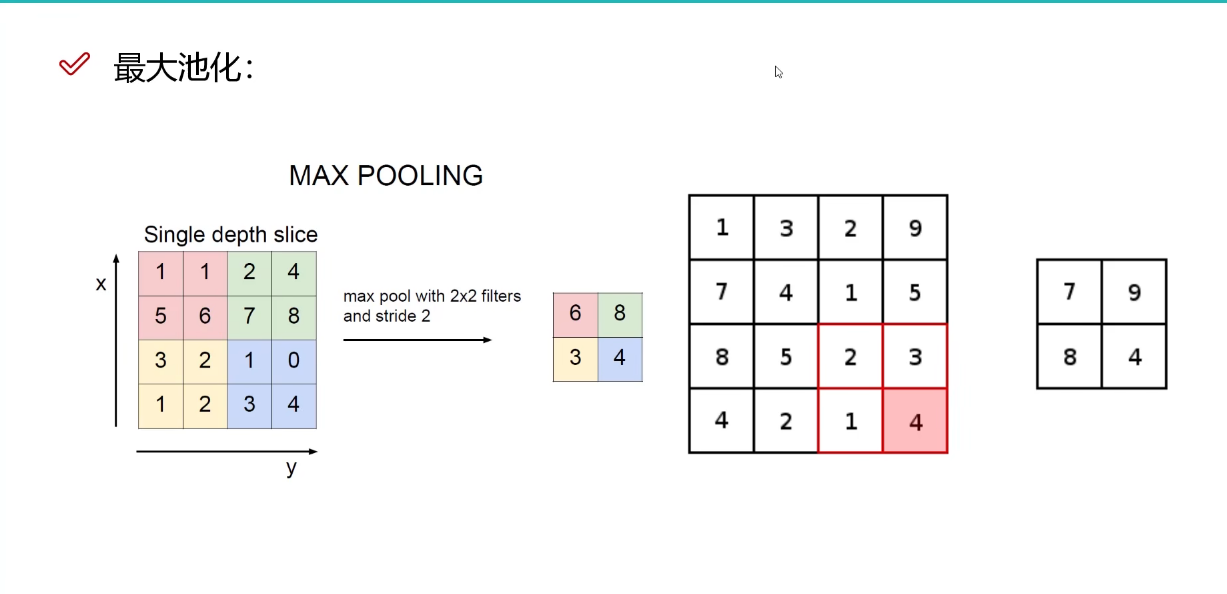
MAX POOLING

这是一种压缩算法,和卷积操作类似,把特征图分割成若干个小矩阵,取每个小矩阵里面的最大值作为代表特征,然后只取代表特征,以完成压缩,如下图所示:

image-20240511081351716

整体流程

每一次卷积操作之后必须使用一个激活函数引入非线性因素,一个常见的CNN流程一般是两次卷积操作(每次之后跟ReLu函数),一次池化操作。然后经过多次这样的循环之后,最终需要一个全连接层把三维的一个东西展平成一维向量。

全连接层可看作一个传统的神经网络中的最后一层,因为我们最终要进行分类或者回归任务,最终得到的是一个一维的几个分类或者一组一维数据,而全连接层就是把一个$a\times{b}\times{c}$的三维矩阵展平成一个$abc\times1$的一维向量,具体来说就是把三维里面的每一个特征值取出来放到这个一维向量里。

image-20240511081415360

image-20240511081435308

5. 编写模型

这个最基础的版本来自头歌机器学习 — 神经网络 (educoder.net)

根据之前给出的特征图的计算公式

image-20240511092650090

得到$H=W=\frac{28-5+2\times2}1+1=28$

构建卷积神经网络模型

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
class CNN(nn.Module):
def __init__(self):
super(CNN, self).__init__()
self.conv1 = nn.Sequential( # 输入形状 (1, 28, 28)
nn.Conv2d(
in_channels=1, # 输入频道
out_channels=16, # 过滤器数量(卷积核)
kernel_size=5, # 过滤器大小
stride=1, # 过滤器移动/步长
padding=2, # 如果希望在conv2d后保持图像的宽度和长度不变,当步长为1时,padding=(kernel_size-1)/2
), # 输出形状 (16, 28, 28)
nn.ReLU(), # 激活函数
nn.MaxPool2d(kernel_size=2), # 在2x2区域内选择最大值,输出形状 (16, 14, 14)
)
self.conv2 = nn.Sequential( # 输入形状 (16, 14, 14)
nn.Conv2d(16, 32, 5, 1, 2), # 输出形状 (32, 14, 14)
nn.ReLU(), # 激活函数
nn.MaxPool2d(2), # 输出形状 (32, 7, 7)
)
self.out = nn.Linear(32 * 7 * 7, 10) # 全连接层,输出10个类别
# BP
def forward(self, x):
x = self.conv1(x)
x = self.conv2(x)
x = x.view(x.size(0), -1) # 将conv2的输出展平为 (batch_size, 32 * 7 * 7)
output = self.out(x)
return output

整体代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
#encoding=utf8
import torch
import torch.nn as nn
from torch.autograd import Variable
import torch.utils.data as Data
import torchvision
import os
if os.path.exists('./step3/cnn.pkl'):
os.remove('./step3/cnn.pkl')

# 加载数据
train_data = torchvision.datasets.MNIST(
root='./step3/mnist/', # 数据集存放路径
train=True, # 这是训练数据
transform=torchvision.transforms.ToTensor(), # 将PIL.Image或numpy.ndarray转换为tensor
download=False, # 不下载数据
)

# 取6000个样本作为训练集
train_data_tiny = []
for i in range(6000):
train_data_tiny.append(train_data[i])
train_data = train_data_tiny

# mini_batch
train_loader = Data.DataLoader(dataset=train_data, batch_size=64, shuffle=True)

# 构建卷积神经网络模型
class CNN(nn.Module):
def __init__(self):
super(CNN, self).__init__()
self.conv1 = nn.Sequential( # 输入形状 (1, 28, 28)
nn.Conv2d(
in_channels=1, # 输入频道
out_channels=16, # 过滤器数量(卷积核)
kernel_size=5, # 过滤器大小
stride=1, # 过滤器移动/步长
padding=2, # 如果希望在conv2d后保持图像的宽度和长度不变,当步长为1时,padding=(kernel_size-1)/2
), # 输出形状 (16, 28, 28)
nn.ReLU(), # 激活函数
nn.MaxPool2d(kernel_size=2), # 在2x2区域内选择最大值,输出形状 (16, 14, 14)
)
self.conv2 = nn.Sequential( # 输入形状 (16, 14, 14)
nn.Conv2d(16, 32, 5, 1, 2), # 输出形状 (32, 14, 14)
nn.ReLU(), # 激活函数
nn.MaxPool2d(2), # 输出形状 (32, 7, 7)
)
self.out = nn.Linear(32 * 7 * 7, 10) # 全连接层,输出10个类别

def forward(self, x):
x = self.conv1(x)
x = self.conv2(x)
x = x.view(x.size(0), -1) # 将conv2的输出展平为 (batch_size, 32 * 7 * 7)
output = self.out(x)
return output

cnn = CNN()

# SGD表示使用随机梯度下降方法,lr为学习率
optimizer = torch.optim.SGD(cnn.parameters(), lr = 0.1)

# 交叉熵损失函数
loss_func = nn.CrossEntropyLoss()

for step, (x, y) in enumerate(train_loader):
b_x = Variable(x) # batch x
b_y = Variable(y) # batch y
output = cnn(b_x) # cnn输出
loss = loss_func(output, b_y) # 计算损失
optimizer.zero_grad() # 清空上一步的残余更新参数值
loss.backward() # 误差反向传播,计算参数更新值
optimizer.step() # 将参数更新值施加到net的parameters上

# 保存模型
torch.save(cnn.state_dict(), './step3/cnn.pkl')

6. 优化

6.1. 优化的意义

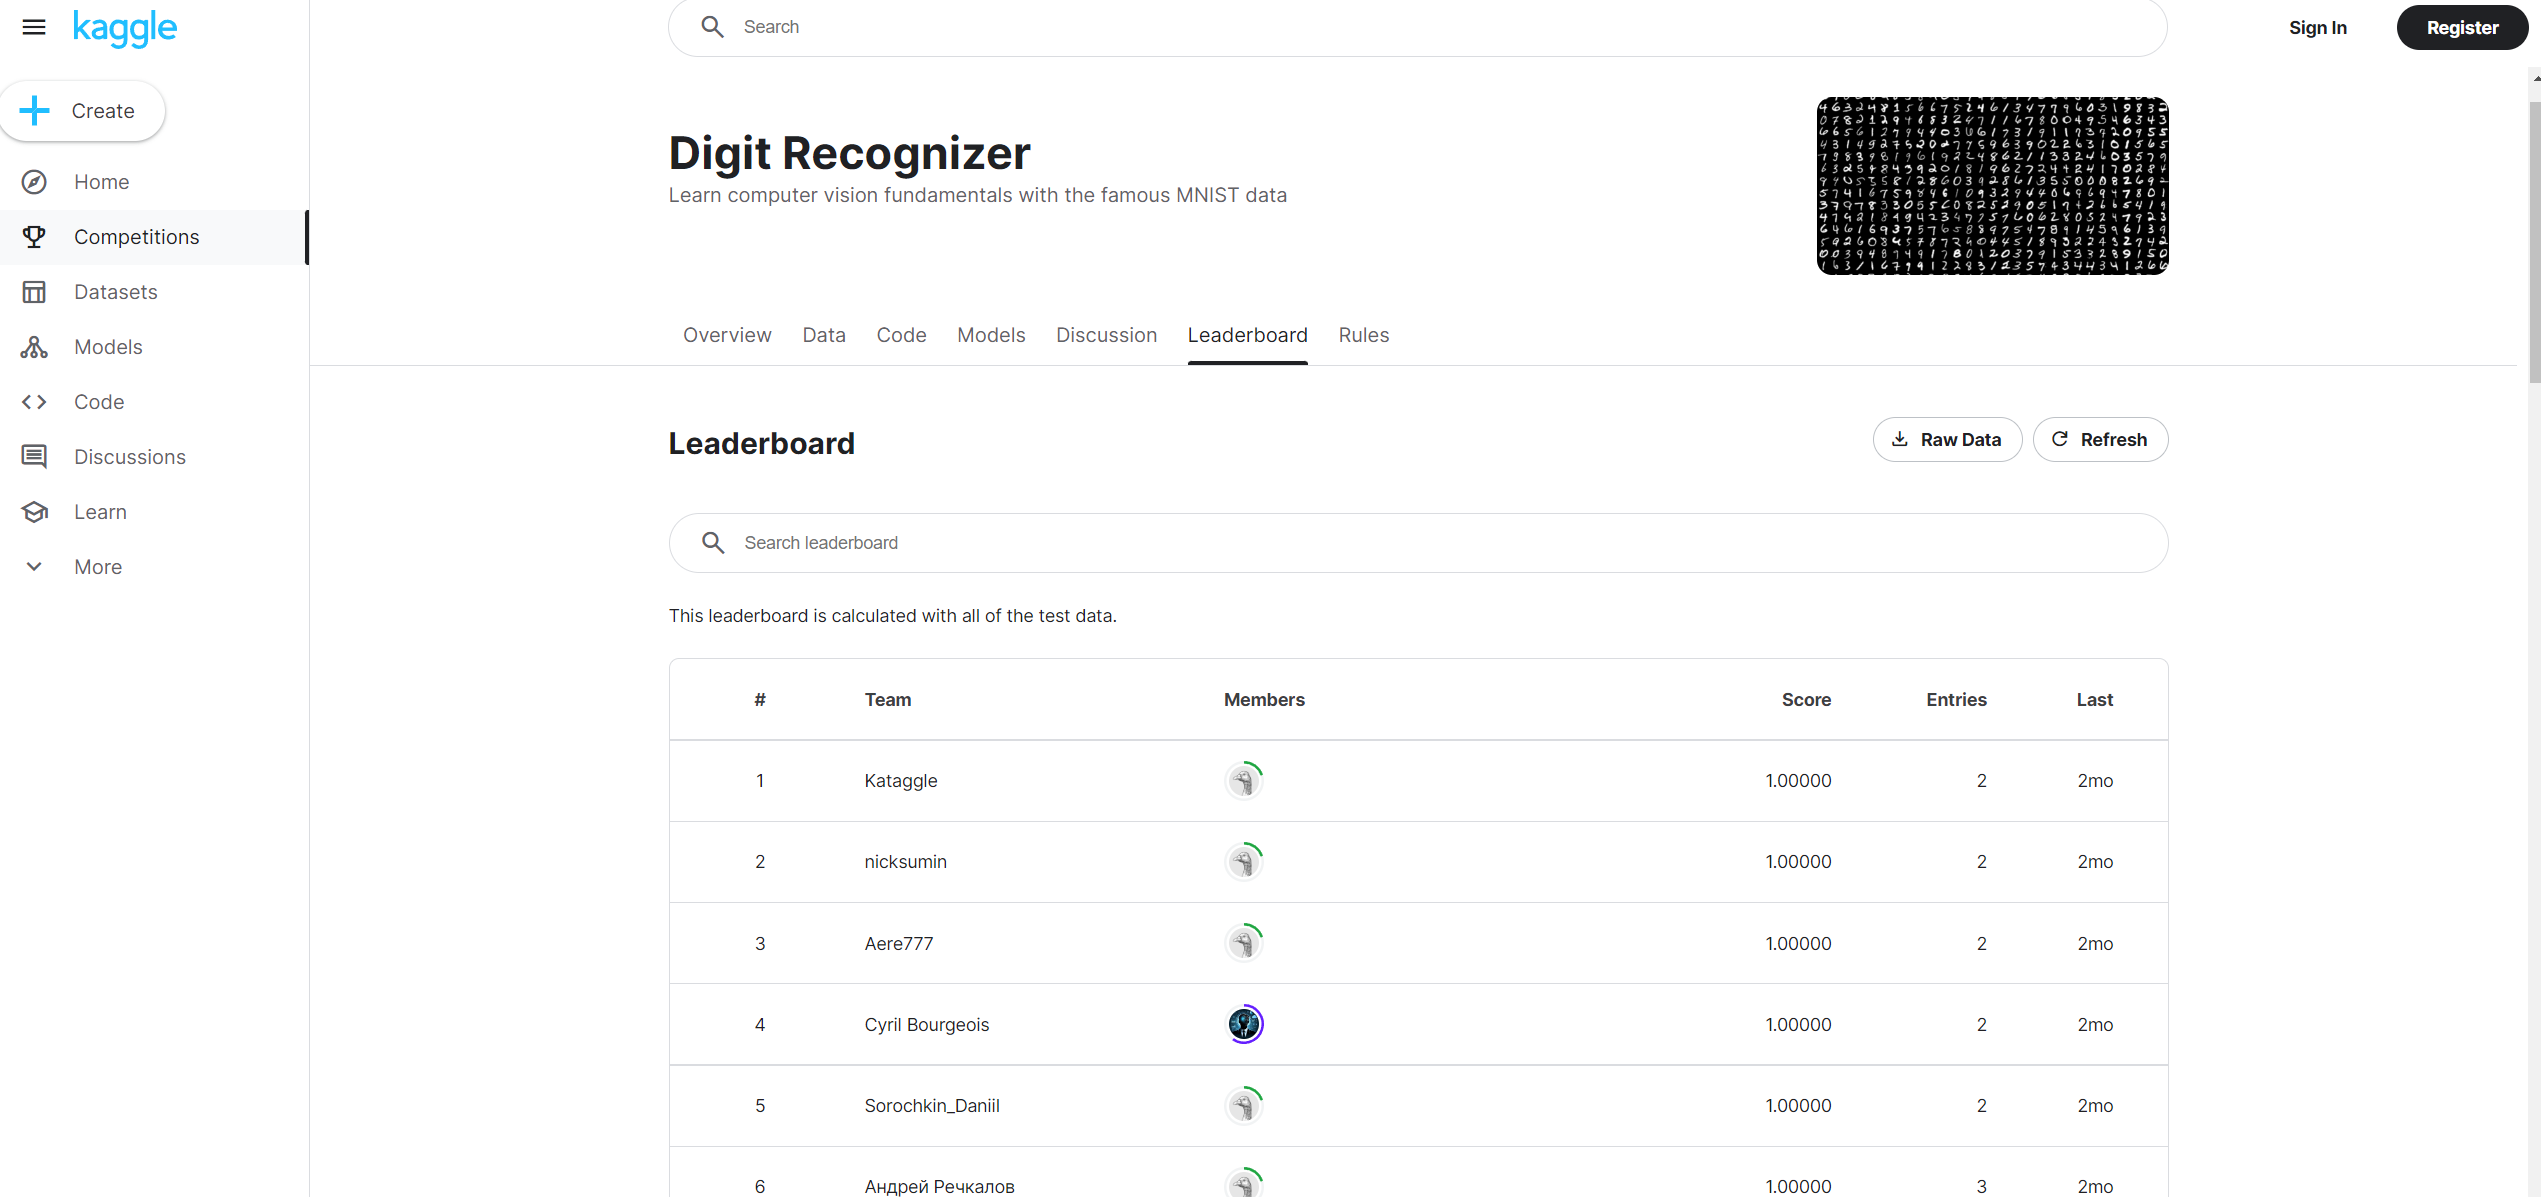
在kaggle这个网站中,在手写数字识别这个比赛中,已经有很多人做到了1的正确率,这是了不起的,这也是我们初学者所努力的方向。只有在对模型不断地调参,不断地优化地过程中,我们才能深切地感受到神经网络乃至机器学习的魅力。

image-20240515222428749

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
212
213
214
215
216
217
218
219
220
221
222
223
224
225
226
227
228
229
230
231
232
233
234
235
236
237
238
239
240
241
242
243
244
245
246
247
248
249
250
251
252
253
254
255
256
257
258
259
260
261
262
263
264
265
266
267
268
269
270
271
272
273
274
275
276
277
278
279
280
281
282
283
284
285
286
287
288
289
290
291
292
293
294
295
296
297
298
299
300
301
302
303
304
305
306
307
308
309
310
311
312
313
314
315
316
317
318
import torch
import torchvision
from torch.utils.data import DataLoader
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
import matplotlib.pyplot as plt

# torch.backends.cudnn.enabled = False
# 优先使用GPU
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
# 打印使用的设备
print(device)

# 一些超参数

# 定义训练过程中的 "epoch" 数量。一个 epoch 指的是整个训练集被遍历一次。
n_epochs = 3
# 定义训练过程中的批次大小。批次大小是指在更新模型参数之前要处理的数据样本数量。
batch_size_train = 64
# 定义测试过程中的批次大小。在评估模型性能时,会一次处理这么多的数据样本。
batch_size_test = 1000
# 定义优化器的学习率。学习率是一个控制模型参数更新步长的参数。
learning_rate = 0.01
# 定义优化器的动量。动量是一种帮助优化器在优化过程中保持方向并加速收敛的技术。
momentum = 0.5
# 定义训练过程中的日志记录间隔。每处理这么多个批次,就会打印一次训练日志。
log_interval = 10
# 设置随机数生成器的种子。设置随机种子可以确保实验的可重复性。
random_seed = 1
torch.manual_seed(random_seed)

# 创建训练数据加载器

train_loader = torch.utils.data.DataLoader(
# 加载 MNIST 数据集,如果数据集不存在,则下载数据集
torchvision.datasets.MNIST('./data/', train=True, download=True,
# 对数据进行预处理,包括将数据转换为张量,并进行标准化
transform=torchvision.transforms.Compose([
# 将图像数据转换为 PyTorch 张量
torchvision.transforms.ToTensor(),
# 对数据进行标准化,参数是 MNIST 数据的均值和标准差
torchvision.transforms.Normalize(
(0.1307,), (0.3081,))
])),
# 设置批次大小
batch_size=batch_size_train,
# 在每个 epoch 开始时,洗牌数据
shuffle=True)

# 创建测试数据加载器

test_loader = torch.utils.data.DataLoader(
# 加载 MNIST 数据集,如果数据集不存在,则下载数据集
torchvision.datasets.MNIST('./data/', train=False, download=True,
# 对数据进行预处理,包括将数据转换为张量,并进行标准化
transform=torchvision.transforms.Compose([
# 将图像数据转换为 PyTorch 张量
torchvision.transforms.ToTensor(),
# 对数据进行标准化,参数是 MNIST 数据的均值和标准差
torchvision.transforms.Normalize(
(0.1307,), (0.3081,))
])),
# 设置批次大小
batch_size=batch_size_test,
# 在每个 epoch 开始时,洗牌数据
shuffle=True)

# 使用 enumerate 函数对测试数据加载器进行迭代,返回一个枚举对象
examples = enumerate(test_loader)

# 使用 next 函数获取枚举对象的下一项,即一个批次的数据和对应的目标
batch_idx, (example_data, example_targets) = next(examples)

# 将数据和目标移动到指定的设备上(CPU 或 GPU)
example_data, example_targets = example_data.to(device), example_targets.to(device)

# 创建一个新的图形窗口
fig = plt.figure()

# 开始一个循环,循环6次。在每次循环中,都会创建一个子图并显示一张图像和对应的标签
for i in range(6):
# 创建一个子图。2, 3, i + 1 表示创建一个2行3列的子图网格,并在第 i + 1 个位置创建子图
plt.subplot(2, 3, i + 1)

# 调整子图的布局,使得子图之间的间距适当,避免重叠
plt.tight_layout()

# 显示一张图像。example_data[i][0].cpu() 是要显示的图像,它被转移到 CPU 以便于绘图。cmap='gray' 表示使用灰度色图。interpolation='none' 表示不使用插值
plt.imshow(example_data[i][0].cpu(), cmap='gray', interpolation='none') # Move to CPU for plotting

# 设置子图的标题。标题是 "Ground Truth: " 后面跟着对应的标签
plt.title("Ground Truth: {}".format(example_targets[i]))

# 隐藏子图的 x 轴和 y 轴的刻度
plt.xticks([])
plt.yticks([])

# 显示图形窗口。在 Python 脚本中,需要调用 plt.show() 来显示图形。在 Jupyter notebook 中,通常不需要调用 plt.show(),因为图形会自动显示
plt.show()

# 定义一个名为 Net 的神经网络类,继承自 nn.Module
class Net(nn.Module):
# 初始化函数
def __init__(self):
# 调用父类 nn.Module 的初始化函数
super(Net, self).__init__()
# 定义第一个卷积层,输入通道数为1,输出通道数为10,卷积核大小为5
self.conv1 = nn.Conv2d(1, 10, kernel_size=5)
# 定义第二个卷积层,输入通道数为10,输出通道数为20,卷积核大小为5
self.conv2 = nn.Conv2d(10, 20, kernel_size=5)
# 定义一个 dropout 层,用于防止过拟合
self.conv2_drop = nn.Dropout2d()
# 定义第一个全连接层,输入节点数为320,输出节点数为50
self.fc1 = nn.Linear(320, 50)
# 定义第二个全连接层,输入节点数为50,输出节点数为10
self.fc2 = nn.Linear(50, 10)

# 定义前向传播函数
def forward(self, x):
# 对输入 x 应用第一个卷积层,然后应用最大池化层(池化窗口大小为2),然后应用 ReLU 激活函数
x = F.relu(F.max_pool2d(self.conv1(x), 2))
# 对 x 应用第二个卷积层,然后应用 dropout 层,然后应用最大池化层(池化窗口大小为2),然后应用 ReLU 激活函数
x = F.relu(F.max_pool2d(self.conv2_drop(self.conv2(x)), 2))
# 将 x 的形状变为(-1, 320),-1 表示自动计算该维度的大小
x = x.view(-1, 320)
# 对 x 应用第一个全连接层,然后应用 ReLU 激活函数
x = F.relu(self.fc1(x))
# 对 x 应用 dropout,dropout 的比例由 self.training 决定
x = F.dropout(x, training=self.training)
# 对 x 应用第二个全连接层
x = self.fc2(x)
# 对 x 应用 log_softmax,计算每个类别的对数概率
return F.log_softmax(x, dim=1)

# 创建一个网络实例,并将其移动到指定的设备上(例如 GPU 或 CPU)
network = Net().to(device)

# 创建一个随机梯度下降优化器,用于更新网络的参数
# network.parameters() 是网络的所有可训练参数
# lr 是学习率,控制参数更新的步长
# momentum 是动量,可以加速 SGD 在相关方向上的收敛,并抑制震荡
optimizer = optim.SGD(network.parameters(), lr=learning_rate, momentum=momentum)

# 创建列表以存储训练和测试过程中的损失
train_losses = []
train_counter = []
test_losses = []
# 创建一个计数器,用于记录每个测试周期结束时处理的总样本数
test_counter = [i * len(train_loader.dataset) for i in range(n_epochs + 1)]

# 定义训练函数
def train(epoch):
# 将网络切换到训练模式
network.train()
# 遍历训练数据加载器中的所有批次
for batch_idx, (data, target) in enumerate(train_loader):
# 将数据和目标移动到指定的设备上
data, target = data.to(device), target.to(device)
# 在进行新的一次前向传播之前,先将优化器中的梯度清零
optimizer.zero_grad()
# 通过网络进行前向传播,计算出预测值
output = network(data)
# 计算损失,这里使用的是负对数似然损失
loss = F.nll_loss(output, target)
# 通过损失进行反向传播,计算出梯度
loss.backward()
# 使用优化器更新网络的参数
optimizer.step()
# 每隔一定数量的批次,打印训练状态并保存损失
if batch_idx % log_interval == 0:
print('Train Epoch: {} [{}/{} ({:.0f}%)]\tLoss: {:.6f}'.format(epoch, batch_idx * len(data),
len(train_loader.dataset),
100. * batch_idx / len(train_loader),
loss.item()))
# 将损失添加到损失列表中
train_losses.append(loss.item())
# 记录处理过的样本数量
train_counter.append((batch_idx * 64) + ((epoch - 1) * len(train_loader.dataset)))
# 保存网络的状态字典和优化器的状态字典
torch.save(network.state_dict(), './model.pth')
torch.save(optimizer.state_dict(), './optimizer.pth')

# 定义测试函数
def test():
# 将网络切换到评估模式,这会关闭某些特定于训练的行为,如 Dropout
network.eval()
# 初始化测试损失和正确预测的数量
test_loss = 0
correct = 0
# 使用 torch.no_grad() 上下文管理器,关闭自动求导,减少内存使用并加速计算
with torch.no_grad():
# 遍历测试数据加载器中的所有批次
for data, target in test_loader:
# 将数据和目标移动到指定的设备上
data, target = data.to(device), target.to(device)
# 通过网络进行前向传播,计算出预测值
output = network(data)
# 计算并累加损失,这里使用的是负对数似然损失
# reduction='sum' 表示将所有批次的损失求和,而不是平均
test_loss += F.nll_loss(output, target, reduction='sum').item()
# 获取预测的类别(即概率最大的类别)
pred = output.data.max(1, keepdim=True)[1]
# 计算并累加正确预测的数量
correct += pred.eq(target.data.view_as(pred)).sum()
# 计算平均损失
test_loss /= len(test_loader.dataset)
# 将平均损失添加到损失列表中
test_losses.append(test_loss)
# 打印测试集的平均损失和准确率
print('\nTest set: Avg. loss: {:.4f}, Accuracy: {}/{} ({:.0f}%)\n'.format(
test_loss, correct, len(test_loader.dataset),
100. * correct / len(test_loader.dataset)))

# 开始训练神经网络的第一个周期
train(1)

# 在训练一个周期后,使用测试集评估模型的性能
test()

# 对于给定的周期数,进行以下操作
for epoch in range(1, n_epochs + 1):
# 训练模型。这里的 epoch 是当前的周期编号
train(epoch)
# 在每个周期结束后,使用测试集评估模型的性能
test()

# 创建一个新的图形
fig = plt.figure()

# 绘制训练损失。train_counter 是 x 轴(训练样本数量),train_losses 是 y 轴(训练损失),颜色设置为蓝色
plt.plot(train_counter, train_losses, color='blue')

# 绘制测试损失。test_counter 是 x 轴(训练样本数量),test_losses 是 y 轴(测试损失),颜色设置为红色。这里使用散点图表示
plt.scatter(test_counter, test_losses, color='red')

# 添加图例,'Train Loss' 对应蓝色的训练损失线,'Test Loss' 对应红色的测试损失点,位置在右上角
plt.legend(['Train Loss', 'Test Loss'], loc='upper right')

# 设置 x 轴的标签为 'number of training examples seen'
plt.xlabel('number of training examples seen')

# 设置 y 轴的标签为 'negative log likelihood loss'
plt.ylabel('negative log likelihood loss')

# 从测试数据加载器中获取一个迭代器
examples = enumerate(test_loader)

# 使用 next 函数从迭代器中获取下一个元素,这将返回一个批次的索引和数据(包括数据和目标)
batch_idx, (example_data, example_targets) = next(examples)

# 将数据和目标移动到设备(例如 GPU)上
example_data, example_targets = example_data.to(device), example_targets.to(device)

# 不计算梯度,因为这是推理阶段,不需要反向传播
with torch.no_grad():
# 使用网络对数据进行预测
output = network(example_data)

# 创建一个新的图形
fig = plt.figure()

# 对于前 6 个样本
for i in range(6):
# 在 2x3 的子图中创建一个新的子图
plt.subplot(2, 3, i + 1)
# 自动调整子图参数以给定指定的填充
plt.tight_layout()
# 绘制样本的图像,颜色映射为灰度
plt.imshow(example_data[i][0].cpu(), cmap='gray', interpolation='none')
# 添加标题,显示预测的类别
plt.title("Prediction: {}".format(output.data.max(1, keepdim=True)[1][i].item()))
# 删除 x 轴的刻度
plt.xticks([])
# 删除 y 轴的刻度
plt.yticks([])

# 显示图形
plt.show()

# 创建一个新的网络实例并移动到设备上
continued_network = Net().to(device)
# 创建一个新的优化器实例,使用网络的参数
continued_optimizer = optim.SGD(network.parameters(), lr=learning_rate, momentum=momentum)

# 从文件中加载网络的状态字典
network_state_dict = torch.load('model.pth')
# 使用状态字典更新网络的参数
continued_network.load_state_dict(network_state_dict)

# 从文件中加载优化器的状态字典
optimizer_state_dict = torch.load('optimizer.pth')
# 使用状态字典更新优化器的参数
continued_optimizer.load_state_dict(optimizer_state_dict)

# 对于给定的周期数
for i in range(4, 9):
# 更新测试计数器
test_counter.append(i * len(train_loader.dataset))
# 训练网络
train(i)
# 测试网络
test()

# 创建一个新的图形
fig = plt.figure()
# 绘制训练损失
plt.plot(train_counter, train_losses, color='blue')
# 绘制测试损失
plt.scatter(test_counter, test_losses, color='red')
# 添加图例
plt.legend(['Train Loss', 'Test Loss'], loc='upper right')
# 设置 x 轴的标签
plt.xlabel('number of training examples seen')
# 设置 y 轴的标签
plt.ylabel('negative log likelihood loss')
# 显示图形
plt.show()

7. 总结

作为CNN入门教程,本文会持续更新。

我一直不明白静态ip在VMware虚拟机中有什么用,因为VMware下的DHCP服务分配的的ip地址真的很少变动过,直到有一天我的电脑突然休眠后,开机发现我的一台虚拟机一直SSH连不上,我起初以为是防火墙的问题,因为有时候电脑异常关机或者休眠之后,再打开之后,虚拟机中的Linux防火墙有时会自己开启(我平时都没开过),但是这次我开放22端口,关闭防火墙之后依然不能SSH远程登录,虚拟机中的一些Web服务也连不上。

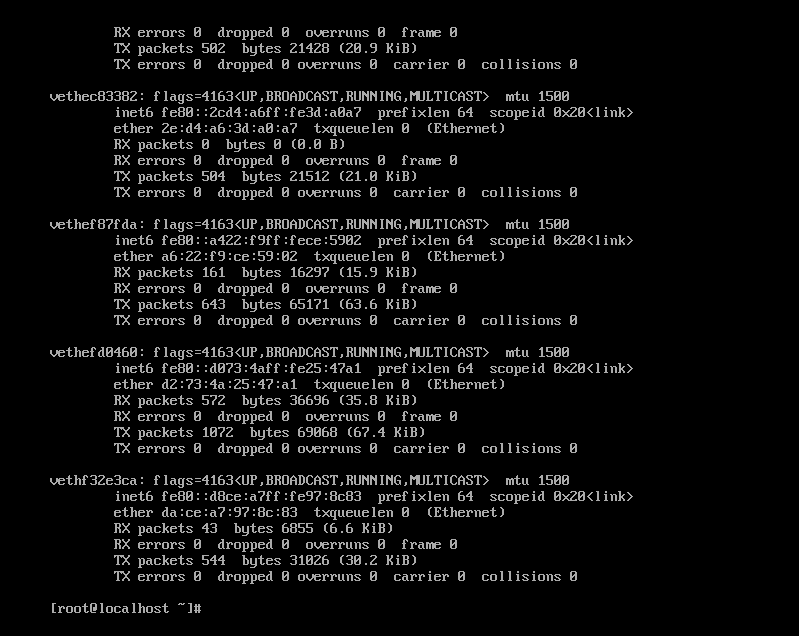
这就很奇怪,我一直是以为是防火墙的问题,甚至以为没关彻底(好蠢),但是依旧是不行。我习惯性的查看了一下本机ip,甚至我在VMware下查看ip都有点麻烦,因为我的Linux中有多个网卡,最上面那个ens33网卡的ip根本看不到,因为Vmware中那个纯命令行界面不能翻页,就像这样:

image-20240401230921331

我又用了ifconfig ens33这个命令来查看这块网卡的ip信息,有点惊讶的发现ip地址居然变了,变成了192.168.154.137,之前一直是136,这就很奇怪,我还是第一次遇到这种情况,之前从来没变过的。

于是我就想着把ip设为静态ip,防止下次再变

  1. 打开终端。
  2. 使用文本编辑器(如 vim 或 nano)打开网络接口的配置文件。例如,如果你的网络接口的名称是 eth0,你可以使用以下命令:
1
sudo vim /etc/sysconfig/network-scripts/ifcfg-eth0
  1. 在配置文件中,找到以下行,然后修改它们的值:
1
2
3
4
5
BOOTPROTO=static
ONBOOT=yes
IPADDR=your_static_ip
NETMASK=your_netmask
GATEWAY=your_gateway

在这些行中,your_static_ip、your_netmask 和 your_gateway 是你的静态 IP 地址、子网掩码和默认网关。你应该使用你的网络环境的实际值替换它们。

注意如果原来的配置文件=右边带””,新配置也要带,统一格式就行

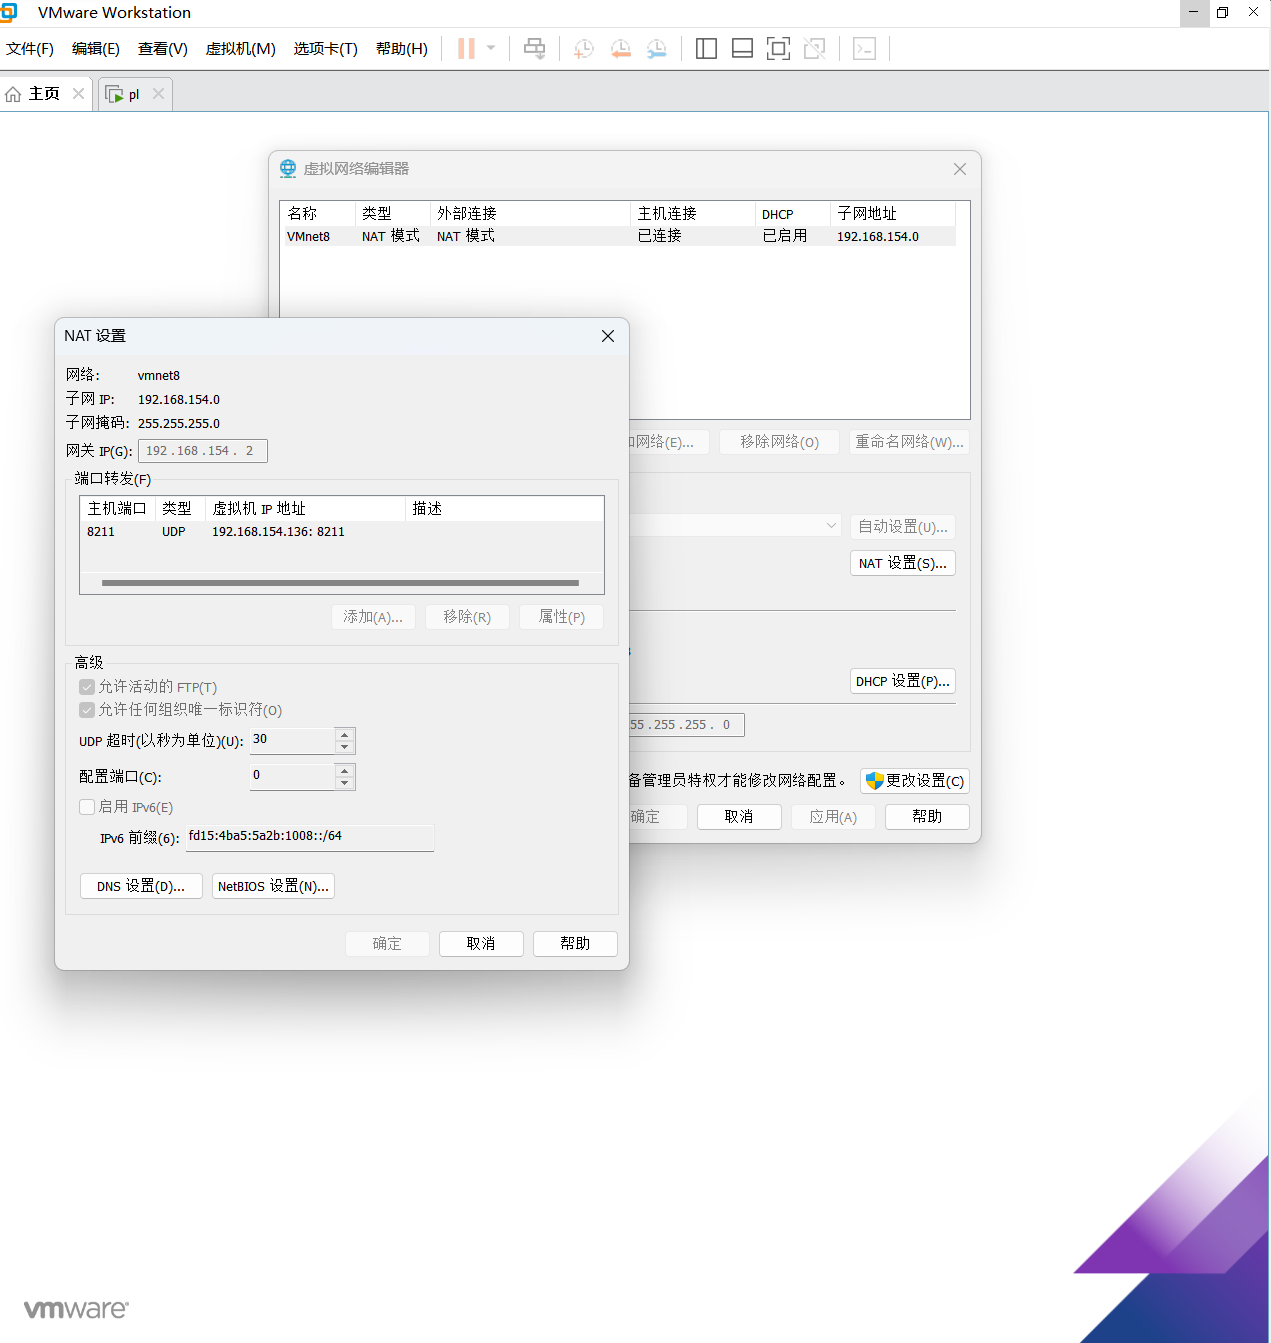
子网掩码一般设为255.255.255.0,默认网关在虚拟网络编辑器中查看:

image-20240401231852132

这里为192.168.154.2,注意你设置的静态ip要和网关在同一网段。

  1. 保存并关闭配置文件。
  2. 重启网络服务,使更改生效:
1
sudo systemctl restart network

这时候应该没问题了,连接没问题,但是ping www.baidu.com ping不通,可能是DNS的问题,添加Google的公共DNS,一般设置这个:

1
echo "nameserver 8.8.8.8" | sudo tee /etc/resolv.conf

或者在刚才的ifcfg-eth0配置文件中加一个DNS = 8.8.8.8,都可以这两种方式。

重启网络sudo systemctl restart network,已经能ping通baidu。

SSH(Secure Shell)是一种网络协议,用于在不安全的网络中安全地进行远程登录。除了基本的远程命令执行功能,SSH 还提供了一些高级功能,其中之一就是隧道(Tunneling)。

什么是 SSH 隧道?

SSH 隧道是一种将任意网络流量封装在 SSH 连接中的技术。这种技术可以用于加密不安全的网络协议,或者绕过网络防火墙。

SSH 隧道的类型

SSH 提供了三种类型的隧道:本地端口转发(Local Port Forwarding)、远程端口转发(Remote Port Forwarding)和动态端口转发(Dynamic Port Forwarding)。

本地端口转发

本地端口转发可以将本地机器的一个端口转发到远程机器的一个端口。这可以用于通过 SSH 服务器访问远程网络资源。

1
ssh -L local_port:remote_host:remote_port user@ssh_server

远程端口转发

远程端口转发可以将远程机器的一个端口转发到本地机器的一个端口。这可以用于让远程机器通过 SSH 服务器访问本地网络资源。

1
ssh -R remote_port:local_host:local_port user@ssh_server

动态端口转发

动态端口转发可以创建一个 SOCKS 代理服务器,用于动态地转发网络流量。这可以用于匿名浏览或者绕过网络防火墙。

1
ssh -D local_port user@ssh_server

怎么关闭或者删除隧道?

SSH 隧道是基于每个 SSH 连接的,当你断开 SSH 连接时,与之相关的所有隧道都会自动关闭。因此,你无法直接查看或删除已经创建的 SSH 隧道,你只能通过断开 SSH 连接来关闭隧道。

如果你想查看当前的 SSH 连接,你可以使用 ps 命令(在 Unix-like 系统中)来查找 SSH 进程。例如:

1
ps aux | grep ssh

这将列出所有与 SSH 相关的进程。你可以通过查看这些进程的命令行参数来找出与隧道相关的 SSH 连接。

如果你想关闭一个 SSH 隧道,你需要找到与之相关的 SSH 连接的进程 ID(PID),然后使用 kill 命令来结束这个进程。例如:

1
kill -9 <PID>

请注意,你需要将 <PID> 替换为你想要结束的 SSH 连接的进程 ID。

结论

SSH 隧道是 SSH 的一个强大功能,可以用于加密网络流量、绕过网络防火墙,或者访问远程网络资源。通过理解和使用 SSH 隧道,我们可以更好地保护我们的网络通信。

目录

1. 认识Hadoop和Hbase

1.1 hadoop简单介绍

Hadoop是一个使用java编写的Apache开放源代码框架,它允许使用简单的编程模型跨大型计算机的大型数据集进行分布式处理。Hadoop框架工作的应用程序可以在跨计算机群集提供分布式存储和计算的环境中工作。Hadoop旨在从单一服务器扩展到数千台机器,每台机器都提供本地计算和存储。

1.2 Hadoop架构

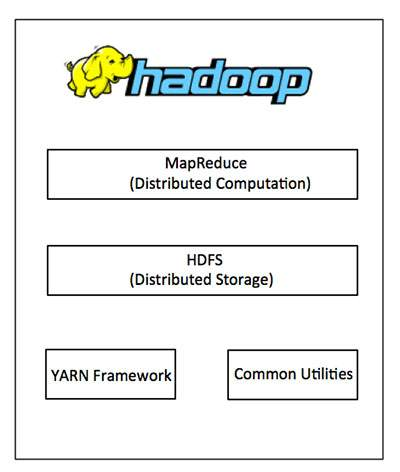
Hadoop框架包括以下四个模块:

  • Hadoop Common:这些是其他Hadoop模块所需的Java库和实用程序。这些库提供文件系统和操作系统级抽象,并包含启动Hadoop所需的必要Java文件和脚本。
  • Hadoop YARN:这是作业调度和集群资源管理的框架。
  • Hadoop分布式文件系统(HDFS):提供对应用程序数据的高吞吐量访问的分布式文件系统。
  • Hadoop MapReduce: 这是基于YARN的大型数据集并行处理系统。

我们可以使用下图来描述Hadoop框架中可用的这四个组件。

img

自2012年以来,术语“Hadoop”通常不仅指向上述基本模块,而且还指向可以安装在Hadoop之上或之外的其他软件包,例如Apache Pig,Apache Hive,Apache HBase,Apache火花等。

1.3 Hadoop如何工作?

(1)阶段1

  用户/应用程序可以通过指定以下项目向Hadoop(hadoop作业客户端)提交所需的进程:

  • 分布式文件系统中输入和输出文件的位置。
  • java类以jar文件的形式包含了map和reduce功能的实现。
  • 通过设置作业特定的不同参数来进行作业配置。

(2)阶段2

  然后,Hadoop作业客户端将作业(jar /可执行文件等)和配置提交给JobTracker,JobTracker负责将软件/配置分发到从站,调度任务和监视它们,向作业客户端提供状态和诊断信息。

(3)阶段3

  不同节点上的TaskTrackers根据MapReduce实现执行任务,并将reduce函数的输出存储到文件系统的输出文件中。

1.4 Hadoop的优点

  • Hadoop框架允许用户快速编写和测试分布式系统。它是高效的,它自动分配数据并在机器上工作,反过来利用CPU核心的底层并行性。
  • Hadoop不依赖硬件提供容错和高可用性(FTHA),而是Hadoop库本身被设计为检测和处理应用层的故障。
  • 服务器可以动态添加或从集群中删除,Hadoop继续运行而不会中断。
  • Hadoop的另一大优点是,除了是开放源码,它是所有平台兼容的,因为它是基于Java的。

1.5 HBase介绍

Hbase全称为Hadoop Database,即hbase是hadoop的数据库,是一个分布式的存储系统。Hbase利用Hadoop的HDFS作为其文件存储系统,利用Hadoop的MapReduce来处理Hbase中的海量数据。利用zookeeper作为其协调工具。

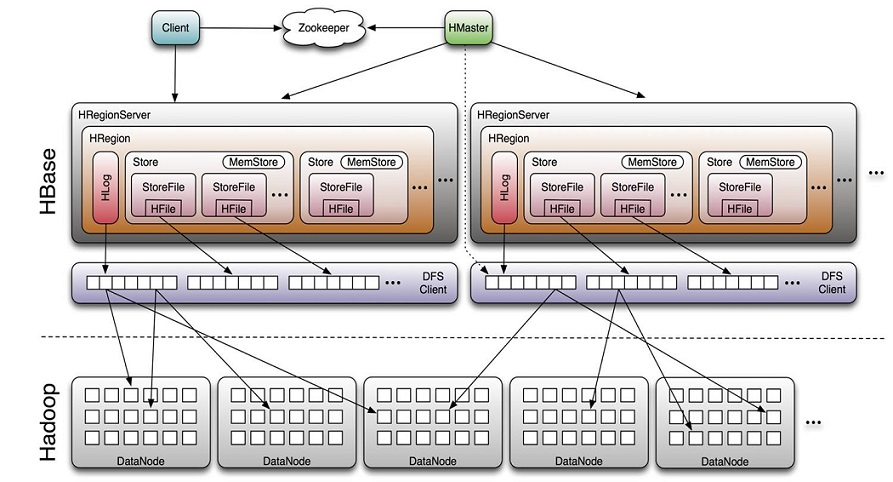
1.6 HBase体系架构

img

Client

  • 包含访问HBase的接口并维护cache来加快对HBase的访问

Zookeeper

  • 保证任何时候,集群中只有一个master
  • 存贮所有Region的寻址入口。
  • 实时监控Region server的上线和下线信息。并实时通知Master
  • 存储HBase的schema和table元数据

Master

  • 为Region server分配region
  • 负责Region server的负载均衡
  • 发现失效的Region server并重新分配其上的region
  • 管理用户对table的增删改操作

RegionServer

  • Region server维护region,处理对这些region的IO请求
  • Region server负责切分在运行过程中变得过大的region

HLog(WAL log)

  • HLog文件就是一个普通的Hadoop Sequence File,Sequence File 的Key是 HLogKey对象,HLogKey中记录了写入数据的归属信息,除了table和 region名字外,同时还包括sequence number和timestamp,timestamp是” 写入时间”,sequence number的起始值为0,或者是最近一次存入文件系 统中sequence number。
  • HLog SequeceFile的Value是HBase的KeyValue对象,即对应HFile中的 KeyValue

Region

  • HBase自动把表水平划分成多个区域(region),每个region会保存一个表 里面某段连续的数据;每个表一开始只有一个region,随着数据不断插 入表,region不断增大,当增大到一个阀值的时候,region就会等分会 两个新的region(裂变);
  • 当table中的行不断增多,就会有越来越多的region。这样一张完整的表 被保存在多个Regionserver上。

Memstore 与 storefile

  • 一个region由多个store组成,一个store对应一个CF(列族)
  • store包括位于内存中的memstore和位于磁盘的storefile写操作先写入 memstore,当memstore中的数据达到某个阈值,hregionserver会启动 flashcache进程写入storefile,每次写入形成单独的一个storefile
  • 当storefile文件的数量增长到一定阈值后,系统会进行合并(minor、 major compaction),在合并过程中会进行版本合并和删除工作 (majar),形成更大的storefile。
  • 当一个region所有storefile的大小和超过一定阈值后,会把当前的region 分割为两个,并由hmaster分配到相应的regionserver服务器,实现负载均衡。
  • 客户端检索数据,先在memstore找,找不到再找storefile
  • HRegion是HBase中分布式存储和负载均衡的最小单元。最小单元就表 示不同的HRegion可以分布在不同的HRegion server上。
  • HRegion由一个或者多个Store组成,每个store保存一个columns family。
  • 每个Strore又由一个memStore和0至多个StoreFile组成。

2. 安装搭建hadoop

2.1 配置说明

本次集群搭建共三台机器,具体说明下:

主机名 IP 说明
hadoop01 192.168.154.130 DataNode、NodeManager、ResourceManager、NameNode
hadoop02 192.168.154.131 DataNode、NodeManager、SecondaryNameNode
hadoop03 192.168.154.132 DataNode、NodeManager

2.2 安装前准备

2.2.1 机器配置说明

发行版:

1
cat /etc/redhat-release

image-20240126182118106

内核版本:

1
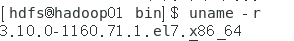
uname -r

image-20240126182259980

注:本集群内所有进程均由hdfs用户启动;要在集群所有服务器都进行操作。

2.2.2 关闭selinux、防火墙

SELinux(Security-Enhanced Linux)是一个 Linux 内核模块,它为 Linux 系统提供了强制访问控制(MAC)机制。SELinux 最初由美国国家安全局(NSA)开发,并且现在是许多 Linux 发行版(如 Fedora、RHEL、CentOS 等)的一部分。

在默认的 Linux 安全模型中,用户和程序主要通过文件权限(即,读取、写入和执行权限)来控制对资源的访问。然而,这种模型可能会被恶意程序利用,例如,如果一个程序被设计为以 root 用户身份运行,那么它就可以访问系统上的任何文件。

SELinux 通过实施更详细和精细的访问控制策略来解决这个问题。例如,即使一个程序以 root 用户身份运行,SELinux 也可以限制它只能访问特定的文件和资源。这种安全模型可以防止或至少减轻某些类型的系统攻击,如缓冲区溢出攻击。

然而,SELinux 的配置和管理可能会比较复杂,因为它需要详细的安全策略。因此,一些用户可能会选择关闭 SELinux,尽管这可能会降低系统的安全性。

在 Linux 系统中,你可以通过以下步骤来临时或永久关闭 SELinux:

临时关闭 SELinux:

你可以使用 setenforce 命令来临时关闭 SELinux。这个命令会立即生效,但在系统重启后,SELinux 会再次被启用。在终端中输入以下命令:

1
sudo setenforce 0

这里,0 表示关闭 SELinux,1 表示开启 SELinux。

永久关闭 SELinux:

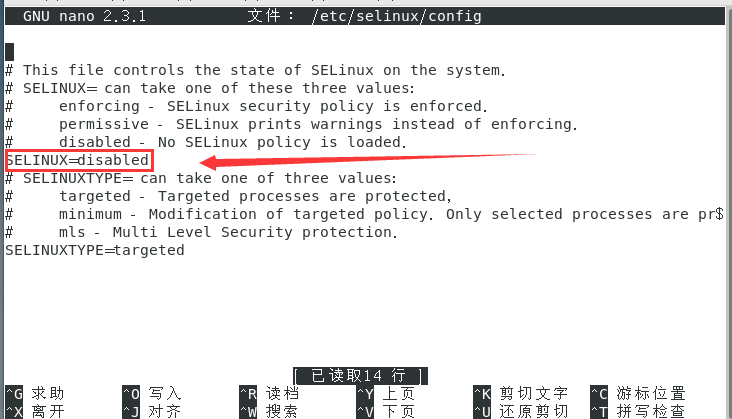
如果你想要永久关闭 SELinux,你需要编辑 /etc/selinux/config 文件。在这个文件中,你会找到 SELINUX 这一行,你可以将其值设置为 disabled 来关闭 SELinux。以下是具体的步骤:

  1. 打开 /etc/selinux/config 文件:
1
sudo nano /etc/selinux/config
  1. 找到 SELINUX 这一行,将其值改为 disabled:
1
SELINUX=disabled

image-20240126183004320

  1. 保存并关闭文件。
  2. 重启你的系统以使更改生效:
1
sudo reboot
1
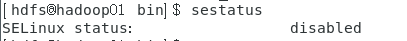
sestatus

image-20240126182832390

关闭防火墙

在 CentOS 系统中,你可以使用 firewall-cmd 命令来管理防火墙。以下是关闭防火墙的步骤:

临时关闭防火墙:

你可以使用以下命令来临时关闭防火墙,这个命令会立即生效,但在系统重启后,防火墙会再次被启用:

1
sudo systemctl stop firewalld

永久关闭防火墙:

如果你想要永久关闭防火墙,你需要使用 systemctl 命令来禁用 firewalld 服务。以下是具体的步骤:

  1. 使用以下命令停止 firewalld 服务:
1
sudo systemctl stop firewalld
  1. 使用以下命令禁用 firewalld 服务:
1
sudo systemctl disable firewalld

这样,即使在系统重启后,防火墙也不会再次启动。

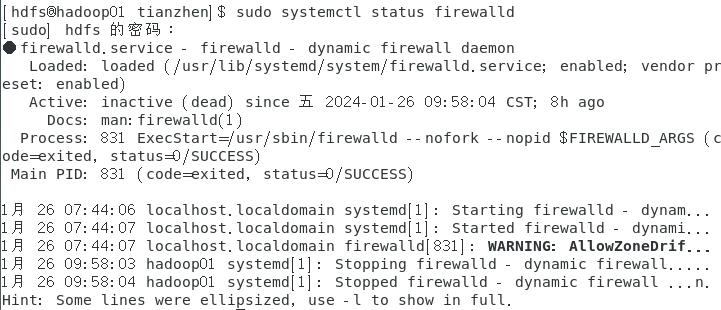
查看防火墙是否关闭

1
sudo systemctl status firewalld

image-20240126183648528

查看重启后还会不会自动启动

1
sudo systemctl is-enabled firewalld

如果这个命令返回 “disabled”,那么防火墙在系统重启后不会自动启动。如果它返回 “enabled”,那么防火墙在系统重启后会自动启动。

2.2.3 准备用户

因为Hadoop启动时默认以非root启动,以root启动会有各种报错,难以解决,所以我们需要创建一个普通用户

创建用户

1
sudo useradd hdfs

设置密码

1
sudo passwd hdfs

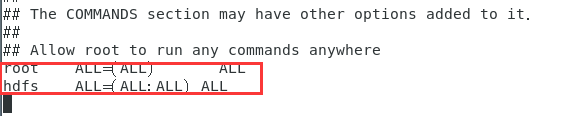
加入sudoers

以便可以使用sudo命令

1
sudo visudo

找到类似于以下的行:

1
root    ALL=(ALL:ALL) ALL

在这一行下面,添加一个新的行,将 “hdfs” 替换为你想要添加的用户名:

1
hdfs    ALL=(ALL:ALL) ALL

image-20240126185145185

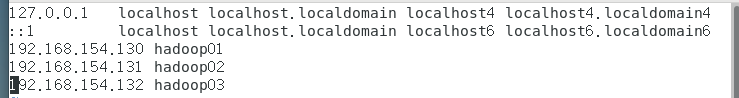
2.2.4 修改hosts文件,域名解析

1
sudo vim /etc/hosts

添加以下行:

1
2
3
192.168.154.130 hadoop01
192.168.154.131 hadoop02
192.168.154.132 hadoop03

(每个人不同)

image-20240126185445948

2.2.5 同步时间

1
2
sudo yum -y install ntpdate
sudo ntpdate cn.pool.ntp.org

2.2.6 ssh互信配置

注:要在集群所有服务器都进行操作

(1)生成密钥对,一直回车即可

1
ssh-keygen

默认RSA,创建ed25519也行,但是RSA这里复制公钥方便一丢丢。

(2)保证每台服务器各自都有对方的公钥(包括自己)

1
2
3
ssh-copy-id hdfs@hadoop01
ssh-copy-id hdfs@hadoop02
ssh-copy-id hdfs@hadoop03

(3)验证无秘钥认证登录

1
2
3
ssh hdfs@hadoop01
ssh hdfs@hadoop02
ssh hdfs@hadoop03

2.3 配置jdk

从CentOS的yum源安装或者自己下载解压安装都可以

yum安装

1
2
sudo yum update
sudo yum install java-1.8.0-openjdk-devel

查看安装目录:

1
readlink -f $(which java)

image-20240126200311094

设置JAVA_HOME:

1
export JAVA_HOME=/usr/lib/jvm/java-1.8.0-openjdk-1.8.0.392.b08-2.el7_9.x86_64

验证JAVA_HOME:

1
echo $JAVA_HOME

image-20240126200428768

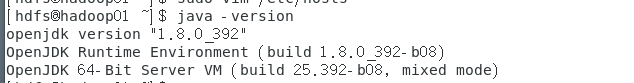
查看版本:

1
java -version

image-20240126191803042

下载解压安装

自行下载或者上传一个jdk包,解压:

1
tar -xvf jdk-8u201-linux-x64.tar.gz -C /usr/local

授权:

1
chown hdfs.hdfs -R /usr/local/jdk1.8.0_201/

软连接:

1
ln -s /usr/local/jdk1.8.0_201/ /usr/local/jdk

配置环境变量:

1
sudo vim /etc/profile.d/jdk.sh

添加以下行:

1
2
export JAVA_HOME=/usr/local/jdk
PATH=$JAVA_HOME/bin:$JAVA_HOME/jre/bin:$PATH

使生效:

1
source /etc/profile.d/jdk.sh

验证:

1
java -version
1
2
3
java version "1.8.0_201"
Java(TM) SE Runtime Environment (build 1.8.0_201-b09)
Java HotSpot(TM) 64-Bit Server VM (build 25.201-b09, mixed mode)

2.4 安装Hadoop

CentOS自带的yum不含Hadoop的资源,所以我们要手动下载:

下载:

1
wget https://dlcdn.apache.org/hadoop/common/hadoop-3.3.6/hadoop-3.3.6-src.tar.gz

解压到~下:

1
tar -xvf hadoop-3.3.6.tar.gz -C ~/

授权:

1
chown hdfs.hdfs -R ~/hadoop-3.3.6

这只是一台的配置,等会配置完直接通过scp复制到其他节点

3. 配置启动hadoop

3.1 hadoop-env.sh 配置hadoop环境变量

1
2
cd ~/hadoop-3.3.6/etc/hadoop/
vim hadoop-env.sh

添加如下行:

1
2
3
export JAVA_HOME=/usr/local/jdk
export HADOOP_HOME=~/hadoop-3.3.6
export HADOOP_CONF_DIR=${HADOOP_HOME}/etc/hadoop

如果之前通过yum安装的jdk,你应该查找jdk安装目录:

1
readlink -f $(which java)

image-20240126195443067

那么JAVA_HOME就为/usr/lib/jvm/java-1.8.0-openjdk-1.8.0.392.b08-2.el7_9.x86_64(安装目录)

3.2 core-site.xml 配置HDFS

1
vim core-site.xml
1
2
3
4
5
6
7
8
9
10
11
12
<configuration>
<!-- 指定HDFS默认(namenode)的通信地址 -->
<property>
<name>fs.defaultFS</name>
<value>hdfs://hadoop01:9000</value>
</property>
<!-- 指定hadoop运行时产生文件的存储路径 -->
<property>
<name>hadoop.tmp.dir</name>
<value>/data/hadoop/tmp</value>
</property>
</configuration>

3.3 hdfs-site.xml 配置namenode

1
vim hdfs-site.xml
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
<configuration>
<!-- 设置namenode的http通讯地址 -->
<property>
<name>dfs.namenode.http-address</name>
<value>hadoop01:50070</value>
</property>

<!-- 设置secondarynamenode的http通讯地址 -->
<property>
<name>dfs.namenode.secondary.http-address</name>
<value>hadoop02:50090</value>
</property>

<!-- 设置namenode存放的路径 -->
<property>
<name>dfs.namenode.name.dir</name>
<value>/data/hadoop/name</value>
</property>

<!-- 设置hdfs副本数量 -->
<property>
<name>dfs.replication</name>
<value>2</value>
</property>
<!-- 设置datanode存放的路径 -->
<property>
<name>dfs.datanode.data.dir</name>
<value>/data/hadoop/datanode</value>
</property>

<property>
<name>dfs.permissions</name>
<value>false</value>
</property>
</configuration>
1
2
sudo mkdir /data/hadoop/name -p
sudo mkdir /data/hadoop/datanode -p

3.4 mapred-site.xml 配置框架

1
vim mapred-site.xml
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
<configuration>
<!-- 通知框架MR使用YARN -->
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
<property>
<name>mapreduce.application.classpath</name>
<value>
/usr/local/hadoop/etc/hadoop,
/usr/local/hadoop/share/hadoop/common/*,
/usr/local/hadoop/share/hadoop/common/lib/*,
/usr/local/hadoop/share/hadoop/hdfs/*,
/usr/local/hadoop/share/hadoop/hdfs/lib/*,
/usr/local/hadoop/share/hadoop/mapreduce/*,
/usr/local/hadoop/share/hadoop/mapreduce/lib/*,
/usr/local/hadoop/share/hadoop/yarn/*,
/usr/local/hadoop/share/hadoop/yarn/lib/*
</value>
</property>
</configuration>

3.5 yarn-site.xml 配置resourcemanager

1
vim yarn-site.xml
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
<configuration>
<property>
<name>yarn.resourcemanager.hostname</name>
<value>hadoop01</value>
</property>

<property>
<description>The http address of the RM web application.</description>
<name>yarn.resourcemanager.webapp.address</name>
<value>${yarn.resourcemanager.hostname}:8088</value>
</property>

<property>
<description>The address of the applications manager interface in the RM.</description>
<name>yarn.resourcemanager.address</name>
<value>${yarn.resourcemanager.hostname}:8032</value>
</property>

<property>
<description>The address of the scheduler interface.</description>
<name>yarn.resourcemanager.scheduler.address</name>
<value>${yarn.resourcemanager.hostname}:8030</value>
</property>

<property>
<name>yarn.resourcemanager.resource-tracker.address</name>
<value>${yarn.resourcemanager.hostname}:8031</value>
</property>

<property>
<description>The address of the RM admin interface.</description>
<name>yarn.resourcemanager.admin.address</name>
<value>${yarn.resourcemanager.hostname}:8033</value>
</property>
</configuration>

3.6 配置masters & slaves

1
2
echo 'hadoop01' >> ~/hadoop-3.3.6/etc/hadoop/masters
echo 'hadoop02 hadoop03' >> ~/hadoop-3.3.6/etc/hadoop/slaves

3.7 启动前准备

3.7.1 准备启动脚本

启动脚本文件全部位于 ~/hadoop-3.3.6/sbin/ 文件夹下:

(1)修改 start-dfs.sh 和 stop-dfs.sh 文件添加:

1
2
3
4
HDFS_DATANODE_USER=hdfs
HADOOP_SECURE_DN_USER=hdfs
HDFS_NAMENODE_USER=hdfs
HDFS_SECONDARYNAMENODE_USER=hdfs

(2)修改start-yarn.sh 和 stop-yarn.sh文件添加:

1
2
3
YARN_RESOURCEMANAGER_USER=hdfs
HADOOP_SECURE_DN_USER=hdfs
YARN_NODEMANAGER_USER=hdfs

3.7.2 授权

1
2
sudo chown -R hdfs.hdfs ~/hadoop-3.3.6/
sudo chown -R hdfs.hdfs /data/hadoop/

3.7.3 配置hadoop命令环境变量

1
sudo vim /etc/profile.d/hadoop.sh

添加如下:

1
2
export HADOOP_HOME=~/hadoop-3.3.6
PATH=$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$PATH

3.7.4 集群初始化

我们在hadoop01上修改了hadoop-3.3.6下的很多文件,现在要同步到hadoop02和hadoop03

使用scp命令:

1
2
scp -r ~/hadoop-3.3.6 hadoop02:~/
scp -r ~/hadoop-3.3.6 hadoop03:~/

3.8 启动Hadoop集群

3.8.1 第一次启动前需要格式化,集群所有服务器都需要

1
hdfs namenode -format

3.8.2 启动并验证集群

(1)启动namenode、datanode

三台都需要:

1
start-dfs.sh

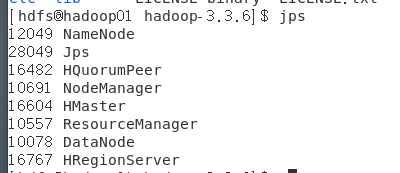
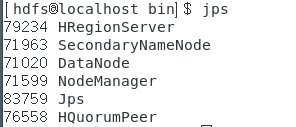
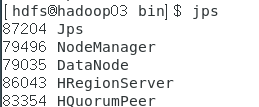
查看进程:

1
jps

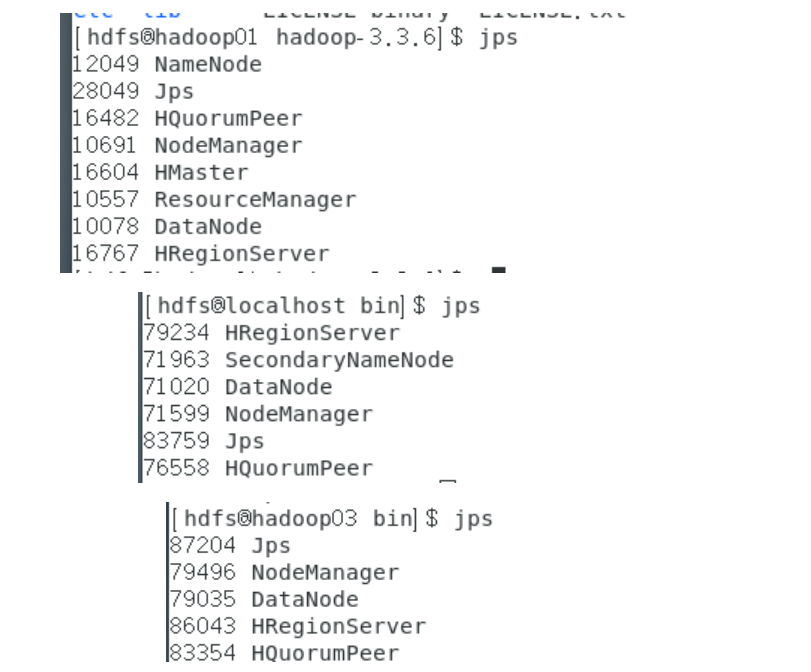
image-20240126204444006

image-20240126204542442

image-20240126204657107

这里的截图也包含了后面的hbase进程

(2)启动YARN

三台都需要:

1
start-yarn.sh

查看进程:

1
jps

同上,一次截完了

3.9 集群启动成功

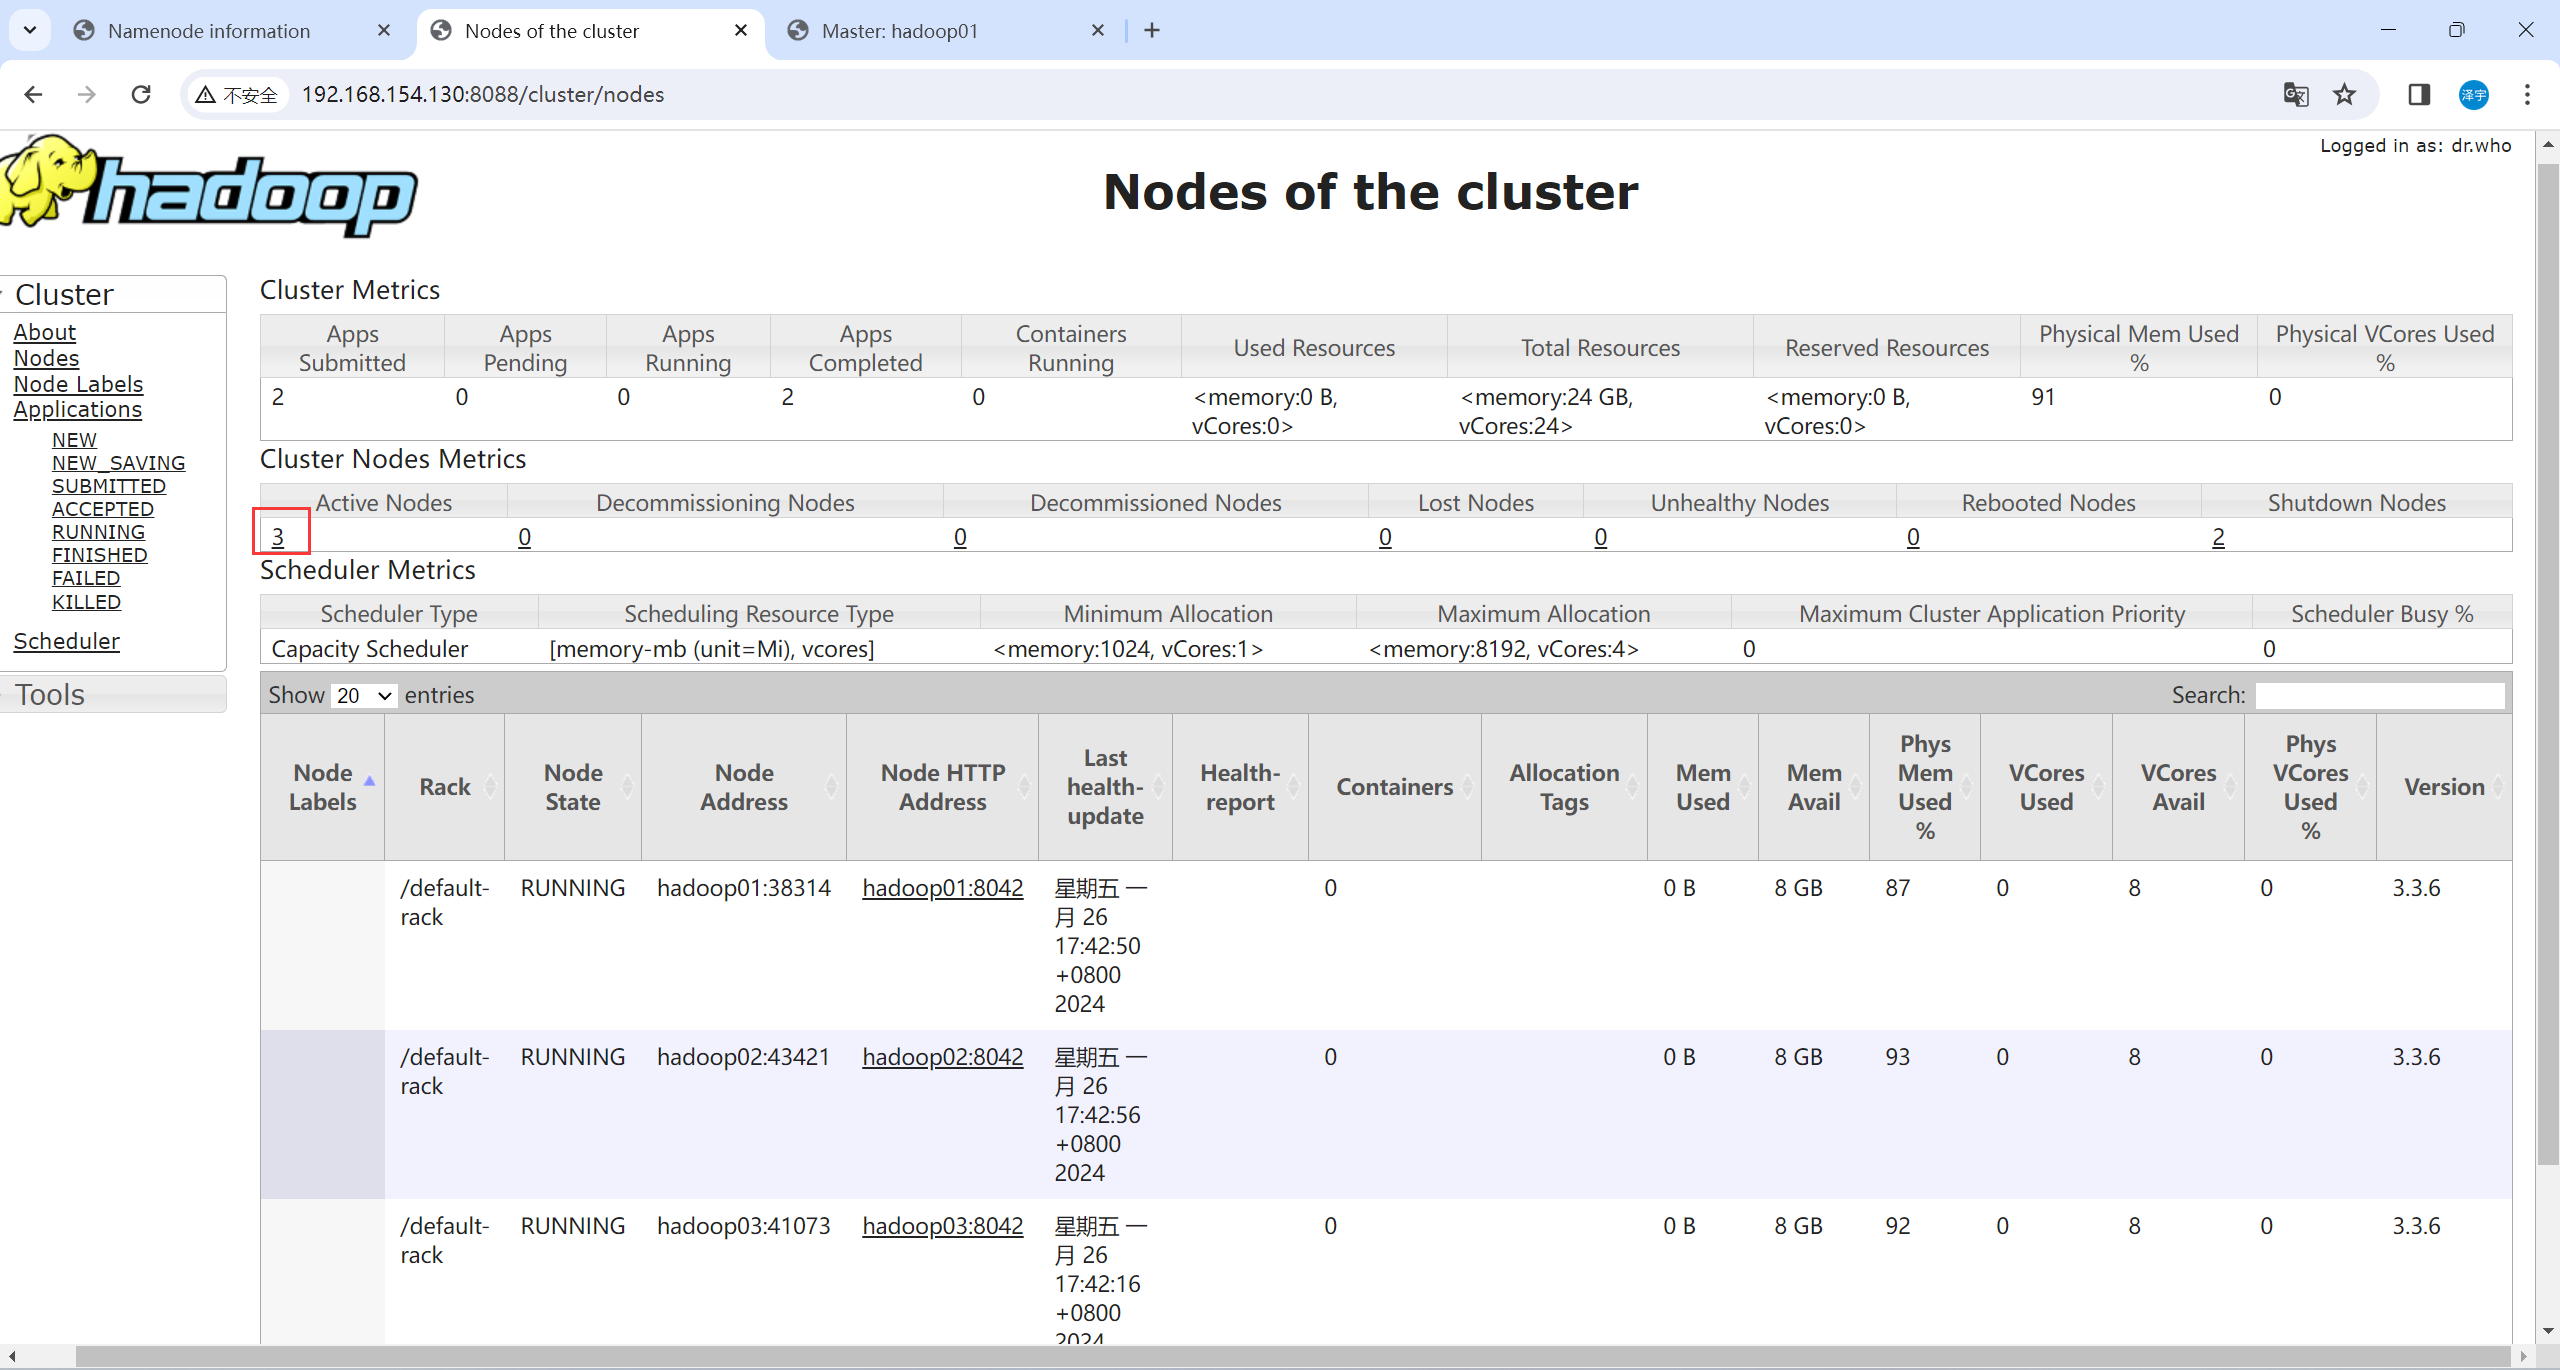
(1)网页访问:http://hadoop01:8088

该页面为ResourceManager 管理界面,在上面可以看到集群中的三台Active Nodes:

image-20240126205252646

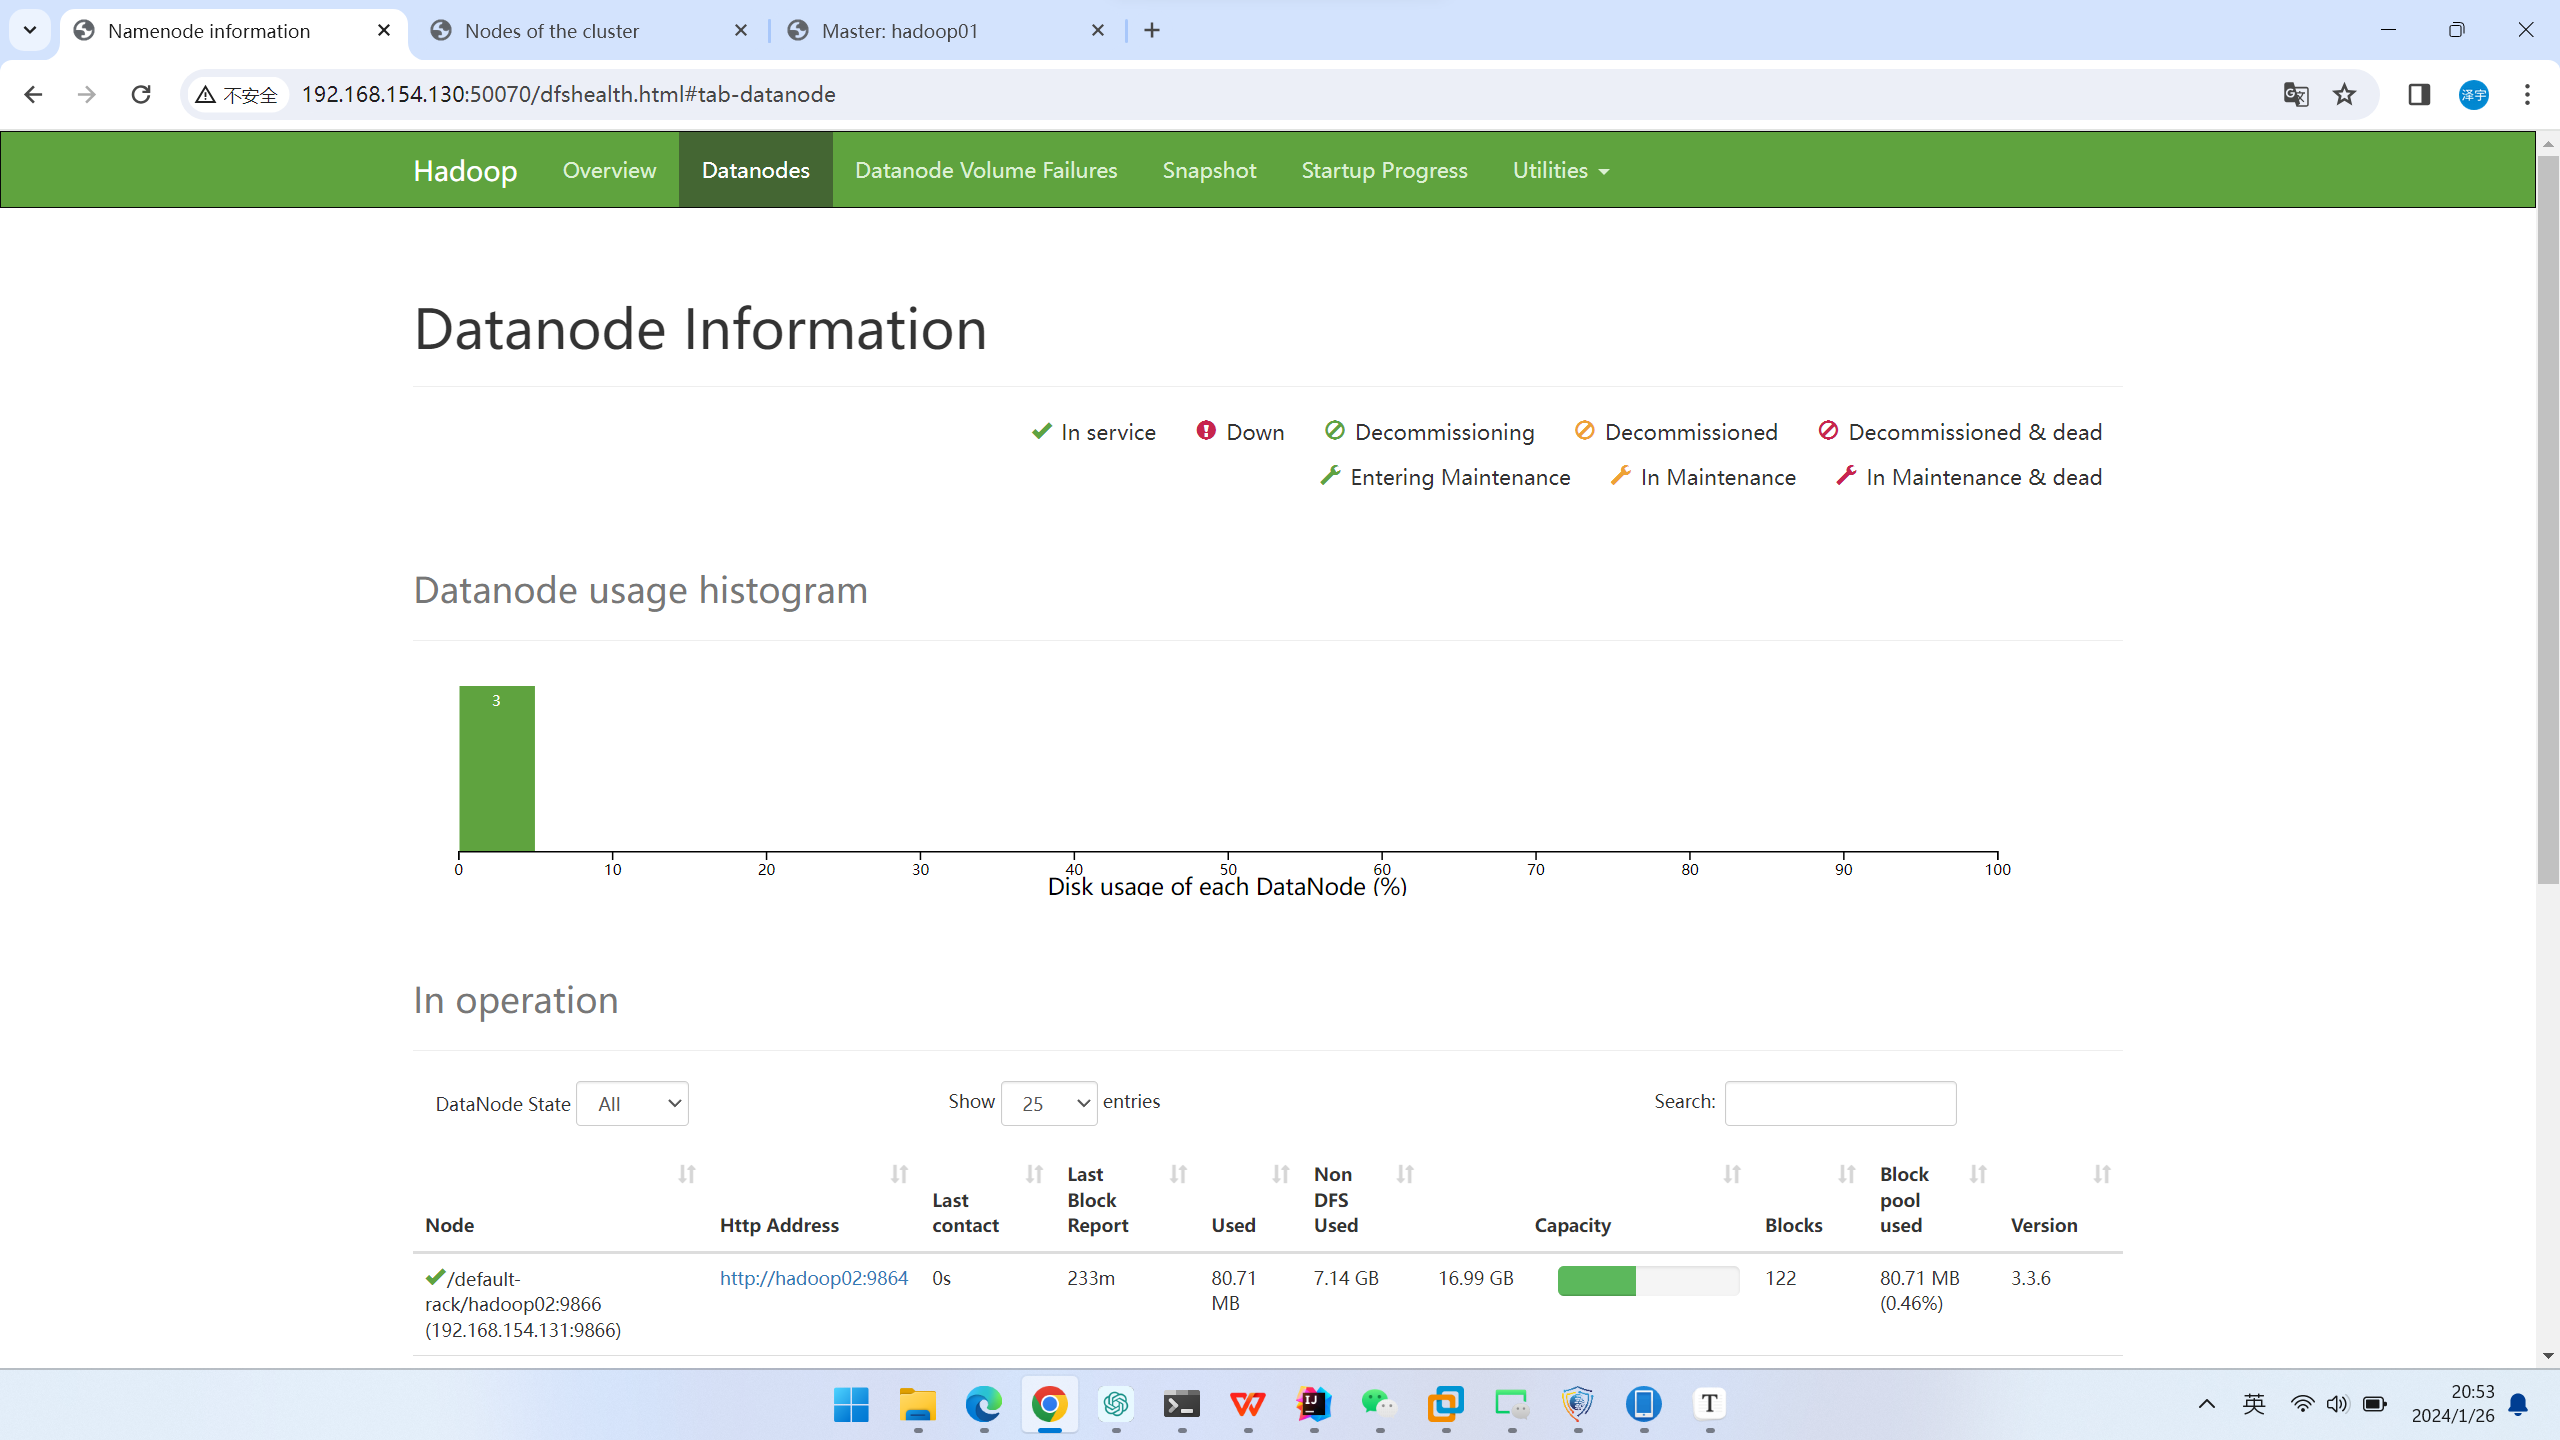
(2)网页访问:http://hadoop01:50070/dfshealth.html#tab-datanode

该页面为NameNode管理页面:

image-20240126205344804

到此hadoop集群已经搭建完毕!!!

4. 安装配置Hbase

4.1 安装HBase

下载:

1
wget https://mirrors.tuna.tsinghua.edu.cn/apache/hbase/2.5.7/hbase-2.5.7-bin.tar.gz

解压:

1
tar -xvf hbase-2.5.7-bin.tar.gz -C ~/hbase-2.5.7

授权:

1
sudo chown -R hdfs.hdfs ~/hbase-2.5.7/

4.2 配置HBase

4.2.1 hbase-env.sh 配置hbase环境变量

1
2
cd ~/hbase-2.5.7/conf/
vim vim hbase-env.sh
1
2
export JAVA_HOME=/usr/local/jdk
export HBASE_CLASSPATH=~/hbase-2.5.7/conf

4.2.2 hbase-site.xml 配置hbase

1
vim hbase-site.xml
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
<configuration>
<property>
<name>hbase.rootdir</name>
<!-- hbase存放数据目录 -->
<value>hdfs://hadoop01:9000/hbase/hbase_db</value>
<!-- 端口要和Hadoop的fs.defaultFS端口一致-->
</property>
<property>
<name>hbase.cluster.distributed</name>
<!-- 是否分布式部署 -->
<value>true</value>
</property>
<property>
<name>hbase.zookeeper.quorum</name>
<!-- zookooper 服务启动的节点,只能为奇数个 -->
<value>hadoop01,hadoop02,hadoop03</value>
</property>
<property>
<!--zookooper配置、日志等的存储位置,必须为以存在 -->
<name>hbase.zookeeper.property.dataDir</name>
<value>/data/hbase/zookeeper</value>
</property>
<property>
<!--hbase master -->
<name>hbase.master</name>
<value>hadoop01</value>
</property>
<property>
<!--hbase web 端口 -->
<name>hbase.master.info.port</name>
<value>16666</value>
</property>
</configuration>

注:zookeeper有这样一个特性:

  • 集群中只要有过半的机器是正常工作的,那么整个集群对外就是可用的。
  • 也就是说如果有2个zookeeper,那么只要有1个死了zookeeper就不能用了,因为1没有过半,所以2个zookeeper的死亡容忍度为0;
  • 同理,要是有3个zookeeper,一个死了,还剩下2个正常的,过半了,所以3个zookeeper的容忍度为1;
  • 再多列举几个:2->0 ; 3->1 ; 4->1 ; 5->2 ; 6->2 会发现一个规律,2n和2n-1的容忍度是一样的,都是n-1,所以为了更加高效,何必增加那一个不必要的zookeeper

4.2.3 指定集群节点

1
vim regionservers

添加如下:

1
2
3
hadoop01
hadoop02
hadoop03

5. 启动Hbase集群

5.1 配置hbase命令环境变量

1
sudo vim /etc/profile.d/hbase.sh

添加如下:

1
2
export HBASE_HOME=~/hbase-2.5.7
PATH=$HBASE_HOME/bin:$PATH

5.2 启动前准备

1
2
sudo mkdir -p /data/hbase/zookeeper
vim /data/hbase/rsync.sh

添加以下内容:

1
2
3
4
5
6
7
8
9
10
11
for i in hadoop02 hadoop03
do
sudo rsync -a /data/hbase $i:/data/
sudo scp -p /etc/profile.d/hbase.sh $i:/etc/profile.d/
done

#复制hbase配置到其他机器
for i in hadoop02 hadoop03
do
sudo rsync -a ~/hbase-2.5.6 $i:~/hbase-2.5.6
done

授权:

1
sudo chown -R hdfs.hdfs /data/hbase

启动复制脚本:

1
./data/hbase/rsync.sh

5.3 启动hbase

注:只需在hadoop01服务器上操作即可。

(1)启动

1
start-hbase.sh

(2)验证

1
jps

image-20240126211709277

同上Hadoop

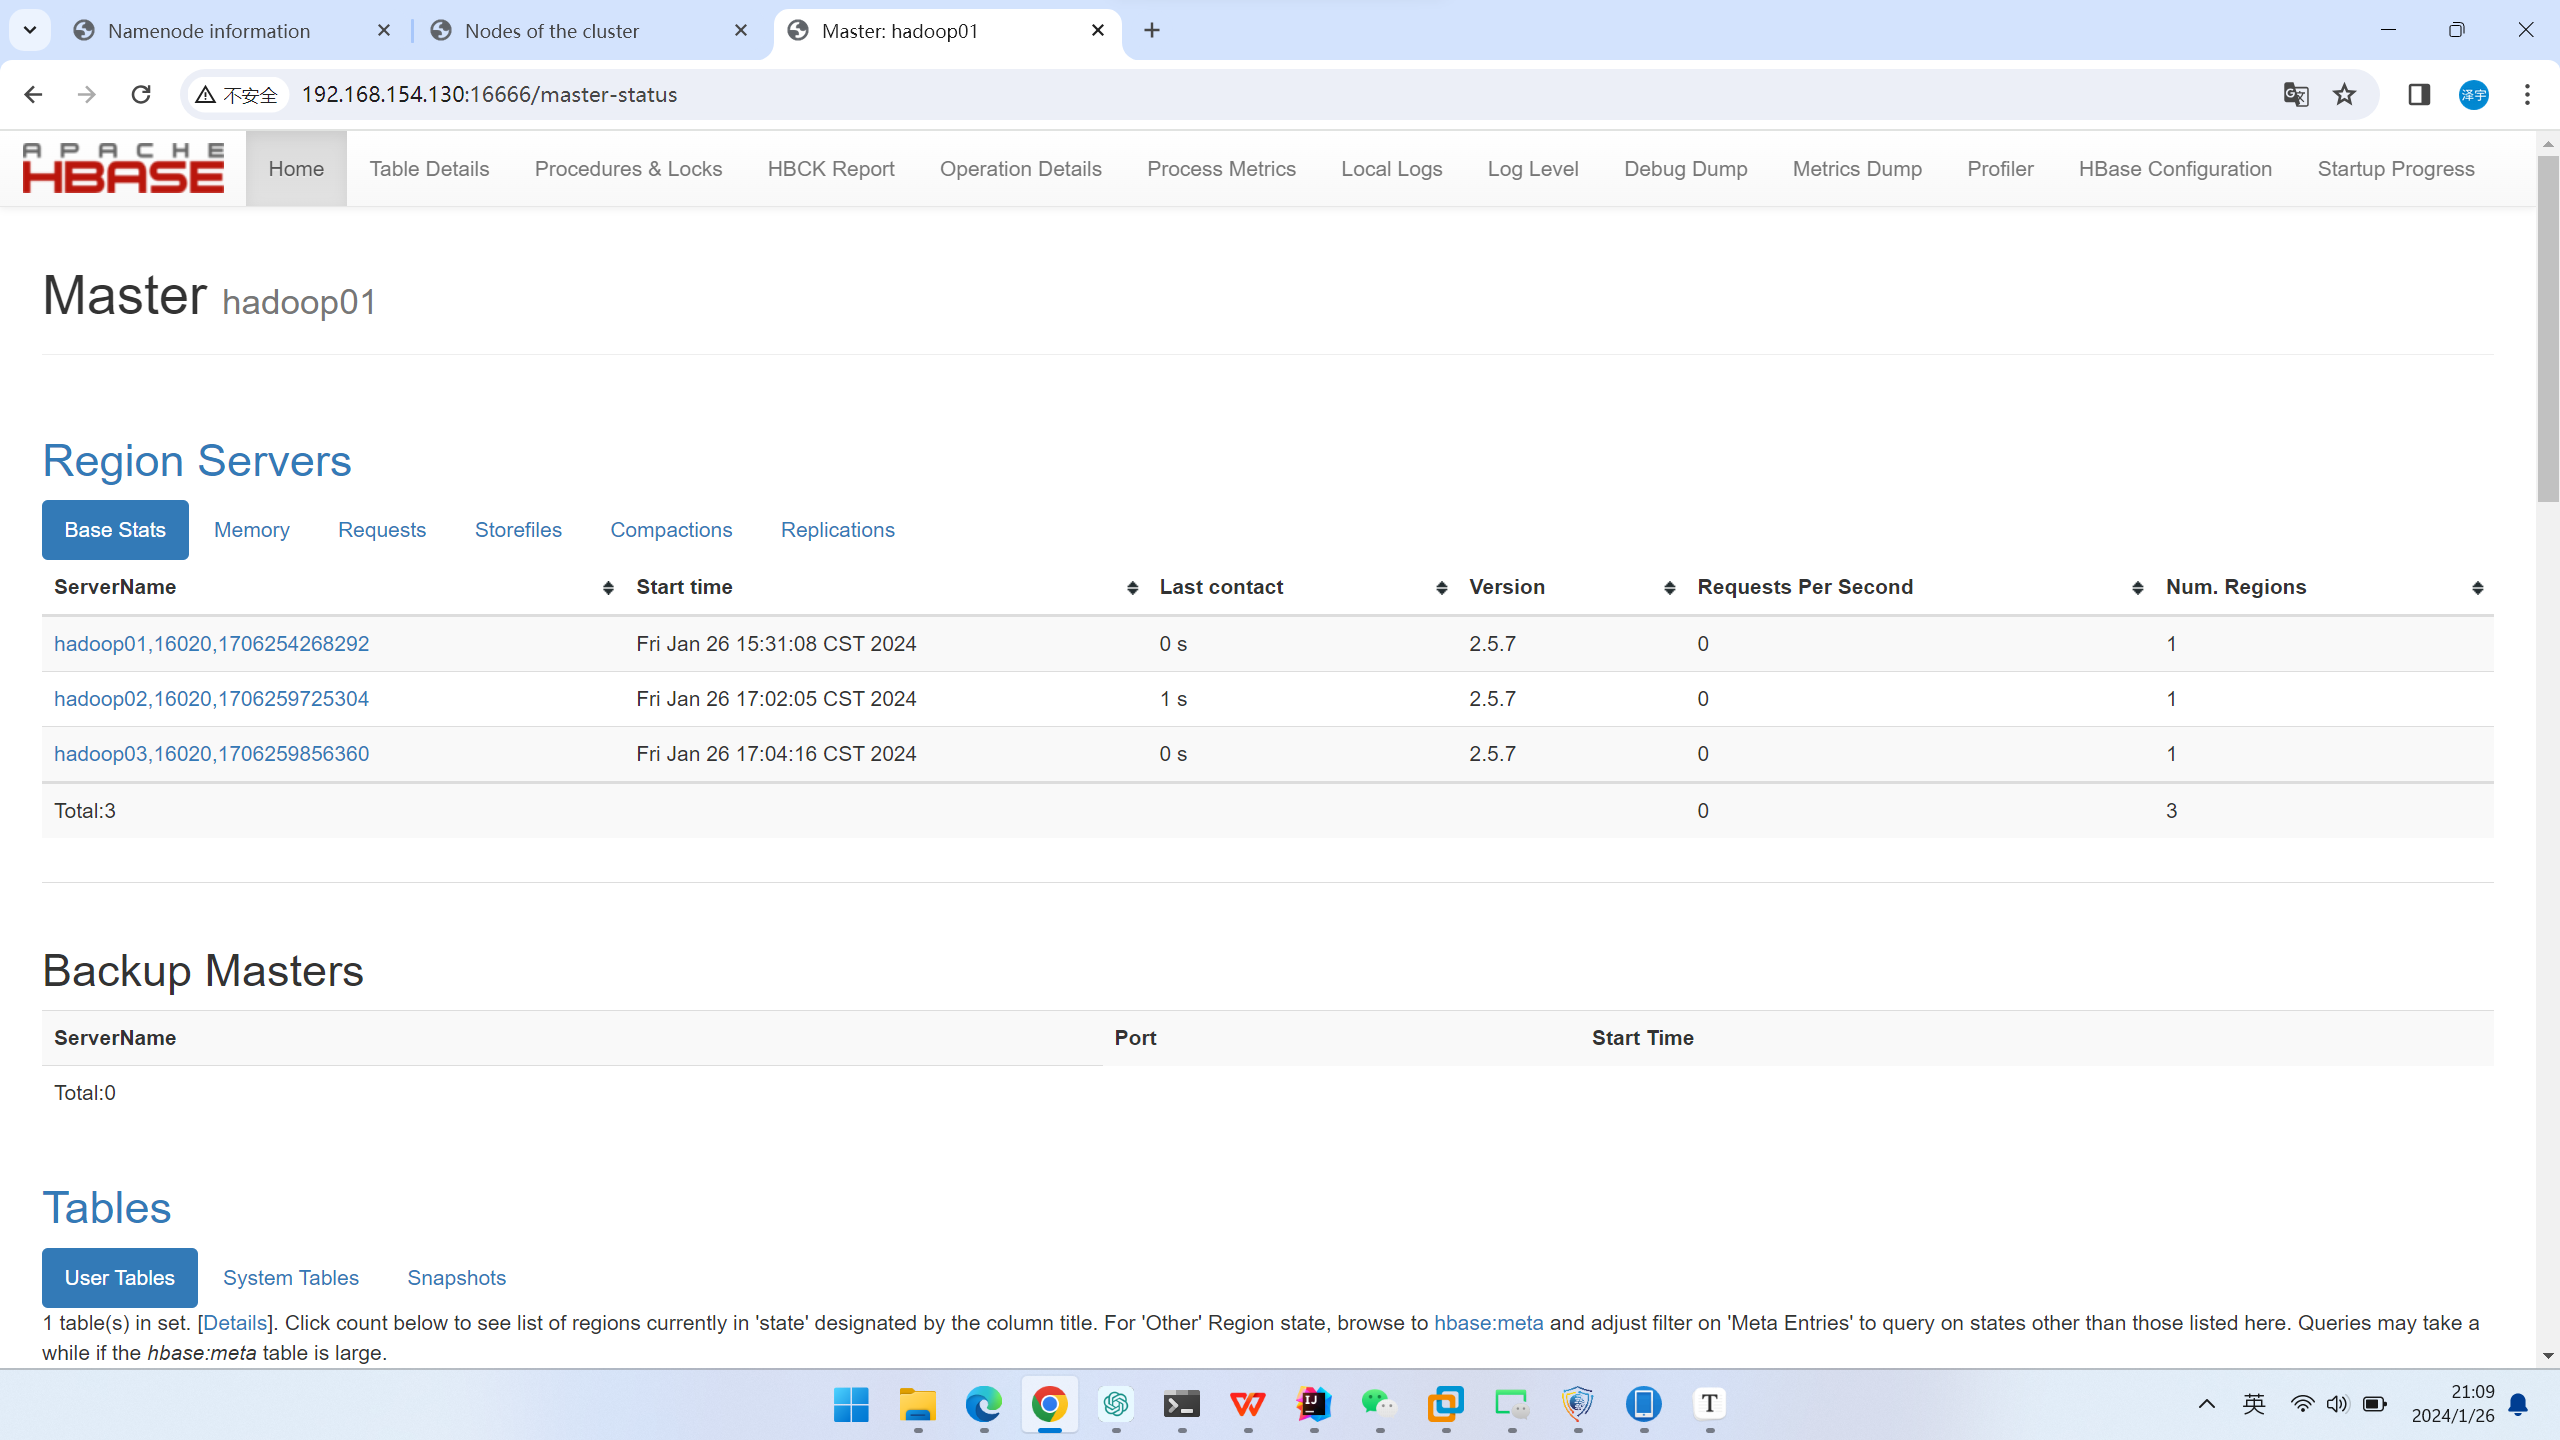
5.4 页面查看hbase状态

网页访问http://hadoop01:16666

image-20240126210922766

6. 后续及其总结

安装之后可以进行后面的操作,如建表,修改HBase表,等等。

进行各种环境变量配置时一定要细心,每进行到一个阶段都推荐使用快照保存一下。

虽然配环境真的头大,但是也复习了很多Linux基础命令。

常用的公钥加密和签名算法:

在配置SSH免密登录的时候,一般会用到几种常用的公钥加密和签名算法:

  • RSA:RSA是最早的公钥加密和签名算法之一,它在许多协议和系统中被广泛使用,包括HTTPS、SSH、OpenPGP、S/MIME等。然而,RSA需要比较大的密钥(通常是2048位或更大)才能提供足够的安全性,而且它的加密和签名操作相对较慢。

  • ECDSA:ECDSA是基于椭圆曲线密码学的签名算法,它比RSA更高效,可以提供相同的安全性但需要更小的密钥。ECDSA在许多现代的协议和系统中被广泛使用,包括Bitcoin、Ethereum、TLS 1.3、SSH等。然而,ECDSA的安全性取决于其参数的选择,如果选择不当,可能会降低其安全性。

  • ED25519:ED25519是一种新的签名算法,它基于椭圆曲线密码学,但设计得更简单、更安全。ED25519比ECDSA更不容易受到侧信道攻击,而且它的性能也非常好。ED25519在一些新的系统和协议中被广泛使用,包括OpenSSH 7.0、Tor、Signal等。”25519”这个数字的来源是这样的:Curve25519是一种特定的椭圆曲线,它的名字来源于它的模数p,p是一个接近$2^{255}的质数,具体来说,p=2^{255}-19$,因此得名”25519”。

    这种曲线被选中的原因是它在安全性和性能之间提供了一个很好的平衡。它的设计者,Daniel J. Bernstein,特意选择了这个参数,以便在现代硬件上实现高效的加密操作,同时还能抵抗已知的加密攻击。

注意:公钥加密和签名算法是两种不同但相关的密码学技术,它们都依赖于公钥和私钥的概念。

  • 公钥加密:这是一种加密方法,其中有两个密钥:公钥和私钥。公钥用于加密数据,而私钥用于解密数据。这意味着任何人都可以使用公钥加密信息,但只有拥有相应私钥的人才能解密这些信息。这种方法通常用于保护信息的机密性。RSA和ElGamal是公钥加密的例子。
  • 签名算法:这是一种用于验证信息来源和完整性的方法。在这种情况下,私钥用于生成数字签名,而公钥用于验证签名。这意味着只有拥有私钥的人才能生成有效的签名,但任何人都可以使用公钥来验证签名。这种方法通常用于防止信息被篡改或伪造。RSA和ECDSA(Elliptic Curve Digital Signature Algorithm)是签名算法的例子。

值得注意的是,有些算法,如RSA,既可以用于公钥加密,也可以用于签名。然而,有些算法,如ECDSA和ED25519,只用于签名。

我们用的最多的是RSA,但是很老旧了,必须依靠比较长的密钥才能保证其安全性,就算这样,它的安全性也不如ED25519了,性能也不如,在进行大量的加密解密运算时,性能的差异就会体现出来。

怎么生成公私钥?

1. RSA

1
ssh-keygen -t rsa -b 2048 -C "your_email@example.com"

这个命令的含义是:

  • ssh-keygen:是一个在Unix和类Unix系统(如Linux和Mac OS)中用于生成、管理和转换认证密钥的工具。它是SSH(Secure Shell)协议的一部分,SSH是一种用于安全远程登录和其他安全网络服务的协议。

    ssh-keygen可以生成几种类型的认证密钥,包括RSA、DSA、ECDSA、ED25519等。生成的密钥对包括一个私钥和一个公钥。私钥必须保密,而公钥可以公开。当你想要通过SSH连接到一个服务器时,你可以将你的公钥添加到服务器的授权密钥列表中。然后,当你尝试连接时,服务器会使用你的公钥来加密一个挑战消息,只有持有相应私钥的人才能解密。这样,服务器就可以确认你是你声称的人,而无需你发送密码。

  • -t rsa:指定要生成的密钥类型为RSA。

  • -b 2048:指定密钥长度为2048位。在生成RSA密钥对时,你可以选择密钥的长度。密钥的长度决定了加密的强度:密钥越长,破解的难度就越大。然而,密钥长度的增加也会导致加密和解密的计算复杂度增加,因此需要在安全性和性能之间找到一个平衡。

    2048位是目前广泛接受的RSA密钥长度。它提供了足够的安全性,同时在大多数系统上的性能也是可以接受的。对于大多数用途来说,2048位的RSA密钥已经足够安全。

    然而,如果你正在处理极度敏感的信息,或者你的系统可以承受更高的计算负载,你也可以选择使用更长的密钥,如3072位或4096位。但是,这可能会导致性能下降,并且在许多情况下,2048位的密钥已经足够安全。

    需要注意的是,随着计算能力的提高,未来可能需要更长的密钥来保持相同的安全级别。因此,你应该定期评估你的加密需求,并在必要时更新你的密钥。

  • -C "your_email@example.com":添加一个注释,"your_email@example.com"就是你添加的注释。当然,你可以将这个字符串替换为任何有助于你识别密钥的信息。注释并不会影响密钥的功能,它只是一个标签,用于帮助你管理你的密钥。

按回车键,你将被提示输入一个文件名,这将是你的私钥文件的名称。如果你只是按回车键而不输入任何内容,那么私钥将被保存在默认的.ssh/id_rsa文件中。

你将被提示输入一个密码。这是一个可选步骤,如果你不想为你的私钥设置密码,你可以直接按回车键,如果设置了密码以后每次ssh登录时都要输入密码。

2. ECDSA

1
ssh-keygen -t ecdsa -b 256
  • -t ecdsa指定了密钥类型为ECDSA。
  • -b 256指定了密钥长度为256位。这是因为ECDSA密钥通常使用256位长度,这提供了足够的安全性,同时保持了良好的性能。
  • 你也可以向上面RSA一样加一个注释,这是可选的。

其余步骤一样。

3. ED25519

1
ssh-keygen -t ed25519
  • -t ed25519指定了密钥类型为ED25519。

  • 为什么没有指定密匙长度?Ed25519是一种公钥加密算法,它使用的是Edwards曲线数字签名算法(EdDSA)。Ed25519的设计者已经为它选择了一个特定的曲线(edwards25519),并且已经设定了一个固定的密钥长度(256位)。这是因为Ed25519的设计目标之一就是提供一种既安全又高效的加密算法,而256位的密钥长度在安全性和效率之间提供了一个很好的平衡。

    因此,当你使用ssh-keygen生成Ed25519密钥对时,不需要(也不能)指定密钥长度。

  • 注释是可选的。

其余步骤一样。

部署公钥?

登录服务器,然后把之前生成的公钥(默认是在~/.ssh/下一个后缀为.pub的一个文件中,比如你是用的RSA,就是id_rsa.pub,如果是ED25519就是id_ed25519.pub,用记事本打开)复制到服务器的~/.ssh/authorized_keys中,如果没有则需要自己创建。

玩了这么久Hexo(也就两个月),从刚入行时的GitHub Pages,再到NetLify,Vercel甚至CloudFarePages各种免费托管平台,为了追求速度到阿里云OSS,腾讯云COS,各种对象存储,再到内网穿透,内网建站Frp之类,或者说,如果你有一台服务器的话,直接在Nginx上部署,然后你就会发现,免费的是最贵的,更划算的方案是花一点小钱,才能实现令人满意的效果。

就我个人经验而谈,最佳方案有两种:

  1. 如果没有服务器,那就对象存储
  2. Nginx服务器

在这基础上,有条件的套一层CDN,也不用大费周折搞什么图床(这两种方案之下整图床都是负优化),图片直接放在博客的source目录下即可(新建一个图片目录)。因为对于一般的个人博客,你的博客从一开始写到你放弃这个博客,你的图片也很难占用一个很大的空间,感觉10GB的空间都很富足了。如果你就是分享照片或者视频的网站当我没说。

那本文就将详细讲一下怎么把Hexo博客推送到Nginx服务器。

从本地Hexo到服务器有多种部署协议,如 SCP、FTP 或 Git,因为我们一开始大部分都是通过Git部署到Github,但是我们或多或少都遇到过因为网络问题而推送失败,真的很烦,有时候换几次网也不行,所以我一直对Git推送这种方式耿耿于怀。

今天介绍的这种方式还是基于Git,只不过是推送到自己的服务器,基本不存在网络问题,这就很舒畅。

我们都知道Nginx服务器存放静态网页的目录在/usr/share/nginx/html/下,在这下面你创建一个文件夹,存放你的public文件夹,然后在/etc/nginx/conf.d/下设置一个配置文件,这样就可以通过ip加端口或者域名来访问你的网站。

所以,可以直接推送到/usr/share/nginx/html/下吗?

可行,但是比较复杂。

因为我们要通过Git推送,就必须保证推送地址本身是个仓库,我们需要将其初始化为一个裸仓库或者非裸仓库。

(在 Git 中,仓库可以是裸仓库(bare repository)或非裸仓库(non-bare repository)。

非裸仓库是我们通常使用的仓库类型,它包含一个 .git 目录和工作目录。.git 目录包含了所有的版本控制信息,包括提交历史、分支、标签等。工作目录则包含了你的项目文件,你可以在这里编辑文件、查看文件的状态、进行提交等。

裸仓库只包含版本控制信息,没有工作目录。这意味着你不能在裸仓库中直接编辑文件或查看文件的状态。裸仓库通常用作远程仓库,例如在 GitHub 或 GitLab 上托管的仓库就是裸仓库。

总的来说,非裸仓库是你在本地进行开发时使用的仓库,它包含了工作目录,你可以在这里编辑文件、进行提交等。裸仓库通常用作远程仓库,用于存储版本控制信息,而不用于直接编辑文件。)

如果初始化为一个裸仓库,我们推送完成之后,看不到工作目录,也就看不到public文件夹,也就是目的地址并不能直接当作Nginx的HTML目录。

一个裸仓库的文件大概如下:

image-20240115004434153

(我找半天也没找到我的静态文件目录)

如果推送到一个非裸仓库,里面默认包含工作树,当你试图推送到这个仓库的当前分支时,Git 会拒绝,因为这会使索引和工作树与你推送的内容不一致。

在本地推送时,你大概会遇到这种报错:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
On branch master
nothing to commit, working tree clean
Enumerating objects: 710, done.
Counting objects: 100% (710/710), done.
Delta compression using up to 16 threads
Compressing objects: 100% (326/326), done.
Writing objects: 100% (550/550), 148.70 KiB | 1.33 MiB/s, done.
Total 550 (delta 285), reused 4 (delta 2), pack-reused 0
remote: error: refusing to update checked out branch: refs/heads/master
remote: error: By default, updating the current branch in a non-bare repository
remote: error: is denied, because it will make the index and work tree inconsistent
remote: error: with what you pushed, and will require 'git reset --hard' to match
remote: error: the work tree to HEAD.
remote: error:
remote: error: You can set 'receive.denyCurrentBranch' configuration variable to
remote: error: 'ignore' or 'warn' in the remote repository to allow pushing into
remote: error: its current branch; however, this is not recommended unless you
remote: error: arranged to update its work tree to match what you pushed in some
remote: error: other way.
remote: error:
remote: error: To squelch this message and still keep the default behaviour, set
remote: error: 'receive.denyCurrentBranch' configuration variable to 'refuse'.

然而,如果你仍然想要这样做,你可以在服务器上的仓库中设置 receive.denyCurrentBranch 配置变量为 ignore。这将允许你直接推送到当前分支,但你需要自己确保工作树与你推送的内容保持一致。你可以使用以下命令:

1
git config receive.denyCurrentBranch ignore

然后,你可以直接推送到你的服务器上的仓库。但是,你需要在每次推送后,手动在服务器上更新工作树,以使其与你推送的内容一致。你可以使用以下命令:

1
git reset --hard

请注意,这种方法有风险,因为如果你在服务器上的工作树中有未提交的更改,git reset --hard 命令会丢弃这些更改。

所以最佳的方案应该是:裸仓库和钩子

在服务器上创建一个裸仓库(bare repository)。裸仓库不包含工作树,只包含Git的内部数据,因此你可以安全地推送到它。然后,你可以在服务器上设置一个钩子(hook),当你推送到裸仓库时,钩子会将你的博客静态文件复制到你的网站目录。

以下是在服务器上创建裸仓库和设置钩子的步骤:

  1. 在服务器上,创建一个新的裸仓库:
1
2
3
mkdir /path/to/your/bare/repo.git
cd /path/to/your/bare/repo.git
git init --bare

/path/to/your/bare/repo.git是你裸仓库的地址。

  1. 在裸仓库的 hooks 目录下,创建一个名为 post-receive 的文件,这将是你的钩子:
1
nano hooks/post-receive
  1. 在 post-receive 文件中,添加以下内容:
1
2
3
4
5
6
#!/bin/sh
DIR=yourhtml
if [ ! -d "$DIR" ]; then
mkdir -p "$DIR"
fi
GIT_WORK_TREE=$DIR git checkout -f

将yourhtml换成你想在nginx中存放静态文件的目录,即你的网站目录,如果你就是用nginx,这个目录应该是usr/share/nginx/html/yourwebsite,如果你用1panel中的openresty,这个目录应该是/opt/1panel/apps/openresty/openresty/www/sites/your-website-name/index/yourwebsite,或者你用其他面板,自行寻找下网站在反代软件下的目录,很简单。

这将会在你推送到裸仓库时,将你的博客静态文件复制到你的网站目录。

  1. 保存并关闭文件,然后使其可执行:
1
chmod +x hooks/post-receive

然后,你可以在本地的 Hexo 博客的 public 目录中,将你的服务器的裸仓库添加为一个远程仓库,然后将你的博客静态文件推送到裸仓库。(这个只是单次部署的一个流程,如果你想每次都用hexo d这个命令自动部署,可以跳过这个步骤,直接看下面的)你可以使用以下命令:

1
2
3
4
5
cd public
git remote add origin root@your_server:/path/to/your/bare/repo.git
git add .
git commit -m "Deploy my blog"
git push -u origin master

在这些命令中,root 是你的服务器用户名,your_server 是你的服务器地址,/path/to/your/bare/repo.git 是你在服务器上创建的裸仓库的路径。

然后,你可以在 Hexo 的配置文件 _config.yml 中设置部署命令,以便在运行 hexo d 命令时自动部署你的博客。你可以添加以下内容:

1
2
3
4
deploy:
type: git
repo: root@your_server:/path/to/your/bare/repo.git
branch: master

在这个配置中,root 是你的服务器用户名,your_server 是你的服务器地址,/path/to/your/bare/repo.git 是你在服务器上创建的裸仓库的路径。(当然你要提前设置好ssh免密登录)

然后,你可以运行 hexo d 命令来部署你的博客。这将会自动运行 git 命令,将你的博客静态文件推送到你的服务器上的裸仓库,然后钩子会将文件复制到你的网站目录。

最后,还有一个问题,既然我能把博客推送到一个裸仓库,那我为什么就找不到我博客的目录结构呢?

在Git 裸仓库中,你的博客文件实际上被存储在Git的内部数据结构中,这些数据结构包括blobs(用于存储文件数据)、trees(用于存储目录结构)和commits(用于存储历史记录)。这些数据结构被存储在裸仓库的 .git/objects 目录下。然而,这些数据是以 Git 的内部格式存储的,因此你不能直接在文件系统中看到你的博客的文件结构。

目录

实训简介

搭建一主两从k8s集群并部署MySQL(可用docker搭建MySQL),构建Python爬虫镜像,定时爬取网页内容并持久化到数据库,把镜像推送到阿里云镜像仓库。

1. MySQL数据库安装

k8s部署MySQL

1. 搭建一主两从k8s集群

1. 服务器配置

需要三台服务器,ip在同一网段,使其可以互相通信,三台服务器可以连接外网,配置不能太低,要满足docker运行要求,建议2核2g,硬盘20g即可,本次实训用的镜像是CentOS 7.9。

类似于这种:

img

2. 准备工作

下面这些操作,三台机器都要执行!

关闭防火墙
1
2
systemctl stop firewalld
systemctl disable firewalld
关闭SELinux
1
2
3
4
# 永久关闭
sed -i 's/enforcing/disabled/' /etc/selinux/config
# 临时关闭
setenforce 0
关闭Swap
1
2
3
4
# 永久关闭
vim /etc/fstab
# 临时关闭
swapoff -a

永久关闭的时候需要注释这一行(带swap)

image-20231220212508717

设置主机名
  • 192.168.154.130: hostnamectl set-hostname k8s-master
  • 192.168.154.131: hostnamectl set-hostname k8s-node1
  • 192.168.154.132: hostnamectl set-hostname k8s-node2

设置完成后:

1
2
3
4
5
6
7
8
9
#192.168.154.130
[root@localhost log]# hostname
k8s-master
#192.168.154.131
[root@localhost log]# hostname
k8s-node1
#192.168.154.130
[root@localhost log]# hostname
k8s-node2
修改host文件
1
2
3
4
5
cat >> /etc/hosts << EOF
192.168.154.130 k8s-master
192.168.154.131 k8s-node1
192.168.154.132 k8s-node2
EOF
将桥接的 IPv4 流量传递到 iptables
1
2
3
4
cat > /etc/sysctl.d/k8s.conf << EOF
net.bridge.bridge-nf-call-ip6tables = 1
net.bridge.bridge-nf-call-iptables = 1
EOF

使其生效:

1
sysctl --system
同步时间
1
2
yum install ntpdate -y
ntpdate time.windows.com

3. 开始安装Kubernetes

三台服务器都需要完成以下配置

安装docker

每台电脑都需要安装docker,可执行一下脚本:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
#!/bin/bash
sudo yum remove docker \
docker-client \
docker-client-latest \
docker-common \
docker-latest \
docker-latest-logrotate \
docker-logrotate \
docker-engine
sudo yum install -y yum-utils
sudo yum-config-manager \
--add-repo \
https://download.docker.com/linux/centos/docker-ce.repo
sudo yum install -y docker-ce docker-ce-cli containerd.io
sudo systemctl start docker
sudo systemctl enable docker

以上脚本执行完之后docker就安装好了

docker

复制以下代码:

image-20231220214325578

然后在中括号下面加上一行代码:

1
"exec-opts": ["native.cgroupdriver=systemd"]

添加完成后:

1
2
3
4
5
6
7
8
9
sudo mkdir -p /etc/docker
sudo tee /etc/docker/daemon.json <<-'EOF'
{
"registry-mirrors": ["https://xxxxx.mirror.aliyuncs.com"],
"exec-opts": ["native.cgroupdriver=systemd"]
}
EOF
sudo systemctl daemon-reload
sudo systemctl restart docker
添加K8S的yum源

执行以下代码:

1
2
3
4
5
6
7
8
9
10
cat > /etc/yum.repos.d/kubernetes.repo << EOF
[kubernetes]
name=Kubernetes
baseurl=https://mirrors.aliyun.com/kubernetes/yum/repos/kubernetes-el7-x86_64
enabled=1
gpgcheck=0
repo_gpgcheck=0
gpgkey=https://mirrors.aliyun.com/kubernetes/yum/doc/yum-key.gpg
https://mirrors.aliyun.com/kubernetes/yum/doc/rpm-package-key.gpg
EOF
安装 kubelet、kubeadm 和 kubectl

通过以下命令安装:

1
2
yum install -y kubelet-1.23.6 kubeadm-1.23.6 kubectl-1.23.6
systemctl enable kubelet

4. Kubernetes,启动!

启动master

查看版本:

1
kubeadm version

如图:

image-20231220215728473

然后执行命令启动:

1
2
3
4
5
6
kubeadm init \
--apiserver-advertise-address=192.168.154.130 \
--image-repository registry.aliyuncs.com/google_containers \
--kubernetes-version v1.23.6 \
--service-cidr=10.96.0.0/12 \
--pod-network-cidr=10.244.0.0/16

注意 --apiserver-advertise-address=192.168.154.130 后面的IP地址需要改成自己mater的IP,然后 --kubernetes-version v1.23.6 的版本注意改成自己K8S的版本。

获取启动信息

查看启动成功的信息

image-20231220222053749

本机执行这些命令(以上面截图的为准):

1
2
3
mkdir -p $HOME/.kube
sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config
sudo chown $(id -u):$(id -g) $HOME/.kube/config
启动两个Slave(node节点执行)

还记得上面需要记录下来的命令吗,就是这行:

1
2
kubeadm join 192.168.154.130:6443 --token 7vdvuj.5kvyhzz3ks3tspuy \
--discovery-token-ca-cert-hash sha256:931aeb772e89b669e2eed1405edbe269a7801d133b63a440cd0efba3b7dbad95

执行它,查看结果:

image-20231220222935591

为 master 安装网络插件

我们在master中执行这一行命令:

1
kubectl get nodes

查看结果:

image-20231220223222109

可以看到两个node成功注册,但是没能达到准备状态,因为 STATUS 仍然是 NotReady 状态,我们需要为 master 安装网络插件:

1
kubectl apply -f https://raw.githubusercontent.com/coreos/flannel/master/Documentation/kube-flannel.yml

看到这个代表安装成功(如果没有安装成功,那么需要将文件下载下来,然后将url替换成下载下来的文件):

image-20231220223413034

但是还需要等一下,因为他正在联网下载依赖呢,然后再次查看,就变为 Ready 状态了:

image-20231220231354683

我这个node1节点有问题,我找了许久还是报错,最后我放弃了,因为一个节点不影响MySQL的部署,我还是决定先继续做实验,回头重新安装k8s试试,应该是漏了某个步骤,而正常的应该是这种:

img

如果如上图所示,那你的一主两从集群就部署成功了,中间会遇到各种各样的报错,你可以选择执行某些命令时忽略这些错误项,但是还有一些问题是需要自己解决的。


参考:CentOS7上搭建Kubernetes(K8S)集群并部署nginx(kubeadm方式)_k8s高可用 centos+nginx+kubeadm-CSDN博客

2. 在集群上部署MySQL

1. 创建namespace,把mysql部署在单独的名称空间中

1
kubectl create namespace dev

2. 创建持久卷PV,用来存储mysql数据文件

1. 定义一个容量大小为1GB的PV,挂载到/nfs/data/01目录
1
mkdir -p /nfs/data/01
2. 编写mysql-pv.yaml文件内容,要创建的pv对象名称:pv-1gi
1
2
3
4
5
6
7
8
9
10
11
12
13
apiVersion: v1
kind: PersistentVolume
metadata:
name: pv-1gi
spec:
capacity:
storage: 1Gi
accessModes:
- ReadWriteMany
storageClassName: nfs
nfs:
path: /nfs/data/01
server: 192.168.154.130
3. 创建该PV对象
1
kubectl create -f mysql-pv.yaml
4. 查看创建结果
1
2
kubectl get pv
kubectl describe pv pv-1gi

如图:

屏幕截图 2023-12-20 182529

image-20231220234114072

3. 创建持久卷声明PVC

1. 创建持久卷声明PVC

编写mysql-pvc.yaml文件内容,要创建的pvc对象名称是:mysql-pvc

1
2
3
4
5
6
7
8
9
10
11
12
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
name: mysql-pvc
namespace: dev
spec:
accessModes:
- ReadWriteMany
resources:
requests:
storage: 1Gi
storageClassName: nfs
2. 创建该PVC对象
1
kubectl create -f mysql-pvc.yaml
3. 查看创建结果
1
kubectl get pvc -n dev

可以看到mysql-pvc对象已经和pv-1gi对象绑定上了:

屏幕截图 2023-12-20 182758

4. 创建Secret对象用来保存mysql的root用户密码

1. 设置密码为123456,执行创建命令
1
kubectl create secret generic mysql-root-password --from-literal=password=123456 -n dev
2. 查看创建结果
1
2
kubectl get secret -n dev
kubectl get secret mysql-root-password -n dev -o yaml

屏幕截图 2023-12-20 182855

屏幕截图 2023-12-20 182919

5. 创建service

1. 编辑mysql-svc.yaml文件内容
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
apiVersion: apps/v1
kind: Deployment
metadata:
labels:
app: mysql
name: mysql
namespace: dev
spec:
selector:
matchLabels:
app: mysql
template:
metadata:
labels:
app: mysql
spec:
containers:
- image: mysql:8.0
name: mysql
env:
- name: MYSQL_ROOT_PASSWORD
valueFrom:
secretKeyRef:
name: mysql-root-password
key: password
ports:
- containerPort: 3306
---
apiVersion: v1
kind: Service
metadata:
labels:
app: svc-mysql
name: svc-mysql
namespace: dev
spec:
selector:
app: mysql
type: NodePort
ports:
- port: 3306
protocol: TCP
targetPort: 3306
nodePort: 31233

service使用NodePort类型,指定暴露的nodePort端口为31233,我们会在宿主机使用navicat客户端对mysql进行访问。

2. 执行创建命令
1
kubectl create -f mysql-svc.yaml
3. 查看创建结果
1
kubectl get pod,svc -n dev

屏幕截图 2023-12-20 183128

docker部署MySQL

1
docker run --name mysql -e MYSQL_ROOT_PASSWORD=123456 -p 3306:3306 -d mysql

2. MySQL数据库设置远程登录

k8s进入MySQL容器内部

1
kubectl exec -it mysql-657494c4df-thlqf  /bin/bash -n dev

其中mysql-657494c4df-thlqf是mysql数据库所在pod的pod名称。

docker进入MySQL容器内部

1
docker exec -it 容器名or容器id /bin/bash

配置root用户远程可连接

1
2
ALTER USER root@localhost IDENTIFIED WITH mysql_native_password BY '123456';
ALTER USER root@'%' IDENTIFIED WITH mysql_native_password BY '123456'

创建mydb库并授权给root用户

1
2
3
4
create database mydb;

grant all privileges on mydb.* to 'root'@'%';
flush privileges;

3. 用navicat连接数据库并完成建表

连接k8s下的MySQL数据库

并建表,插入一条测试数据:

1
2
create table test0918(col1 varchar(100));
insert into test0918 values('aaa');

然后新建一个后续实验用到的表:

1
2
3
4
5
6
7
8
9
CREATE TABLE product_info(
product_name varchar (1000)
, supplier varchar (1000)
, supplier_web varchar (1000)
, product_desc varchar (1000)
,product_img varchar (1000)
, product_price varchar (1000)
, addr varchar (1000)
, mailing_ins varchar (1000))

屏幕截图 2023-12-18 024723

(此处找不到原图了,只得先用一张docker最终实验测试成功的截图)

连接docker下的MySQL数据库

建表语句同上

image-20231221002309917

4. 制作dockerfile并创建镜像,运行容器

镜像中需要包含python环境,并且包含爬虫的数据解析包,并包含脚本的自动调度命令。

1. 创建定时任务的Dockerfile

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
# 使用阿里云的CentOS 7镜像作为基础镜像
FROM centos:7

# 配置阿里云的yum源
RUN curl -o /etc/yum.repos.d/CentOS-Base.repo https://mirrors.aliyun.com/repo/Centos-7.repo
RUN curl -o /etc/yum.repos.d/epel.repo https://mirrors.aliyun.com/repo/epel-7.repo
RUN yum makecache fast

# 安装cronie和更新系统
RUN yum -y install cronie.x86_64 && \
yum -y update

# 安装Python开发相关的工具
RUN yum install python3-devel python3-pip -y

# 安装Python依赖包,注意将 "pip3 install urllib" 替换为 "pip3 install urllib3"
RUN pip3 install -i https://pypi.douban.com/simple pymysql urllib3 beautifulsoup4

# 复制脚本和Python文件到容器内
COPY ./script.sh /script.sh
COPY ./mysql.py /mysql.py

# 添加执行权限
RUN chmod +x /script.sh
RUN chmod +x /mysql.py

# 设置定时任务
CMD crond -n

2. 编写script.sh和mysql.py

script.sh:

1
python3 /mysql.py >> /var/log/cron.log 2>&1

mysql.py:

注意mysql.py中的数据库端口,这里docker中和k8s中并不一样

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
#!/usr/bin/env python
# coding: utf-8

# In[1]:

import urllib.request
from time import sleep
from bs4 import BeautifulSoup as bs
from urllib.parse import urljoin
import pymysql

# In[2]:

headers = {
'User-Agent': 'Mozilla/6.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/61.0.3163.100 Safari/537.36'
}

# In[3]:

def get_info(page):
url='https://www.cnhnb.com/p/mianfen-0-0-0-0-{}/'.format(page)
req = urllib.request.Request(url, headers=headers)
html = urllib.request.urlopen(req)
soup = bs(html.read(), 'html.parser')
lu = soup.find_all('div',class_='show-ctn')
product_all=[]
for i in lu:
product_name=i.find('h2').get_text()#产品名称
supplier=i.find("a").get_text()#供应商
supplier_web=i.find("a").attrs['href']#供应商网址
product_desc=i.find('div',class_='shop-image').img.attrs['alt']#产品介绍
product_img=i.find('div',class_='shop-image').img.attrs['src']#产品图片
product_price=str(i.find('div',class_='shops-price').get_text()).strip().replace('\n','').replace(' ','')#产品价格
addr=str(i.find('div',class_='r-shop-btm').get_text())#发货地
mailing_ins=str(i.find('div',class_='cw-tags').get_text()).strip().replace('\n','').replace(' ','')#邮寄说明
product=[product_name,supplier,supplier_web,product_desc,product_img,product_price,addr,mailing_ins]
product_all.append(product)
return product_all

# In[12]:

def save_mysql(all_data):
conn = pymysql.connect(host='192.168.154.130', user='root', port=31233, password='123456', db='mydb', charset='utf8')
# 注意不要忘记换host
curson = conn.cursor()
# 创建表sql语句
#ctablesql = 'CREATE TABLE product_info(product_name varchar (1000), supplier varchar (1000), supplier_web varchar (1000), product_desc varchar (1000),product_img varchar (1000), product_price varchar (1000), addr varchar (1000), mailing_ins varchar (1000))'
#curson.execute(ctablesql)
# 插入数据SQL语句
insertsql = 'insert into product_info(product_name,supplier,supplier_web,product_desc,product_img,product_price,addr,mailing_ins) value (%s,%s,%s,%s,%s,%s,%s,%s)'
for data in all_data:
data = tuple(data)
curson.execute(insertsql, data)
conn.commit()

# In[13]:

if __name__ == '__main__':
for i in range(1,89):
all_data=get_info(i)
save_mysql(all_data)

# In[ ]:

3. 利用Dockerfile创建镜像

1
docker build -t docker-crond .

屏幕截图 2023-12-18 024855

4. 运行并进入容器内部,配置定时任务(若crond 未启动,直接运行此命令)

1
2
3
docker run -it docker-crond /bin/bash
crond
crontab -e

添加如下内容:

1
*/5 * * * * /script.sh >> /var/log/cron.log 2>&1

2>&1是一个重定向操作符,用于将标准错误(文件描述符2)重定向到标准输出(文件描述符1)

验证:

1
crontab -l

屏幕截图 2023-12-18 024800

5. 查看数据库结果

脚本运行起来之后,就可以通过navicat查看数据了,脚本调度调度失败,相关的失败日志信息就会写入到/var/log/cron.log中。

k8s数据库结果:

image-20231221004706038

docker数据库结果:

屏幕截图 2023-12-20 191548

5. 构建镜像并推送到阿里云镜像仓库

1. 构建镜像

先停止容器,停止前记住容器id:

1
2
docker ps
docker stop 容器id

屏幕截图 2023-12-18 024628

1
docker commit 容器id 镜像名:版本号

屏幕截图 2023-12-18 024613

2. 推送到阿里云镜像仓库

1. 准备工作

1. 找到阿里云容器镜像服务ACR,并打开控制台:

image-20231221005222487

2. 找到个人实例,先创建命名空间:

image-20231221005513145

3. 在该命名空间下创建一个镜像仓库my-docker-crond,注意地域:

image-20231221100311796

剩下的根据操作指南操作。

2. 登录阿里云Docker Registry

image-20231221011604426

image-20231221011719764

3. tagandpush

image-20231221100619023

屏幕截图 2023-12-18 024508

4. 仓库验证

image-20231221100517948

实训总结

这次实训的重点在于搭建一主两从k8s集群,中间我遇到了各种各样的错误,我还是不能找到一个百分百搭建成功的方法,说实话,有点挫败感,不过我依然从中学到了很多知识,了解了k8s的基本架构,更重要的是,我锻炼了解决实际问题的能力。

从昨天开始,我已经注意到了我的博客图标显示有问题,我以为是浏览器的问题,就没多理会,然后我发现我朋友的博客也出现了这个问题,我问他他那边显示有问题不,他说有,然后我才想着解决这个问题。

就像这样:

image-20231214012548193

image-20231214012602349

所有关于fontawesome的图标都沦陷了。

一开始,我以为是从url引入的fontawesome包有网络问题,但是我单独打开这个url是可以直接打开的(https://cdn.staticfile.org/font-awesome/6.4.2/css/all.min.css)这也是主题作者用的包,位于layout文件夹下的import.ejs文件中的前几行。

后来我又了解到要想使fontawesome的all.min.css能正常加载,正常显示图标,必须得引入对应包下的fonts文件夹,我转而想到,有可能是作者cdn中的webfonts包不能正常加载。

我第一个想到的办法是:

将整个fontawesome包放在博客仓库下。

这很简单,这样解决:

  1. 从fontawesome官网下载对应的web包。(6.5.1)

  2. 修改一下文件名fontawesome6.5.1,复制到到博客主题下的source目录。

  3. 打开主题目录下的layout文件夹,修改其中的import.ejs文件,找到第三行:

    1
    <link rel="stylesheet" href="https://cdn.staticfile.org/font-awesome/6.4.2/css/all.min.css" />

    修改为:

    1
    <link rel="stylesheet" href="/fontawesome6.5.1/css/all.min.css" />

    这将从博客的根目录下查找这个文件,因为放到source文件夹下的文件,被渲染后将放在博客仓库的根目录下。

  4. hexo g,hexo d。

但是我很快发现了这样解决的问题,从根目录下搜寻文件很浪费性能,导致加载速度很慢,直接的结果就是,我的博客加载速度长了一两秒。

这我肯定是不能满意的,于是我想到像图床一样,在netlify再建一个仓库,将fontawesome包放进去,然后通过url引入到我的博客中。

可是我遇到了很奇怪的事情,我试了很多次,最后还是加载异常,我甚至很玄学的把all.min.css文件放在二级目录下,因为作者的url就是这样的结构,但还是不行,我测试了我这个仓库的全国延迟:

image-20231214020926885

我把图标显示异常的原因归结于netlify的不给力,但是我单独在浏览器中访问该仓库的url,是能够正常显示all.min.css的内容的,我还检查了all.min.css的最后几行引入webfonts的代码(这是压缩过的,显得很拥挤):

1
font-display:block;src:url(../webfonts/fa-regular-400.woff2) format("woff2"),url(../webfonts/fa-regular-400.ttf) format("truetype")}.fa-regular,.far{font-weight:400}:host,:root{--fa-style-family-classic:"Font Awesome 6 Free";--fa-font-solid:normal 900 1em/1 "Font Awesome 6 Free"}@font-face{font-family:"Font Awesome 6 Free";font-style:normal;font-weight:900;font-display:block;src:url(../webfonts/fa-solid-900.woff2) format("woff2"),url(../webfonts/fa-solid-900.ttf) format("truetype")}.fa-solid,.fas{font-weight:900}@font-face{font-family:"Font Awesome 5 Brands";font-display:block;font-weight:400;src:url(../webfonts/fa-brands-400.woff2) format("woff2"),url(../webfonts/fa-brands-400.ttf) format("truetype")}@font-face{font-family:"Font Awesome 5 Free";font-display:block;font-weight:900;src:url(../webfonts/fa-solid-900.woff2) format("woff2"),url(../webfonts/fa-solid-900.ttf) format("truetype")}@font-face{font-family:"Font Awesome 5 Free";font-display:block;font-weight:400;src:url(../webfonts/fa-regular-400.woff2) format("woff2"),url(../webfonts/fa-regular-400.ttf) format("truetype")}@font-face{font-family:"FontAwesome";font-display:block;src:url(../webfonts/fa-solid-900.woff2) format("woff2"),url(../webfonts/fa-solid-900.ttf) format("truetype")}@font-face{font-family:"FontAwesome";font-display:block;src:url(../webfonts/fa-brands-400.woff2) format("woff2"),url(../webfonts/fa-brands-400.ttf) format("truetype")}@font-face{font-family:"FontAwesome";font-display:block;src:url(../webfonts/fa-regular-400.woff2) format("woff2"),url(../webfonts/fa-regular-400.ttf) format("truetype");unicode-range:u+f003,u+f006,u+f014,u+f016-f017,u+f01a-f01b,u+f01d,u+f022,u+f03e,u+f044,u+f046,u+f05c-f05d,u+f06e,u+f070,u+f087-f088,u+f08a,u+f094,u+f096-f097,u+f09d,u+f0a0,u+f0a2,u+f0a4-f0a7,u+f0c5,u+f0c7,u+f0e5-f0e6,u+f0eb,u+f0f6-f0f8,u+f10c,u+f114-f115,u+f118-f11a,u+f11c-f11d,u+f133,u+f147,u+f14e,u+f150-f152,u+f185-f186,u+f18e,u+f190-f192,u+f196,u+f1c1-f1c9,u+f1d9,u+f1db,u+f1e3,u+f1ea,u+f1f7,u+f1f9,u+f20a,u+f247-f248,u+f24a,u+f24d,u+f255-f25b,u+f25d,u+f271-f274,u+f278,u+f27b,u+f28c,u+f28e,u+f29c,u+f2b5,u+f2b7,u+f2ba,u+f2bc,u+f2be,u+f2c0-f2c1,u+f2c3,u+f2d0,u+f2d2,u+f2d4,u+f2dc}@font-face{font-family:"FontAwesome";font-display:block;src:url(../webfonts/fa-v4compatibility.woff2) format("woff2"),url(../webfonts/fa-v4compatibility.ttf)

但是是没有问题的,都是通过相对路径的方式../webfonts,只要我正常引入整个fontawesome包,肯定是不影响webfonts的引入的,这让我很头大,我只能把问题归结于网络。

于是,我尝试了理论上不存在网络问题的阿里云OSS,我把fontawesome放入一个bucket中,还绑了一个域名,甚至把权限改为了公共读写,但是问题依然没有得到解决,于是,我暂时放弃了这个方法。

我想到了另外一种方法:

使用其他cdn下的fontawesome。

全国延迟测试:

image-20231214022423788

全国延迟测试:

image-20231214022656656

感觉差不多,但是距离原作者的cdn:

image-20231214022849194

还是差距有点大。

我是不满意的,但是没办法,我还是对自建仓库的方案耿耿于怀,为啥不能正常加载?

我突然想到可以查看一下浏览器控制台的输出,有什么报错。(我之前一直没有看浏览器后台的习惯!!!)

然后我发现了新大陆:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
Access to font at 'https://cdn.staticfile.org/font-awesome/6.4.2/webfonts/fa-solid-900.woff2' from origin 'http://localhost:4000' has been blocked by CORS policy: The 'Access-Control-Allow-Origin' header has a value 'https://www.pil0txia.com' that is not equal to the supplied origin.
fa-solid-900.woff2:1 Failed to load resource: net::ERR_FAILED
localhost/:1 Access to font at 'https://cdn.staticfile.org/font-awesome/6.4.2/webfonts/fa-brands-400.woff2' from origin 'http://localhost:4000' has been blocked by CORS policy: The 'Access-Control-Allow-Origin' header has a value 'https://www.mikuclub.win' that is not equal to the supplied origin.
fa-brands-400.woff2:1 Failed to load resource: net::ERR_FAILED
VM25:1 [Deprecation] 'window.webkitStorageInfo' is deprecated. Please use 'navigator.webkitTemporaryStorage' or 'navigator.webkitPersistentStorage' instead.
V @ VM25:1
fireworks.min.js:1 Uncaught ReferenceError: anime is not defined
at fireworks.min.js:1
localhost/:1 Access to font at 'https://cdn.staticfile.org/font-awesome/6.4.2/webfonts/fa-solid-900.ttf' from origin 'http://localhost:4000' has been blocked by CORS policy: The 'Access-Control-Allow-Origin' header has a value 'https://www.mikuclub.win' that is not equal to the supplied origin.
fa-solid-900.ttf:1 Failed to load resource: net::ERR_FAILED
localhost/:1 Access to font at 'https://cdn.staticfile.org/font-awesome/6.4.2/webfonts/fa-brands-400.ttf' from origin 'http://localhost:4000' has been blocked by CORS policy: The 'Access-Control-Allow-Origin' header has a value 'https://www.mikuclub.win' that is not equal to the supplied origin.
fa-brands-400.ttf:1 Failed to load resource: net::ERR_FAILED
content.js:30 Uncaught DOMException: Failed to execute 'getRangeAt' on 'Selection': 0 is not a valid index.
at HTMLDocument.checkContextMenuInSelection (chrome-extension://hgploeanmefhfpokeenldbnhbnmnlplj/scripts/content.js:30:33)
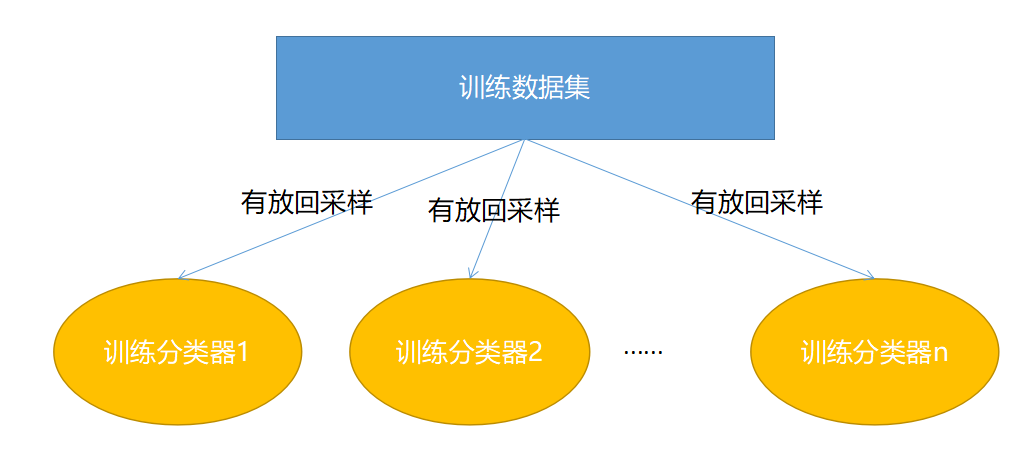
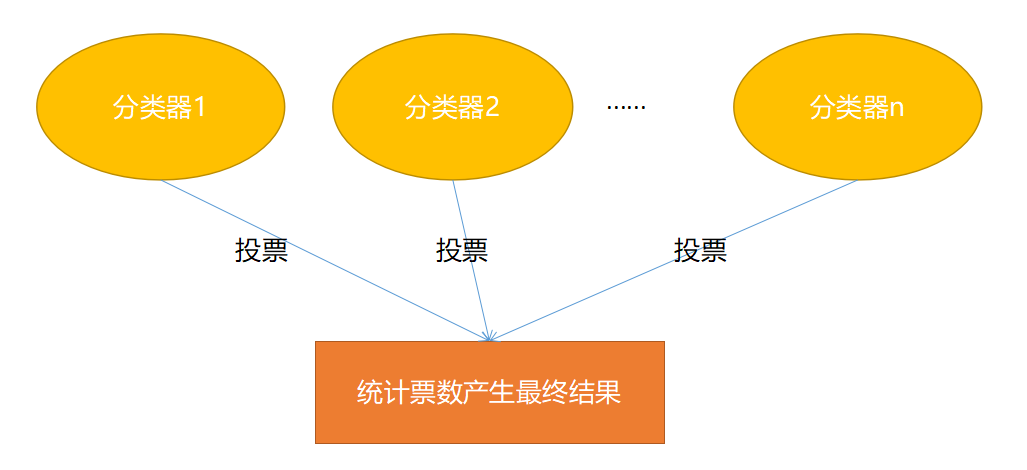
一直频繁出现的一个词CORS,不禁好奇,什么是CORS?

CORS(Cross-Origin Resource Sharing)是一种浏览器安全策略,用于控制在不同源(Origin)之间进行的Web页面间的资源共享。同源策略是一种浏览器安全机制,阻止网页从一个源加载的脚本或资源与来自另一个源的文档进行交互。

CORS通过在HTTP请求和响应头中添加一些额外的信息来允许或拒绝跨域请求。例如,当从一个域的网页尝试请求另一个域的资源时,目标服务器可以通过在响应头中包含正确的 Access-Control-Allow-Origin 值来允许请求,否则浏览器将阻止该请求。

简而言之,CORS允许服务器声明哪些域有权限访问其资源,以增加Web应用程序的安全性。

就是说在我的域名下,访问了不属于我域名下的资源,被浏览器禁止了,那,怎么解决呢?

解决这个问题的方法有两个:

1. 配置CDN服务器支持CORS

如果您有权访问CDN服务器(https://cdn.staticfile.org),您可以在CDN服务器上配置CORS规则,以允许来自特定域的跨域请求。在CDN服务器上的配置文件中添加以下头部:

1
<AccessControlAllowOrigin>你的域名</AccessControlAllowOrigin>

请确保将 <AccessControlAllowOrigin> 的值设置为您的Netlify域名。

2. 使用支持CORS的CDN或其他服务

如果您无法直接配置CDN服务器,可以考虑使用已经配置了CORS的CDN服务,或者使用支持CORS的其他服务。

例如,您可以考虑使用官方的FontAwesome CDN(刚才已经用过):

1
<link rel="stylesheet" href="https://cdnjs.cloudflare.com/ajax/libs/font-awesome/6.4.2/css/all.min.css" integrity="sha512-..." crossorigin="anonymous" />

在这种情况下,crossorigin="anonymous" 表示使用匿名身份验证,而不会发送用户的凭据(例如cookie)。

总的来说,解决问题的关键是确保字体资源的响应头中包含了正确的 Access-Control-Allow-Origin 头部,并且与请求的域名匹配。

但是我显然无法控制原作者的cdn,那怎么办?

1. 使用代理

您可以在自己的服务器上设置一个代理,通过代理来获取字体文件。这个代理服务器可以将来自 https://cdn.staticfile.org 的请求转发到原始服务器,并将响应返回给您的网页。这样,由于请求是从您的域发出的,就避免了浏览器的同源策略和CORS问题。

代理服务器的实现

您可以使用Node.js、Express等构建一个简单的代理服务器。以下是一个基本的示例:

1.安装 Node.js 和 Express(如果尚未安装):

1
npm install express

2.创建一个代理服务器脚本(proxy.js):

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
econst express = require('express');
const { createProxyMiddleware } = require('http-proxy-middleware');

const app = express();

app.use('/font-awesome', createProxyMiddleware({
target: 'https://cdn.staticfile.org',
changeOrigin: true,
pathRewrite: { '^/font-awesome': '/' },
}));

const PORT = 3000;
app.listen(PORT, () => {
console.log(`Proxy server is running on port ${PORT}`);
});

3.运行代理服务器:

1
node proxy.js

4.在您的网页中,将字体文件的请求路径修改为代理服务器的路径:

1
<link rel="stylesheet" href="https://cdn.staticfile.org/font-awesome/6.4.2/css/all.min.css">

修改为:

1
<link rel="stylesheet" href="你的域名/font-awesome/6.4.2/css/all.min.css">

当然我们这里需要修改ejs文件中的url。

2. 使用CORS代理服务

您还可以考虑使用一些提供CORS代理服务的第三方工具。这些服务允许您通过它们的服务器发起请求,然后它们将请求转发给原始服务器,并将响应返回给您的网页。这样,您的网页就可以绕过同源策略和CORS问题。

一些常见的CORS代理服务包括:

在使用这些服务时,请确保了解服务的使用规定,并注意它们的可靠性和安全性。

总体而言,这些方法是绕过同源策略和CORS问题的替代方案。请注意,使用代理可能会导致一些性能和安全方面的考虑,因此请谨慎使用。

那如果我使用自己的仓库呢,不使用cdn呢?

如果您的FontAwesome资源托管在Netlify上,而且您在使用它们的过程中遇到了CORS问题,可以尝试以下方法解决:

1. Netlify配置文件 _headers

在您的Netlify项目的根目录下创建一个名为 _headers 的文件,并添加如下内容:

1
2
mathematica/*
Access-Control-Allow-Origin: *

这将在所有资源的响应中添加 Access-Control-Allow-Origin 头,允许任何域访问资源。请注意,这可能会导致一些安全性问题,因为它允许所有域访问资源。如果安全性是关键问题,请考虑将 * 替换为您允许的域。

2. Netlify Functions

如果您的FontAwesome资源是通过Netlify函数(Netlify Functions)提供的,您可以在函数中设置CORS头。以下是一个示例函数:

1
2
3
4
5
6
7
8
9
10
exports.handler = async function(event, context) {
return {
statusCode: 200,
headers: {
'Access-Control-Allow-Origin': '*',
// Add other necessary headers
},
body: JSON.stringify({ message: 'Hello World' }),
};
};

此函数会返回包含 Access-Control-Allow-Origin 头的响应。确保在您的Netlify函数中添加这个头,以允许跨域访问。

3. Netlify配置文件 netlify.toml

如果您的项目有 netlify.toml 配置文件,您可以尝试在其中添加如下配置:

1
2
3
4
[[headers]]
for = "/*"
[headers.values]
Access-Control-Allow-Origin = "*"

这会设置所有路径的 Access-Control-Allow-Origin 头,允许任何域访问资源。

请注意,这些方法都是基于假设您具有对Netlify项目的足够控制权。如果FontAwesome资源是由其他服务提供的,您可能需要查看该服务的文档或联系其支持团队,以获取关于如何处理CORS问题的更多信息。

我给仓库添加了_headers文件,然后打开了浏览器在本地测试,居然还是显示异常,别沮丧,继续查看控制台:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
VM26:1 [Deprecation] 'window.webkitStorageInfo' is deprecated. Please use 'navigator.webkitTemporaryStorage' or 'navigator.webkitPersistentStorage' instead.
V @ VM26:1
fireworks.min.js:1 Uncaught ReferenceError: anime is not defined
at fireworks.min.js:1
12Failed to decode downloaded font: <URL>
localhost/:1 Failed to decode downloaded font: https://tianapi.netlify.app/fontawesome/fontawesome6.5.1/webfonts/fa-solid-900.woff2
localhost/:1 Failed to decode downloaded font: https://tianapi.netlify.app/fontawesome/fontawesome6.5.1/webfonts/fa-brands-400.woff2
localhost/:1 Failed to decode downloaded font: https://tianapi.netlify.app/fontawesome/fontawesome6.5.1/webfonts/fa-solid-900.ttf
localhost/:1 Failed to decode downloaded font: https://tianapi.netlify.app/fontawesome/fontawesome6.5.1/webfonts/fa-brands-400.ttf
6OTS parsing error: Failed to convert WOFF 2.0 font to SFNT
localhost/:1 OTS parsing error: Failed to convert WOFF 2.0 font to SFNT
localhost/:1 OTS parsing error: cmap: invalid table offset
localhost/:1 OTS parsing error: cmap: table overruns end of file
content.js:30 Uncaught DOMException: Failed to execute 'getRangeAt' on 'Selection': 0 is not a valid index.
at HTMLDocument.checkContextMenuInSelection (chrome-extension://hgploeanmefhfpokeenldbnhbnmnlplj/scripts/content.js:30:33)
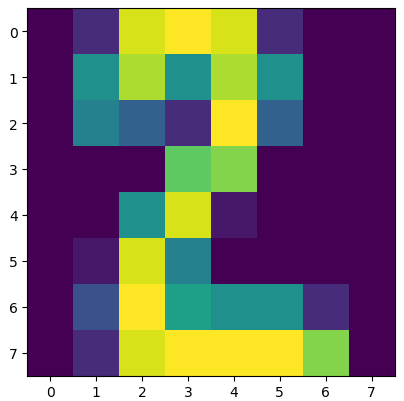
这回报错变了,这个问题通常是由于字体文件的 MIME 类型未正确设置导致的。浏览器在下载字体文件时,会根据其 MIME 类型(例如,application/font-woff2 或 application/x-font-ttf)来解析和呈现字体。如果服务器未正确设置字体文件的 MIME 类型,浏览器可能无法正确解析字体文件,从而导致“Failed to decode downloaded font”错误。

有可能是浏览器的缓存没清理,于是我清理了缓存,终于,成功了!!!!!

ohohohoh!!!

image-20231214030552941

至此,已成艺术,真的很激动,哈哈哈哈。

这次经历让我养成了查看浏览器控制台的习惯,要从问题根源下手。

0%